GLM-4.5: Agentic, Reasoning, and Coding (ARC) Foundation Models 논문정리
논문: GLM-4.5: Agentic, Reasoning, and Coding (ARC) Foundation Models
세미나 발표 자료를 정리한 글입니다. 논문의 핵심인 학습 파이프라인(Pre-training → Mid-training → Post-training → RL)을 중심으로 정리했습니다.
Abstract
- 355B 파라미터와 32B의 활성화 파라미터를 가진 MoE 기반 대규모 언어 모델
- 추론(thinking) 모드와 직접 응답 모드를 모두 지원하는 하이브리드 추론 방식 지원
- 23T 토큰에 대한 multi-stage 학습과 expert model 반복 및 강화학습을 통한 포괄적인 사후 학습
- 여러 경쟁 모델보다 훨씬 적은 파라미터를 사용함에도 불구하고 높은 순위 달성
MoE 기반 355B 모델. 23조 개의 토큰(학습 데이터) 사용
Introduction
논문에서 강조하는 세 가지 역량(ARC)은 다음과 같다.
- Agentic: 외부 도구 및 현실 세계와 상호작용하는 에이전틱 능력
- Reasoning: 수학 및 과학과 같은 분야에서 multi-step으로 문제를 해결하는 복잡한 추론 능력
- Coding: 소프트웨어 엔지니어링 작업을 처리하는 고급 코딩 스킬 능력
모델 구조 관련 특징은 다음과 같다.
- 더 깊은 모델이 더 나은 추론 능력을 보인다는 것을 발견했기 때문에 hidden 차원 및 라우팅 전문가 수를 줄이고 layer를 늘림
- RoPE를 사용하는 GQA(Grouped Query Attention)를 적용. Hidden 차원이 5120개인 경우 어텐션 헤드를 2.5배 더 많이 사용(96개 헤드)
- Attention logit 범위를 안정화하기 위해 QK-Norm 사용
참고 논문
- RoPE: https://arxiv.org/abs/2104.09864
- GQA: https://arxiv.org/abs/2305.13245
- QK-Norm: https://arxiv.org/abs/2010.04245
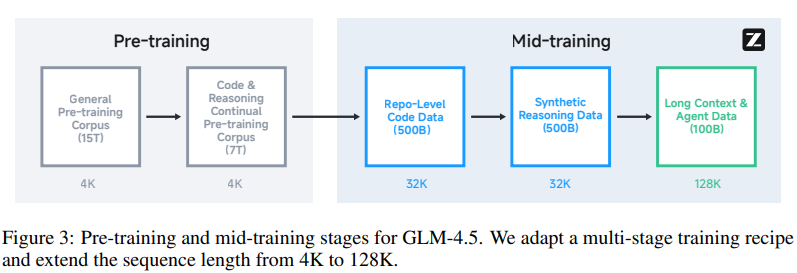
- Multi-stage 학습 적용. 시퀀스 길이는 4K에서 128K로 늘림
- 사전 학습 코퍼스는 웹페이지, 소셜 미디어, 서적, 논문 및 코드 저장소의 문서
- 웹 사전 학습 문서의 대부분은 인터넷에서 크롤링한 영어 및 중국어 웹페이지
Pre-training Data
1. Web
- Nemotron-CC에서 영감을 받아 크롤링한 웹페이지를 품질 점수별로 버킷으로 나눔. 가장 낮은 품질 점수를 받은 버킷의 문서는 제거하고 가장 높은 품질 점수를 받은 버킷은 업샘플링을 진행하여 3.2 에폭 이상 학습시킴
- 중복된 웹페이지는 MinHash 중복 제거로는 제거할 수 없어서, 문서 임베딩을 기반으로 하는 SemDedup 파이프라인을 추가로 적용해서 유사한 웹페이지를 제거함
2. Multilingual
- 사전학습 코퍼스에 다국어 문서 포함
- 다국어 코퍼스는 크롤링한 웹페이지와 Fineweb-2에서 가져와서 품질 분류기를 적용하고 고품질 다국어 문서를 업샘플링
3. Math & Science
- 수학 및 과학 추론 능력을 향상시키기 위해 웹페이지, 서적, 논문 등에서 수학 및 과학 관련 문서를 수집
- LLM으로 일부 샘플의 점수를 뽑고, 그 샘플을 토대로 분류기를 학습시켜서 점수를 매김
- 사전학습 코퍼스에서 특정 threshold 이상의 점수를 받은 문서는 업샘플링됨
4. Code
- GitHub 및 다양한 코드 호스팅 플랫폼에서 데이터 수집
- 코드는 rule-based 필터링을 거친 후, 언어별 품질 모델을 사용하여 샘플을 고/중/저 세 가지 등급으로 분류
- FIM(Fill-In-the-Middle): 코드의 중간 부분을 비워두고 앞부분과 뒷부분을 보여준 뒤 비어있는 중간을 채우게 하는 방식. 자동완성 기능에 유용함
일반 텍스트에서의 코드 전처리 과정
- 1차 선별: HTML 코드 태그가 있거나, FastText가 코드 문서로 분류한 문서 선별
- 2차 평가: 품질 모델로 고/중/저 등급 매기기
- 샘플링: 고품질 업샘플링 및 저품질 데이터 제거
- 재파싱: 정밀 파서로 다시 파싱해서 코드 포맷/내용 보존
FIM 예시는 다음과 같다. 원본 코드에서 중간 부분을 비워둔다.
def calculate_area(radius):
    pi = 3.14159          # Prefix
    area = pi * radius ** 2   # Middle (비워두는 부분)
    return area           # Suffix
학습 시에는 아래처럼 특수 토큰으로 재배열해서 모델이 <MID> 뒤의 내용을 생성하도록 학습한다.
<PRE> def calculate_area(radius): pi = 3.14159 <SUF> return area <MID> area = pi * radius ** 2
PRE, SUF, MID 같은 특수 토큰을 포함시켜 학습함. IDE의 자동완성 같은 기능에 쓰임.
Mid-Training
명령어 데이터를 포함한 중간 규모의 도메인별 데이터셋을 활용한다.
1. Repo-level Code Training
- GitHub에서 모델이 필터링한 이슈, 풀 리퀘스트(PR), 커밋을 포함하며, 관련 이슈/PR/커밋은 하나의 컨텍스트로 연결되고 커밋은 +/- 표시로 보여주는 diff 스타일로 정리해서 학습
- 대규모 저장소를 포함하기 위해 학습 시퀀스를 4K에서 32K로 확장
2. Synthetic Reasoning Data Training
- 수학, 과학, 코딩 경시대회와 관련된 웹페이지 및 서적에서 추론과 관련된 수많은 문제와 답변을 수집하고, 추론 모델을 통해 추론 과정을 합성함
3. Long-context & Agent Training
- Long-context 성능을 올리기 위해 32K에서 128K(131,072)까지 학습 시퀀스를 늘림. Pre-training 코퍼스에서 긴 문서들을 업샘플링함
- 에이전트가 여러 단계를 거쳐 작업을 수행한 기록 같은 데이터도 이 단계에서 통합시킴
- Pre-training 단계에서는 random-truncation을 사용하고, mid-training 단계에서는 자르지 않고 최대한 온전한 형태를 사용
Hyper-Parameters
- Word embedding, bias, RMSNorm 가중치를 제외한 모든 매개변수에 대해 Muon 옵티마이저 적용
- Newton-Schulz iteration steps N=5, 모멘텀 μ=0.95, Muon 업데이트 RMS=0.2
- Muon 옵티마이저가 수렴 속도를 높이고 더 큰 배치 크기를 허용함
- Lr 스케줄러는 cosine decay 스케줄을 사용. Lr은 0에서 2.5e-4까지 warmup을 거치고, 중간 학습이 끝날 때까지 2.5e-5까지 감소하는 단계를 거침
- 배치 크기 웜업 전략을 사용. warmup-stable-decay(WSD) 스케줄은 성능이 저하되고 과소적합이 발생함
- 배치 사이즈는 처음 500B 토큰에 대해서는 16M에서 64M으로 점진적으로 증가시키고, 나머지 학습 기간 동안에는 일정하게 유지
- 정규화는 weight decay를 0.1로 설정하고 드롭아웃은 적용하지 않음
- 최대 시퀀스 길이는 pre-training 동안 4096으로 설정하고 mid-training에서는 32768과 131072로 확장. 32K로 확장할 때 더 나은 long-context 모델링 능력을 위해 RoPE의 기본 빈도(base frequency)를 10,000에서 1,000,000으로 조정
- Expert 하이퍼파라미터
- 15T 토큰까지는 bias update weight를 0.001로 설정하고 나머지 토큰에 대해서는 0.0으로 설정
- Auxiliary sequence-level balance loss는 0.0001로 설정
- Multi-Token Prediction(MTP) loss weight는 15T까지는 0.3으로 설정 후, 나머지에 대해서는 0.1로 설정
Post-training
사후 학습은 크게 두 단계로 나뉜다.
- Expert Training: 추론, 에이전트, 일반 채팅의 세 가지 영역에 특화된 전문가 모델을 구축
- Unified Training: self-distillation 기법을 활용하여 여러 전문가 모델을 통합하고, 최종적으로는 추론과 직접 응답 모드 모두를 통해 응답을 생성할 수 있는 종합적인 모델을 완성
Supervised Fine-Tuning
1단계와 2단계 모두 supervised fine-tuning(SFT)을 수행함.
- 1단계에서 SFT의 주요 역할은 초기 학습을 통해 모델에 기본적인 대화, 추론 및 도구 사용 능력을 부여하는 것
- 2단계에서 SFT는 다양한 전문가 모델의 기능을 하나의 하이브리드 추론형 일반 모델로 통합하여 다양한 유형의 작업을 처리할 수 있도록 함
1단계 SFT: CoT 응답을 포함하는 소규모의 데이터셋을 활용하여 Reasoning, General, Agentic 3개 도메인의 전문가를 각각 학습시킴.
2단계 SFT
- 추론, 일반 대화, 에이전트 및 긴 문맥 이해 과제를 포함하는 수백만 개의 샘플을 기존 학습된 전문가 모델로부터 수집하고, 최대 128K 토큰의 문맥 길이로 베이스 모델을 학습시킴
- 다양한 전문가 모델의 출력을 활용한 지식 증류를 통해 모델은 각 과제에 효과적인 long-text CoT 추론 방식을 적용함
- 하이브리드 모델을 위해 빠른 응답이 요구되는 데이터와 상세한 추론 과정을 포함한 데이터를 균형 맞춰 학습함
- 2단계 SFT를 위한 데이터 준비 과정에서 아래의 몇 가지 전략을 사용
Technique 1. Reducing Character Escaping in Function Call Templates
함수 호출 매개변수는 주로 JSON 형식으로 표현되지만, 이러한 매개변수에 코드가 포함될 경우 상당 부분이 이스케이프 처리가 필요해서 모델의 학습 부담을 증가시킴.
- 줄바꿈 →
\n, 따옴표 →\", 백슬래시 →\\등 이스케이프가 중첩되면서 모델이 실수하기 쉬워짐
JSON 형식의 함수 호출 예시. 코드 안의 줄바꿈과 따옴표가 전부 이스케이프되어 있다.
{
  "name": "write_file",
  "arguments": {
    "filename": "hello.py",
    "content": "def greet(name):\n    print(f\"Hello, {name}!\")\n    return f\"Hi {name}\""
  }
}
따라서 논문에서 제안한 방식은 XML 같은 특수 토큰 태그로 감싸는 방법이다. 같은 내용을 태그 방식으로 표현하면 이스케이프가 사라진다.
<tool_call>write_file
<arg_key>filename</arg_key>
<arg_value>hello.py</arg_value>
<arg_key>content</arg_key>
<arg_value>def greet(name):
    print(f"Hello, {name}!")
    return f"Hi {name}"
</arg_value>
</tool_call>
시작과 끝이 구분되어 있기 때문에 함수 호출 실행 성능은 떨어지지 않으면서 이스케이프 문자 사용량은 크게 줄어들게 됨.
Technique 2. Rejection Sampling
전문가 모델에서 샘플링할 때, multi-step 필터링 파이프라인을 사용
- 반복적이거나 지나치게 짧거나 잘린 샘플, 유효한 추론 형식을 준수하지 않는 샘플 제거
- 객관적인 답변이 있는 샘플에 대한 정확성 검증 수행
- 주관적인 질문에 대한 응답을 필터링하기 위해 보상 모델 사용
- 도구 호출 시나리오의 경우 적절한 도구 호출 프로토콜 준수 확인 및 최종적으로 호출에 도달하는지 검증
Technique 3. Prompt Selection and Response-Level Scaling
- 쉬운 문제들을 걸러내고 응답 길이 조정을 적용하는 것이 효과적임을 입증함
- 응답 길이를 기준으로 하위 50%(짧은 응답 = 쉬운 응답)에 해당하는 문제들을 제거한 결과, 절반의 데이터로만 학습했음에도 불구하고 수학 및 과학 과제에서 2~4% 향상됨
- 어려운 문제에 대해 4가지의 응답을 생성함으로써 추가 향상시킴
Technique 4. Automatic Agentic SFT Data Construction
에이전트형 SFT 데이터 구축은 다음 네 단계로 이루어짐
- Agentic Framework와 Tool 수집: 실제로 존재하는 에이전트 프레임워크와 실제 tool API, MCP 서버들을 수집하는 동시에 LLM을 활용하여 시뮬레이션함
- Task 합성: 1단계에서 모은 프레임워크/도구들을 바탕으로 이 도구를 써서 풀어야 하는 문제(task)를 LLM을 사용해서 자동으로 만듦. single-step과 multi-step 도구 호출을 모두 포함
- Trajectory 생성: 2단계에서 만든 task에 대해 LLM을 사용하여 도구 호출-해결의 전체 과정을 생성. 특히 multi-step인 경우 사용자와의 대화도 포함해서 생성함
- Quality Filtering: 만들어진 각 Trajectory에 대해 여러 개의 judge agents를 도입해서 과제가 잘 완료되었는지 평가함. 성공적으로 완료된 Trajectory만 학습 데이터로 채택
Reasoning RL
GRPO 강화학습 방법을 사용한다.
Difficulty-based Curriculum Learning
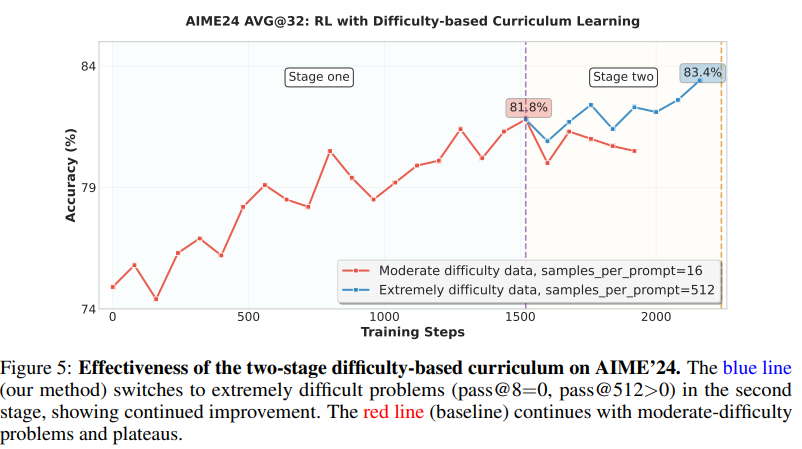
RL로 모델을 학습시키다 보면 모델의 실력은 향상되는데, 학습에 쓰는 데이터(난이도)는 고정되어 있음.
- 학습 후반부는 데이터가 너무 쉬워서 보상이 전부 1, 초반부는 데이터가 너무 어려워서 보상이 전부 0인 문제가 있고, 모델이 어느 방향으로 업데이트해야 하는지에 대한 신호가 없음
- 따라서 1단계는 상대적으로 쉽고 기본적인 문제로 시작하고, 학습하면 할수록 더 어려운 문제로 전환함. 이때 어려운 문제들은 정답이 검증된 문제 풀에서 엄격하게 가져옴
Single-Stage RL at 64K Output Length
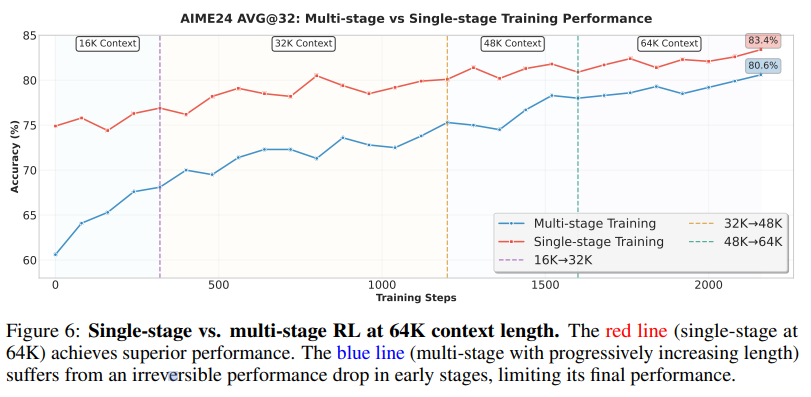
이전 연구에서는 multi-stage 방식으로 강화학습을 여러 단계로 나눠서, 각 단계마다 출력 길이를 점점 늘려가는 방식을 사용했다. 하지만 문제가 있음.
- SFT 단계에서 이미 64K 길이에 익숙해진 상태에서 RL을 짧은 길이(8K)부터 제한을 걸면 이전의 long-context 능력을 까먹기 시작함. 다시 8K에 익숙해짐. 결과적으로 다시 64K로 학습해도 최종 성능이 제한됨
- 따라서 처음부터 64K 길이를 허용하고 학습. 더 나은 성능을 보임
Dynamic Sampling Temperature
RL에서는 같은 문제에 대해 여러 번 시도하면서 어떤 시도가 더 나은가 비교하면서 학습하는데, temperature가 너무 낮으면 매번 비슷한 답만 나오고, 너무 높으면 답이 너무 제각각이라 노이즈 샘플이 많이 섞이는 문제가 있음.
또한 RL이 진행되면서 모델은 점점 특정 답변 패턴으로 수렴하는 경향이 있는데, temperature를 고정해두면 학습 후반으로 갈수록 낮은 효과를 보게 되면서 기존 패턴에만 머무르는 경향이 있음.
따라서 본 논문에서는
- 여러 시도(rollout)들의 평균 reward가 더 이상 안 오르고 안정화되면 모델이 수렴 단계에 접어들었다는 신호로 판단
- 별도의 검증 데이터셋에 대해 여러 temperature 값으로 모델 성능을 테스트한 후, 현재 최적 성능 대비 1% 이상 성능 하락을 일으키지 않는 범위 내에서 가장 높은 temperature 값을 동적으로 채택하여 사용
Code and Science RL
- 코드 영역에서는 GRPO로 학습 시, Sequence-mean loss보다 Token-weighted mean loss가 성능이 더 좋았음
- 과학 영역에서는 전문가가 검증한 객관식 문제만 사용하는 것이 품질이 섞이거나 검증 안 된 데이터를 쓰는 것보다 훨씬 좋은 성능을 냄
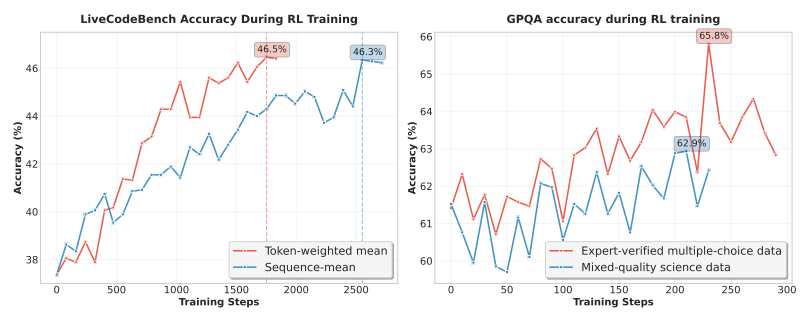
두 loss의 차이는 다음과 같다.
- Sequence-mean loss
- 응답 A: 10토큰 → 토큰별 loss 평균 = 0.5
- 응답 B: 1000토큰 → 토큰별 loss 평균 = 0.5
- 최종 loss = (0.5 + 0.5) / 2 = 0.5
- 응답 B는 1000개 토큰 정보가 있는데 0.5라는 하나의 값으로 표현되기 때문에, 시퀀스가 짧든 길든 loss에 기여하는 비중이 같음
- Token-weighted mean loss
- 시퀀스 단위로 먼저 평균 내는 것이 아닌, 모든 토큰들을 통틀어서 직접 평균(1010토큰으로 평균)
- 토큰이 많은 응답이 학습에 더 기여하게 됨
Agentic RL
학습 데이터
웹 검색 데이터
- multi-step 추론과 여러 웹 소스를 오가야 풀리는 어려운 질문-답변 쌍을 생성하는 파이프라인 개발
- 자동화: 지식 그래프 위에서 multi-hop 추론을 활용해 자동 생성
- 사람 개입: 사람이 직접 여러 웹페이지에서 정보를 추출하고 선택적으로 난독화하여 생성
소프트웨어 엔지니어링 데이터
- GitHub의 실제 PR과 issue를 대규모로 수집해서, 사용자 프롬프트 + 실행 가능한 단위 테스트로 구성된 벤치마크 구축
- 모든 평가는 분산 시스템을 갖춘 샌드박스 환경에서 실행됨
학습 방식
GRPO 계열의 강화학습 방식 사용. 흐름은 다음과 같다.
- 질문 \(x\) 샘플링
- 현재 모델로 그 질문에 대해 응답을 K개 생성
- 각 응답마다 리워드 계산
- K개의 리워드의 평균을 구해서 현재 리워드에서 평균을 뺌 (평균보다 높으면 강한 신호, 낮으면 약한 신호)
- K개의 신호에서 평균을 내서 하나의 스칼라 값으로 추출 → Loss
학습 시, 환경 피드백은 외부에서 주어진 데이터이기 때문에 학습 대상(loss 계산)에서 제외함. 아래 예시에서 [모델 생성] 부분만 학습하고 [환경 피드백] 부분은 마스킹된다.
[모델 생성]   "2024년 노벨 물리학상 수상자를 검색하겠습니다."
[모델 생성]   <tool_call>search
[모델 생성]   <arg_key>query</arg_key>
[모델 생성]   <arg_value>2024 노벨 물리학상</arg_value>
[모델 생성]   </tool_call>
[환경 피드백] <tool_response>
[환경 피드백] {"result": "2024년 노벨 물리학상은 존 홉필드와 제프리 힌튼이
[환경 피드백]  인공신경망 연구 공로로 수상했습니다."}
[환경 피드백] </tool_response>
[모델 생성]   "검색 결과를 확인했습니다. 2024년 노벨 물리학상은
[모델 생성]   존 홉필드와 제프리 힌튼이 수상했습니다."
Iterative Self-Distillation
에이전트 작업에 대한 강화학습은 훈련 시간이 많이 소요되기 때문에 self-distillation을 채택하여 강화학습을 적용.
- 초기 모델에 CoT가 포함된 소량의 데이터셋을 사용하여 SFT를 통해 콜드 스타트 모델을 만듦
- 이후에 RL을 적용해서 훈련을 다시 함. RL 단계에서 안정화되면, 콜드 스타트 데이터를 RL 모델이 생성한 응답으로 대체해서 자기 증류를 적용하고 더 나은 SFT 모델을 만듦
- 개선된 모델에 대해 추가적인 RL을 통해서 훈련 난이도를 점점 증가시키고 성능 한계를 끌어올림
Cold-start SFT → RL 적용 → 데이터 새로 추출 및 SFT 재학습 → RL 적용 → 다시 SFT → RL 적용
여기서 단계별로 학습된 모델을 재사용하는 것이 아닌, 초기 상태의 모델을 재학습하는 것으로 보임.
Interaction Turns Scaling
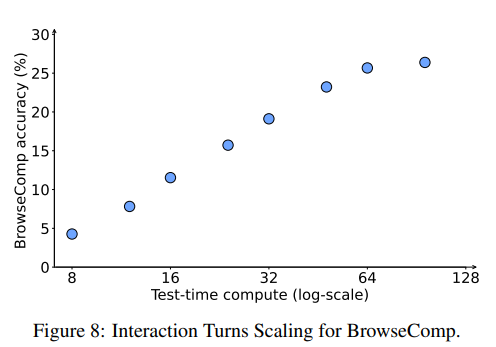
에이전트가 환경과 더 많이 상호작용(턴 수가 많을수록)할수록 성능이 더 좋아짐을 확인.
- 기존에 알려진 방식으로는 수학이나 추리 문제를 풀 때, 더 긴 CoT를 생성하게 함으로써(출력 토큰 수를 늘림) 성능이 올라감
- 본 논문에서 Agent 모델은 환경과 실제로 계속 상호작용을 반복하는 것이 성능이 더 높다는 것을 확인
- 웹검색 → 결과 확인 → 다시 검색 → 결과 확인 → 다시 검색 …
- 코드 작성 → 테스트케이스 실행 → 코드 수정 → 테스트케이스 실행 …
General RL
일반 강화학습은 모델의 전반적인 성능을 총체적으로 개선하며 핵심 기능을 강화하는 것을 목표로 함.
- General RL에서는 rule-based feedback, RLHF, model-based feedback(RLAIF)을 결합한 다중 소스 피드백 방식으로 학습함
- 인간 피드백의 경우, 주석 작성자는 모델의 응답을 비교하고 지시 준수, 안전성, 정확성 등 여러 차원에 대한 종합적인 평가를 바탕으로 주석을 할당하고 보상 모델을 학습시킴
- 모델 피드백의 경우, 프롬프트에 객관적인 정답이 있는지 여부에 따라 별도의 채점 기준표를 설계함
Holistic RL
- 다양한 영역에서 광범위한 성능 향상을 목표로 함
- 7개의 주요 범주, 33개의 보조 범주, 139개의 세부 범주에 걸쳐 약 5,000개의 프롬프트로 구성된 데이터셋을 구축
- RLHF와 선호도 라벨을 사용하여 보상 모델을 학습
Instruction Following RL
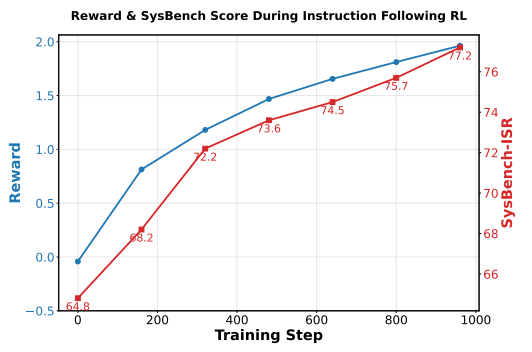
Instruction Following RL은 모델이 복잡한 명령을 이해하고 만족시키는 능력을 향상시키는 것을 목표로 함.
- 콘텐츠 요구사항, 서식 규칙 등을 포괄하는 7가지 주요 제약 조건 유형과 151가지의 보조 제약 조건 유형으로 구성된 분류 체계를 구축하고, 이 분류 체계를 기반으로 모든 제약 조건을 포괄하는 어려운 명령으로 구성된 전용 학습 세트를 구축
- 피드백 시스템은 3가지를 사용
- 사람이나 AI 판단 필요 없이, 정규식이나 코드를 사용하여 점수를 매김 (형식, 개수, 글자 수 등)
- 주관적인 지시사항을 채점하기 위해 별도로 학습시킨 보상 모델을 사용하여 점수를 스칼라 값으로 매김
- 단순 점수 판단을 넘어서 왜 틀렸는지 LLM을 이용해 도출하는 모델
- 3가지를 함께 사용함으로써 더 안정적이고 견고한 보상 신호를 만들어냄
Function Calling RL
함수 호출 강화학습은 step-wise rule-based RL과 end-to-end multi-turn RL로 나뉨.
1. Step-wise rule-based RL
- 학습 데이터의 각 단계/턴에 대한 정답 함수는 주석 처리되어 있음
- 작업과 이전 단계/턴의 함수 호출을 기반으로, 모델은 다음 응답(함수 또는 사용자 질문에 대한 응답)을 생성하도록 학습됨
- \(a_t\)는 모델이 생성한 \(t\)번째 함수 호출, \(a_t^{*}\)는 정답 함수 호출
- 모델이 생성한 함수가 정답과 정확히 일치해야만 1, 나머지는 0
모델의 출력은 함수 또는 질문에 대한 응답인데, 함수 호출에만 리워드를 주고 질문에 대한 응답의 스코어는 논문에 따로 나와 있지 않음.
2. End-to-end multi-turn RL
Step-wise 방식은 각 스텝마다 정답이 미리 정해져 있는 정적인 시나리오인 반면, 이 방식은 실제 세계의 상황에 맞게 대처하는 능력을 기르기 위해 고안됨. 모델이 실제로 자기가 선택한 결과를 보면서 시행착오를 통해 배우게 함.
- Single-turn multi-step tasks: 모델이 작업을 완료하기 위해 여러 단계의 함수를 호출하고 환경과 상호작용해야 하는 유형
- Multi-turn multi-step tasks: 환경과의 상호작용뿐 아니라, 전체 작업을 완수하기 위해 LLM(user)과 모델이 상호작용하면서 대화 + 도구 호출이 번갈아 이루어지는 시뮬레이션 유형
- \(I\)는 task, \(a_T\)는 모델의 함수 호출, \(o_T\)는 모델이 행동한 뒤 외부에서 오는 결과
- 보상 판단은 사전 정의된 규칙에 따라 LLM이 판단함
- 함수 호출에 대한 다양성은 허용하고, 작업이 완료되었는지의 결과만 확실히 검증함
Pathology RL
- General RL 학습 후, 최종 단계에서 언어 혼합, 반복, 형식 오류와 같은 잠재적인 문제를 수정해야 함
- 하지만 이런 샘플들은 발생률이 낮아서 학습 데이터 샘플링 효율이 낮기 때문에, 이런 결함을 유발할 가능성이 높은 프롬프트만 식별하여 따로 맞춤형 데이터셋을 구축하여 학습함
RL Infrastructure: Slime
RL 작업 종류에 따라 다른 방식을 사용한다.
- Agentic 작업은 데이터 생성 자체가 오래 걸리고 복잡하기 때문에, 동기 방식으로 하면 다른 작업들까지 기다려야 하는 병목현상이 생김. 이를 비동기로 분리하여 처리함
- Ray 프레임워크를 이용해 학습/추론 엔진을 같은 GPU에 두거나 다른 GPU에 둘 수 있게 유연하게 설계함
rollout: 현재의 정책을 실행시켜서 문제를 풀어보게 하고 그 결과를 얻는 과정
| Synchronous, Colocated (동기, 같은 자리) | Asynchronous, Disaggregated (비동기, 분리) | |
|---|---|---|
| 적합한 작업 | 일반 reasoning RL (수학, 코드 등) | Agentic 작업 (SWE 등, 오래 걸리고 복잡한 상호작용) |
| 구조 | 학습(training)과 추론(inference)이 같은 워커에 위치 | 학습용 GPU와 추론(rollout)용 GPU를 독립적으로 스케줄링 |
| 장점 | GPU 유휴시간 감소, 자원 활용 극대화 | 느린 에이전트 작업이 전체 학습을 막지 않음, 데이터 생성이 끊김없이 계속됨 |
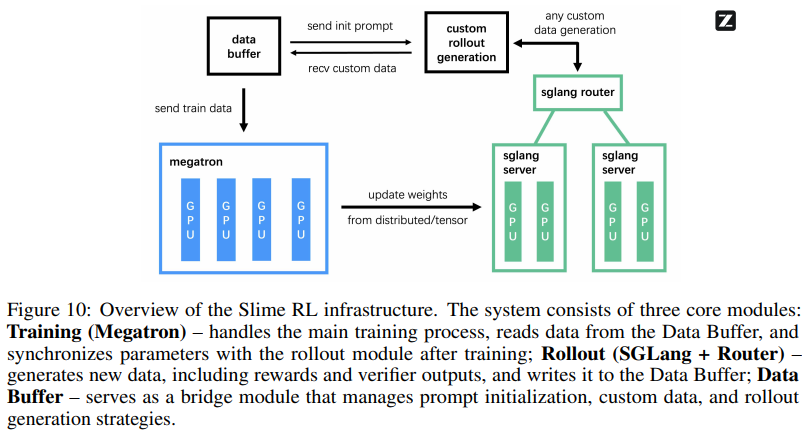
Slime은 세 가지 핵심 모듈로 구성된다.
- Training (Megatron): 실제 모델 학습 담당. Data Buffer에서 데이터를 읽고, 학습 후 rollout 모듈과 파라미터를 동기화
- Rollout (SGLang + Router): 새 데이터(rollout) 생성. 보상/검증 결과도 함께 만들어 Data Buffer에 기록
- Data Buffer: 위 둘을 이어주는 다리 역할 (프롬프트 관리, 데이터 관리)
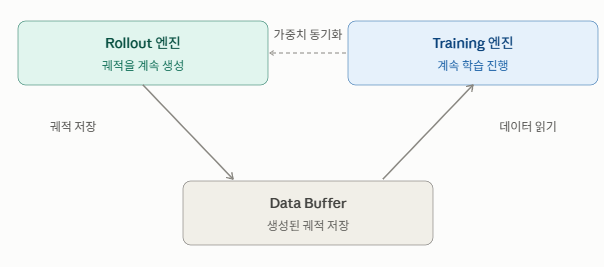
Slime의 주요 최적화 기법은 다음과 같다.
- Mixed-Precision으로 데이터 생성 가속화: 학습은 BF16을 사용하고, 추론/데이터 생성은 FP8로 낮춰서 가속. 매 정책 업데이트마다 모델 파라미터를 FP8로 양자화해서 데이터 생성 처리량을 크게 향상시킴
- 각 agent 작업마다 독립된 Docker 환경을 제공해서 rollout 시간을 크게 줄임
- GPU를 rollout / training 전용으로 분리
- 여러 종류의 agent framework를 하나로 다루기 위해 중앙 데이터 풀을 도입. Agent framework들이 만드는 결과물은 하나의 중앙 데이터 풀에 모여서 학습에 사용됨. 작업별 필터링과 동적 샘플링도 지원
Model Unified
- 3개의 도메인(Reasoning / Agent / General chat)에 대해 강화학습이 완료된 전문가 모델에서 각각 응답을 대량으로 수집
- 이 데이터를 하나의 base 모델에 SFT 방식으로 distillation하여 단일 모델로 통합
- reasoning 데이터와 non-reasoning 데이터를 균형 있게 섞어 하이브리드 모드를 가능하게 함
댓글남기기