MQA & GQA: Training Generalized Multi-Query Transformer Models from Multi-Head Checkpoints 논문정리
논문: GQA: Training Generalized Multi-Query Transformer Models from Multi-Head Checkpoints
MQA(Multi-Query Attention)와 GQA(Grouped-Query Attention)를 함께 정리한 글입니다. 코드는 PyTorch로 직접 구현한 MHA / MQA / GQA를 기준으로 설명합니다.
Abstract
- Multi-query attention(MQA)은 단일 key-value 헤드만 사용하기 때문에 디코더 추론 속도를 획기적으로 향상시킴. 하지만 품질 저하를 초래함
- 본 논문에서는
- 기존에 멀티헤드 어텐션(MHA)으로 학습된 모델에 MQA를 도입해서, 원래 학습량의 5%만의 컴퓨팅 자원을 사용하여 학습(uptraining)하는 방법 제안
- MQA를 일반화한 GQA(Grouped-query attention) 방식 제안
Baseline: Multi-Head Attention (MHA)
비교를 위해 기본 MHA 구현부터 본다. 핵심은 K, V도 Q와 동일하게 head 수 전체만큼 투영한다는 것이다. 그래서 KV cache의 head 축이 num_heads(예: 96)만큼 커진다.
import torch
import torch.nn as nn
import torch.nn.functional as F


class MultiHeadAttention(nn.Module):
    def __init__(self, hidden_dim, num_heads):
        super().__init__()
        assert hidden_dim % num_heads == 0

        self.hidden_dim = hidden_dim
        self.num_heads = num_heads
        self.head_dim = hidden_dim // num_heads

        # ---- Q, K, V projection ----
        # MHA는 K, V도 Q와 "동일하게" head 수 전체만큼 투영한다.
        # weight shape: (hidden_dim, num_heads * head_dim) = (hidden_dim, hidden_dim)
        #   예) (768, 768)  ->  파라미터 수 768*768 = 589,824
        self.q_proj = nn.Linear(hidden_dim, num_heads * self.head_dim, bias=False)  # (768, 768)
        self.k_proj = nn.Linear(hidden_dim, num_heads * self.head_dim, bias=False)  # (768, 768)  <- head 수만큼 큼
        self.v_proj = nn.Linear(hidden_dim, num_heads * self.head_dim, bias=False)  # (768, 768)  <- head 수만큼 큼

        # ---- 출력 projection ----
        self.out_proj = nn.Linear(num_heads * self.head_dim, hidden_dim, bias=False)  # (768, 768)

        # ---- 총 파라미터 수 ----
        # Q + K + V + Out = 768*768 * 4 = 2,359,296
        # (K, V가 Q와 완전히 같은 크기라는 점이 GQA와의 결정적 차이)

    def forward(self, x, kv_cache=None, use_causal_mask=True):
        B, T, _ = x.shape

        q = self.q_proj(x)  # (B, T, 768)
        k = self.k_proj(x)  # (B, T, 768)  <- head 96개 분량 전부
        v = self.v_proj(x)  # (B, T, 768)  <- head 96개 분량 전부

        q = q.view(B, T, self.num_heads, self.head_dim).transpose(1, 2)  # (B, 96, T, 8)
        k = k.view(B, T, self.num_heads, self.head_dim).transpose(1, 2)  # (B, 96, T, 8)  <- 96개 그대로
        v = v.view(B, T, self.num_heads, self.head_dim).transpose(1, 2)  # (B, 96, T, 8)  <- 96개 그대로

        if kv_cache is not None:
            past_k, past_v = kv_cache
            k = torch.cat([past_k, k], dim=2)
            v = torch.cat([past_v, v], dim=2)
        new_kv_cache = (k, v)  # ★ KV cache 크기: (B, num_heads=96, T, head_dim) <- 매우 큼

        if use_causal_mask and T > 1:
            # 프리필(prefill) 단계: T_new == T_total 인 경우만 표준 causal mask 사용 가능
            attn_out = F.scaled_dot_product_attention(q, k, v, is_causal=True)
        else:
            # 디코딩(decoding) 단계: 새 토큰 1개가 과거 전체를 볼 수 있어야 하므로 mask 불필요
            attn_out = F.scaled_dot_product_attention(q, k, v, is_causal=False)
        attn_out = attn_out.transpose(1, 2).contiguous().view(B, T, -1)
        out = self.out_proj(attn_out)

        return out, new_kv_cache
Method 1. Multi-Query Attention (MQA)
MQA 코드 구현
MQA는 Query head 수는 그대로 유지하고, K와 V는 head 1개 분량만 투영한다. 즉 모든 Query head가 하나의 K, V head를 공유한다.
k_proj,v_proj의 weight가 (768, 768)에서 (768, 8)로 줄어듦- KV cache 크기도 head 축이 96에서 1로 줄어듦
- attention 계산 직전에 K, V를
num_heads만큼expand해서 Q와 shape을 맞춤 (expand는 메모리 복사 없이 view만 늘림)
class MultiQueryAttention(nn.Module):
    def __init__(self, hidden_dim, num_heads):
        super().__init__()
        assert hidden_dim % num_heads == 0

        self.hidden_dim = hidden_dim
        self.num_heads = num_heads          # ★ Query head 수는 그대로 유지 (예: 96)
        self.head_dim = hidden_dim // num_heads  # ★ head_dim은 hidden_dim // num_heads (예: 8)

        # ---- Q: head 수만큼 그대로 ----
        self.q_proj = nn.Linear(hidden_dim, num_heads * self.head_dim, bias=False)  # (768, 768)

        # ---- K, V: head 1개 분량만 ----
        self.k_proj = nn.Linear(hidden_dim, 1 * self.head_dim, bias=False)  # (768, 8)  <- head_dim(8)만
        self.v_proj = nn.Linear(hidden_dim, 1 * self.head_dim, bias=False)  # (768, 8)  <- head_dim(8)만

        self.out_proj = nn.Linear(num_heads * self.head_dim, hidden_dim, bias=False)  # (768, 768)

    def forward(self, x, kv_cache=None, use_causal_mask=True):
        B, T, _ = x.shape

        q = self.q_proj(x)  # (B, T, 768)
        k = self.k_proj(x)  # (B, T, 8)    <- head_dim만큼만
        v = self.v_proj(x)  # (B, T, 8)

        q = q.view(B, T, self.num_heads, self.head_dim).transpose(1, 2)  # (B, 96, T, 8)
        k = k.view(B, T, 1, self.head_dim).transpose(1, 2)               # (B, 1, T, 8)
        v = v.view(B, T, 1, self.head_dim).transpose(1, 2)               # (B, 1, T, 8)

        if kv_cache is not None:
            past_k, past_v = kv_cache
            k = torch.cat([past_k, k], dim=2)
            v = torch.cat([past_v, v], dim=2)
        new_kv_cache = (k, v)  # ★ KV cache 크기: (B, 1, T, 8)  <- head 축이 1

        # attention 계산 전, K/V를 num_heads(96)번 복제해서 Q와 shape 맞춤
        k = k.expand(-1, self.num_heads, -1, -1)  # (B, 96, T, 8)
        v = v.expand(-1, self.num_heads, -1, -1)  # (B, 96, T, 8)

        if use_causal_mask and T > 1:
            # 프리필(prefill) 단계: T_new == T_total 인 경우만 표준 causal mask 사용 가능
            attn_out = F.scaled_dot_product_attention(q, k, v, is_causal=True)
        else:
            # 디코딩(decoding) 단계: 새 토큰 1개가 과거 전체를 볼 수 있어야 하므로 mask 불필요
            attn_out = F.scaled_dot_product_attention(q, k, v, is_causal=False)
        attn_out = attn_out.transpose(1, 2).contiguous().view(B, T, -1)
        out = self.out_proj(attn_out)

        return out, new_kv_cache
MHA 체크포인트를 MQA로 변환 (Uptraining)
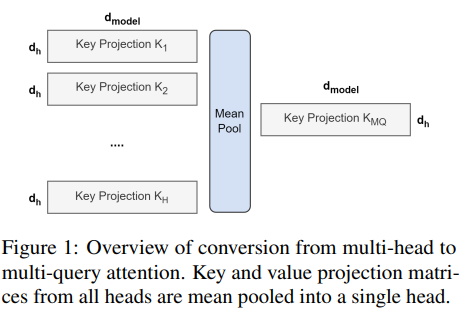
이미 학습된 MHA 모델이 있다고 가정하고, 이 가중치를 mean pooling해서 MQA 모델에 가중치를 덮어쓰는 방식이다. 랜덤 초기화하거나 특정 key-head 하나를 그대로 골라 쓰는 방식보다 성능이 좋다고 함.
# 이미 학습된 MHA 모델이 있다고 가정
mha_model = ...  # 사전학습 완료된 MHA 모델, k_proj.weight shape: (768, 768)

# 새 MQA 모델 생성 (지금은 랜덤 초기화 상태)
mqa_model = MultiQueryAttention(hidden_dim=768, num_heads=96)

# ★ 여기서 mean pooling: 기존 MHA weight를 head별로 쪼개서 평균낸 뒤
#    MQA의 k_proj.weight에 덮어씀 (랜덤 초기화 값을 대체)
# 주의: nn.Linear.weight의 shape은 (out_features, in_features)이므로
#       head 축은 dim=0(out 방향)에 있다.
with torch.no_grad():
    mha_k_weight = mha_model.k_proj.weight  # (768, 768) = (num_heads * head_dim, hidden_dim)
    mha_k_weight_per_head = mha_k_weight.view(96, 8, 768)  # (num_heads, head_dim, hidden_dim)
    mqa_model.k_proj.weight.copy_(mha_k_weight_per_head.mean(dim=0))  # (8, 768)로 평균 -> 복사

    mha_v_weight_per_head = mha_model.v_proj.weight.view(96, 8, 768)
    mqa_model.v_proj.weight.copy_(mha_v_weight_per_head.mean(dim=0))

    # Q, Out projection은 구조가 그대로라 기존 가중치를 그냥 복사
    mqa_model.q_proj.weight.copy_(mha_model.q_proj.weight)
    mqa_model.out_proj.weight.copy_(mha_model.out_proj.weight)

# 이후: 이렇게 초기화된 mqa_model을 원래 학습량의 5%만 추가 학습 (uptraining)
Method 2. Grouped-Query Attention (GQA)
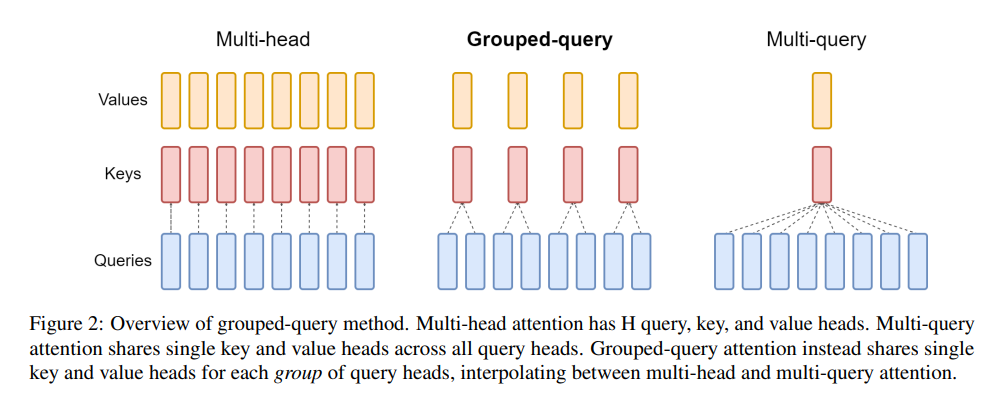
GQA는 MHA와 MQA의 중간 형태다. Query head들을 G개의 그룹으로 나누고, 각 그룹이 하나의 K, V head를 공유한다.
- 그룹 수 G = 1이면 MQA, G = num_heads이면 MHA와 동일
GQA 코드 구현
아래 예시는 num_heads=96, num_kv_heads=8인 경우다. Query head 96개가 12개씩 묶여서 8개의 K, V head를 공유한다.
k_proj,v_proj의 weight가 (768, 64)로,num_kv_heads * head_dim만큼만 투영- KV cache 크기는 head 축이 8
- attention 계산 직전에
repeat_interleave로 K, V를 그룹 수만큼 복제해서 Q와 shape을 맞춤
class GroupQueryAttention(nn.Module):
    def __init__(self, hidden_dim=768, num_heads=96, num_kv_heads=8):
        super().__init__()
        assert hidden_dim % num_heads == 0

        self.hidden_dim = hidden_dim
        self.num_heads = num_heads
        self.num_kv_heads = num_kv_heads            # 8
        self.head_dim = hidden_dim // num_heads     # 8
        self.num_groups = num_heads // num_kv_heads # 12 (그룹당 Query head 수)

        # ---- Q: head 수만큼 그대로 ----
        self.q_proj = nn.Linear(hidden_dim, num_heads * self.head_dim, bias=False)  # (768, 768)

        # ---- K, V: head 8개 분량만 (Query head 12개가 K/V head 1개를 공유. 8개 K/V head -> 총 96 Query head) ----
        self.k_proj = nn.Linear(hidden_dim, num_kv_heads * self.head_dim, bias=False)  # (768, 64)  <- num_kv_heads * head_dim
        self.v_proj = nn.Linear(hidden_dim, num_kv_heads * self.head_dim, bias=False)  # (768, 64)  <- num_kv_heads * head_dim

        self.out_proj = nn.Linear(num_heads * self.head_dim, hidden_dim, bias=False)  # (768, 768)

    def forward(self, x, kv_cache=None, use_causal_mask=True):
        B, T, _ = x.shape

        q = self.q_proj(x)  # (B, T, 768)
        k = self.k_proj(x)  # (B, T, 64)   <- num_kv_heads * head_dim만큼만
        v = self.v_proj(x)  # (B, T, 64)

        q = q.view(B, T, self.num_heads, self.head_dim).transpose(1, 2)     # (B, 96, T, 8)
        k = k.view(B, T, self.num_kv_heads, self.head_dim).transpose(1, 2)  # (B, 8, T, 8)
        v = v.view(B, T, self.num_kv_heads, self.head_dim).transpose(1, 2)  # (B, 8, T, 8)

        if kv_cache is not None:
            past_k, past_v = kv_cache
            k = torch.cat([past_k, k], dim=2)
            v = torch.cat([past_v, v], dim=2)
        new_kv_cache = (k, v)  # ★ KV cache 크기: (B, 8, T, 8)  <- head 축이 8

        # attention 계산 전, K/V를 num_heads(96)번 복제해서 Q와 shape 맞춤
        k = k.repeat_interleave(self.num_groups, dim=1)  # (B, 96, T, 8)
        v = v.repeat_interleave(self.num_groups, dim=1)  # (B, 96, T, 8)

        if use_causal_mask and T > 1:
            # 프리필(prefill) 단계: T_new == T_total 인 경우만 표준 causal mask 사용 가능
            attn_out = F.scaled_dot_product_attention(q, k, v, is_causal=True)
        else:
            # 디코딩(decoding) 단계: 새 토큰 1개가 과거 전체를 볼 수 있어야 하므로 mask 불필요
            attn_out = F.scaled_dot_product_attention(q, k, v, is_causal=False)
        attn_out = attn_out.transpose(1, 2).contiguous().view(B, T, -1)
        out = self.out_proj(attn_out)

        return out, new_kv_cache
MHA 체크포인트를 GQA로 변환 (Uptraining)
GQA도 마찬가지로 MHA 모델에서 변환할 때 MQA와 같은 방식으로 가중치를 덮어쓴다. 단, head 전체의 평균이 아니라 같은 그룹에 속하는 head끼리만 평균을 낸다. 아래는 K/V head가 8개일 때, 각 그룹 안의 Query head 12개에 대응하는 K, V 가중치를 평균내는 코드다.
with torch.no_grad():
    mha_k_weight = mha_model.k_proj.weight  # (768, 768) = (num_heads * head_dim, hidden_dim)
    mha_v_weight = mha_model.v_proj.weight  # (768, 768)

    # (96 * 8, hidden) -> (num_kv_heads=8, num_groups=12, head_dim=8, hidden)
    # 연속된 Query head 12개가 하나의 K/V head를 공유하도록 묶는다 (repeat_interleave 순서와 일치)
    gqa_k_reshaped = mha_k_weight.view(8, 12, 8, 768)
    gqa_v_reshaped = mha_v_weight.view(8, 12, 8, 768)

    # 그룹 내부(12개, dim=1)만 평균 -> (8, 8, 768)
    gqa_k_new = gqa_k_reshaped.mean(dim=1)
    gqa_v_new = gqa_v_reshaped.mean(dim=1)

    # (8, 8, 768) -> (64, 768)로 펼쳐서 gqa_model.k_proj.weight shape과 맞춤
    gqa_k_new = gqa_k_new.reshape(8 * 8, 768)
    gqa_v_new = gqa_v_new.reshape(8 * 8, 768)

    gqa_model.k_proj.weight.copy_(gqa_k_new)  # ★ q_proj가 아니라 k_proj
    gqa_model.v_proj.weight.copy_(gqa_v_new)

    # Q, Out은 구조가 그대로이므로 원본 그대로 복사
    gqa_model.q_proj.weight.copy_(mha_model.q_proj.weight)
    gqa_model.out_proj.weight.copy_(mha_model.out_proj.weight)
세 방식 비교
hidden_dim=768, num_heads=96, num_kv_heads=8 기준으로 정리하면 다음과 같다.
| MHA | GQA (8 groups) | MQA | |
|---|---|---|---|
| K/V head 수 | 96 | 8 | 1 |
k_proj (in → out) |
768 → 768 | 768 → 64 | 768 → 8 |
| KV cache shape | (B, 96, T, 8) | (B, 8, T, 8) | (B, 1, T, 8) |
| 토큰당 KV cache 크기 | 2 × 768 = 1,536 | 2 × 64 = 128 | 2 × 8 = 16 |
Result
- GQA는 메모리/속도는 거의 MQA만큼 챙기면서 품질은 MHA에 가깝게 유지하는 절충안
- Head 수가 많을수록 GQA가 유리
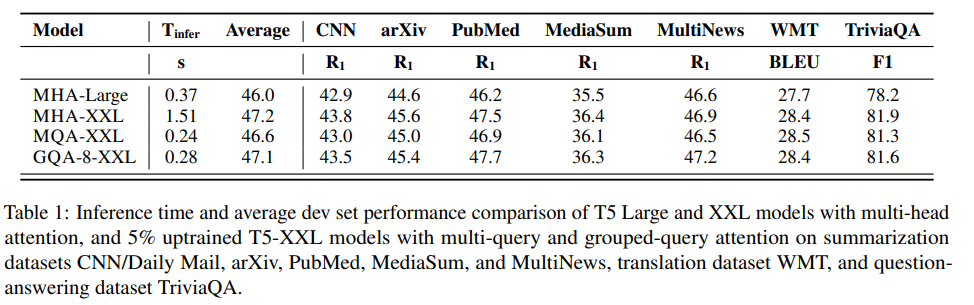
- MHA-XXL 대비 MQA-XXL은 추론 시간이 1.51s에서 0.24s로 크게 줄지만 평균 성능이 47.2에서 46.6으로 떨어짐
- GQA-8-XXL은 추론 시간 0.28s로 MQA와 거의 같으면서 평균 성능 47.1로 MHA-XXL에 근접함
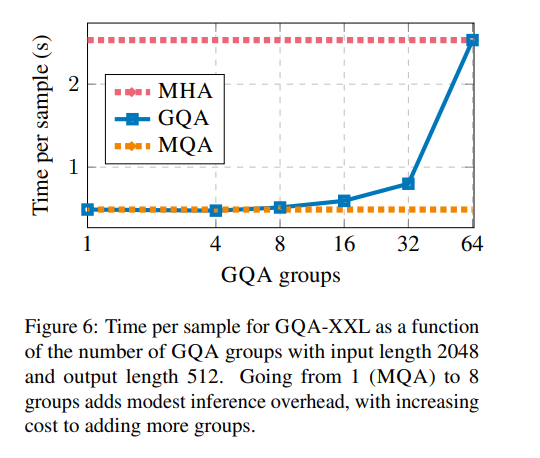
- 그룹 수를 1(MQA)에서 8로 늘려도 추론 시간 증가는 미미하지만, 그 이상으로 늘리면 비용이 급격히 커짐
참고 1. MQA/GQA가 줄이는 것은 연산량이 아니라 메모리 이동량
MQA나 GQA는 메모리 연산 효율성을 높이는 게 아님!
- 한 스텝씩 디코딩할 때, 매 스텝마다 GPU는 토큰 1개에 대해 Query 하나만 계산하면 되는데, 이 Query를 계산할 때 이전에 계산된 K, V가 필요함
- 연산은 상대적으로 적으나 K, V를 매번 GPU 메모리에서 가져와야 하기 때문에 병목이 생김 (memory bandwidth bound)
- GQA나 MQA가 줄이는 건 이동해야 할 데이터의 양임!
참고 2. KV-cache
어텐션은 기본적으로 모든 시퀀스끼리 병렬로 연산을 함(쉽게 말해 유사도를 구함).
디코딩 때는 원래 방식대로라면
- 1스텝: “오늘”이 입력으로 들어가면 → Q, K, V를 통해 attention 연산을 하고 → “날씨는”이라는 토큰 반환
- 2스텝: “오늘 날씨는”이 입력으로 들어가면 → Q, K, V를 통해 “오늘”, “날씨는”의 attention 연산을 함 → “맑음”이라는 토큰 반환
- 3스텝: “오늘 날씨는 맑음”이 들어가면 → “오늘”, “날씨는”, “맑음” 토큰 3개를 병렬로 attention 연산함 → “입니다”라는 토큰 반환
이때 1스텝의 K, V는 한 개, 2스텝은 2개, 3스텝은 3개인데, 3스텝일 때 1스텝, 2스텝의 K, V는 바뀌지 않음. 근데 연산은 많음. 그래서 K, V를 캐싱해 놓고 이전 K, V는 가져다가만 씀.
- 1스텝: “오늘”이 입력으로 들어가면 → Q1, K1, V1 계산 → K1, V1 캐시 → Q1과 K1, V1으로 attention 계산 → “날씨는” 출력
- 2스텝: “날씨는”만 입력으로 들어가면 → Q2, K2, V2 계산 → K2, V2 캐시 → Q2와 [K1, K2], [V1, V2]로 attention 계산 → “맑음” 출력
- …
모든 단어들에 대해 어텐션 연산을 해야 하는데, 이전 K, V를 저장해 놓고 캐시하자는 방식. 결과는 같지만 매번 처음부터 연산을 안 해도 되기 때문에 연산 효율성이 좋음.
위 코드에서 kv_cache 인자가 바로 이 역할을 한다. 디코딩 시에는 새 토큰 1개(T=1)만 넣고, 과거의 K, V는 torch.cat으로 이어 붙여서 사용한다. 이 캐시의 크기가 MHA는 (B, 96, T, 8), GQA는 (B, 8, T, 8), MQA는 (B, 1, T, 8)이므로, 시퀀스가 길어질수록 MQA/GQA의 메모리 이점이 커진다.
댓글남기기