DSA(DeepSeek Sparse Attention): DeepSeek-V3.2-Exp 논문정리
논문: DeepSeek-V3.2-Exp: Boosting Long-Context Efficiency with DeepSeek Sparse Attention
DSA는 MLA 위에 얹어서 구현되므로, MLA를 먼저 보고 오면 이해가 빠릅니다. 논문의 수식은 직접 구현한 PyTorch 코드와 함께 정리했습니다.
DSA
- 기존 attention은 쿼리 토큰이 시퀀스 내 모든 이전 토큰과 attention score를 계산해야 해서 복잡도가 높음. Long-context에서 병목이 됨
- 어차피 대부분의 토큰은 현재 쿼리와 관련이 낮으니, 관련성 높은 top-k만 골라서 그 토큰들에만 attention을 적용하자는 발상
- Lightning Indexer와 Top-k Selector 두 모듈로 구성됨
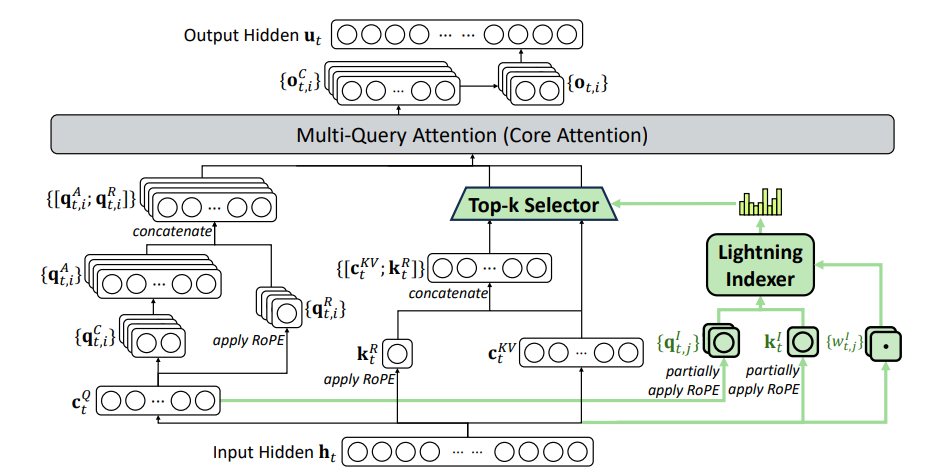
초록색 부분이 DSA가 추가된 영역이다. DeepSeek-V3.1-Terminus에서 아키텍처 변경점은 DSA 도입 하나뿐이고, 나머지는 그대로 두고 continued training으로 붙였다.
Lightning Indexer
Lightning Indexer는 쿼리 토큰 $h_t$와 이전 토큰 $h_s$ 사이의 인덱스 스코어 $I_{t,s}$를 계산한다. 이 점수가 “이 토큰을 고를지 말지”를 결정한다.
\[I_{t,s} = \sum_{j=1}^{H^I} w^I_{t,j} \cdot \mathrm{ReLU}\left(q^I_{t,j} \cdot k^I_s\right)\]각 항의 의미는 다음과 같다.
- $q^I_{t,j}$ = 입력 $h_t$로부터 만들어낸 $j$번째 인덱서 헤드용 쿼리 벡터
- $k^I_s$ = 이전 토큰 $h_s$로부터 만들어낸 인덱서 키 벡터
- $w^I_{t,j}$ = $h_t$에서 나온, $j$번째 헤드에 대한 가중치 스칼라
- $H^I$ = 인덱서 헤드 수. 메인 어텐션보다 훨씬 적다
즉 입력 $h_t$에 대해서 쿼리 벡터를 만들고, 입력 $h_s$에 대해서 키 벡터를 만들어 내적해서 여러 개의 헤드로 유사도를 계산하고, 헤드별로 가중치를 곱해서 다 더한 값이다. 학습 시에는 $h_t$와 $h_s$가 동일하고, 디코딩 시에는 $h_s$가 지금까지의 입력 전체가 된다.
최종 스코어 $I$는 쿼리의 $t$ 위치와 key의 $s$ 위치 간의 점수를 의미한다.
ReLU를 사용하는 이유: attention에서 Softmax는 score를 확률 분포로 만들어서 가중합하기 위해 사용하지만, 이 단계에서는 가중합이 필요 없고 단순히 크고 작음의 상대적 순서만 보존하면 된다. 논문에서도 throughput을 이유로 ReLU를 선택했다고 밝히고 있다. 인덱서는 헤드 수가 적고 FP8로 구현 가능해서 연산 효율이 매우 좋다.
코드 구현
위 수식 (1)을 그대로 옮기면 다음과 같다. 키 벡터 $k^I_s$는 MQA처럼 헤드 간에 공유하므로 헤드마다 따로 만들지 않는다.
import torch
import torch.nn as nn
import torch.nn.functional as F


class LightningIndexer(nn.Module):
    """
    수식 (1): I_{t,s} = sum_j w^I_{t,j} * ReLU(q^I_{t,j} · k^I_s)

    본 어텐션보다 훨씬 적은 헤드 수(H_I)와 작은 차원(d_I)을 사용해서
    아주 가볍게 "이 토큰이 중요한지"를 스코어링하는 모듈.
    """
    def __init__(self, d_model, d_indexer=64, n_indexer_heads=4):
        super().__init__()
        self.H_I = n_indexer_heads
        self.d_I = d_indexer

        # 입력 h_t로부터 인덱서용 query 벡터를 뽑는 projection
        self.q_proj = nn.Linear(d_model, n_indexer_heads * d_indexer, bias=False)
        # 입력 h_t로부터 인덱서용 가중치 스칼라(w)를 뽑는 projection
        self.w_proj = nn.Linear(d_model, n_indexer_heads, bias=False)  # w^I_{t,j}

        # 이전 입력 h_s로부터 인덱서용 k를 뽑는 projection
        self.k_proj = nn.Linear(d_model, d_indexer, bias=False)
        # 논문: k^I_s는 헤드 간 공유(MQA처럼) — 헤드마다 따로 안 만듦

    def forward(self, h_t, h_s_all, causal_mask=None):
        """
        h_t: (B, T, d_model)      - 입력
        h_s_all: (B, S, d_model)  - 이전 입력 전체
            (학습에서는 h_t와 h_s_all이 같음. 디코딩 시에는 h_t는 토큰 1개이고
             h_s_all은 이전 토큰 전체임.)
        return: I  (B, T, S)      - 각 쿼리-키 쌍의 인덱스 스코어
        """
        B, T, _ = h_t.shape

        # q^I_{t,j}: (B, T, H_I, d_I)
        q = self.q_proj(h_t).view(B, T, self.H_I, self.d_I)
        # w^I_{t,j}: (B, T, H_I)
        w = self.w_proj(h_t)
        # k^I_s: (B, S, d_I) — 모든 헤드가 공유
        k = self.k_proj(h_s_all)

        # 내적 q·k : (B, T, H_I, S)
        # einsum으로 각 헤드 j마다 q_{t,j} · k_s 를 모든 s에 대해 계산
        qk = torch.einsum('bthd,bsd->bths', q, k)
        qk = F.relu(qk)

        # 헤드 가중치 곱하고 헤드 차원(H_I)에 대해 합산 -> 수식 (1)의 sum_j
        # w: (B, T, H_I) 를 곱한 뒤 H_I축 sum
        I = torch.einsum('bths,bth->bts', qk, w)   # (B, T, S)

        if causal_mask is not None:
            I = I.masked_fill(causal_mask, float('-inf'))  # 미래 토큰 차단

        return I  # 각 (t, s) 쌍의 인덱스 스코어
einsum이 익숙하지 않다면 아래처럼 풀어 써도 같은 결과가 나온다.
q_ = q.permute(0, 2, 1, 3)                 # (B, T, H, D) -> (B, H, T, D)
k_ = k.transpose(-1, -2).unsqueeze(1)      # (B, S, D) -> (B, D, S) -> (B, 1, D, S)
qk = q_ @ k_                               # (B, H, T, S)
qk = qk.permute(0, 2, 1, 3)                # (B, T, H, S)
Top-k Selector
인덱스 스코어가 나오면, 쿼리 토큰마다 상위 k개의 key-value entry ${c_s}$만 골라서 그 위에서만 attention을 수행한다.
\[u_t = \mathrm{Attn}\left(h_t,\ \{c_s \mid I_{t,s} \in \text{Top-k}(I_{t,:})\}\right)\]- query 토큰과 key 토큰의 모든 위치에 대한 인덱스 스코어에서 top-k개를 고름
- k개에 해당하는 key 벡터들의 위치에 있는 KV latent $c_s$를 골라냄
- 그렇게 골라낸 k개의 $c_s$와 $h_t$에 대해서 attention 연산을 수행
정리하면 인덱서 스코어링은 전체 시퀀스에 대해 다 하지만 가볍게(헤드 수를 적게) 하고, 실제 attention 연산은 상위 k개에 대해서만 한다는 원리다.
코드 구현
여기서는 실제 벡터를 gather하지 않고 위치 인덱스만 반환한다. 이렇게 분리해야 이후 KV latent를 gather할 때 재사용할 수 있다.
class TopKSelector:
    """
    수식 (2)의 선택 부분: S_t = { s | I_{t,s} in Top-k(I_{t,:}) }

    인덱스 스코어를 기반으로, 쿼리 토큰마다 top-k에 해당하는 '위치(index)'만
    골라내는 역할. 실제 벡터 선택(gather)은 여기서 하지 않고 인덱스만 반환한다.
    이렇게 분리해야 이후 KV latent를 gather할 때 재사용 가능.
    """
    def __init__(self, top_k):
        self.k = top_k

    def select(self, I):
        """
        I: (B, T, S) 인덱스 스코어
        return: topk_idx (B, T, k) — 각 쿼리 t가 선택한 s의 인덱스들
        """
        k = min(self.k, I.shape[-1])
        # 스코어 기준 상위 k개의 '위치(index)'를 뽑는다
        topk_scores, topk_idx = torch.topk(I, k=k, dim=-1)  # (B, T, k)
        return topk_idx, topk_scores
학습 방법
Lightning Indexer는 “메인 어텐션이 중요하게 본 토큰”을 똑같이 짚어낼 수 있어야 한다. 그래서 인덱서의 출력 분포를 메인 어텐션 분포에 맞추는 KL divergence loss로 학습한다.
타깃 분포 $p_{t,:}$는 메인 어텐션 스코어를 모든 헤드에 대해 합산한 뒤 시퀀스 방향으로 L1 정규화해서 만든다.
Dense Warm-up Stage
\(\mathcal{L}^I = \sum_t D_{KL}\left(p_{t,:} \;\Vert\; \mathrm{Softmax}(I_{t,:})\right)\)
- $p_t$는 메인 어텐션의 분포이고, $\mathrm{Softmax}(I_t)$는 lightning indexer에서 나온 score를 softmax 정규화해서 확률 분포로 변환한 것
- 인덱서 score도 작은 버전의 attention(완전한 attention은 아니고, 더 작은 헤드를 추가해서 q, k만 내적한 것)이므로 메인 어텐션 분포와 최대한 비슷해지도록 함. 모든 토큰에 대해 sum해서 하나의 값을 출력
- 메인 모델은 어느 정도 학습이 된 상태에서, 모델 체크포인트에 인덱서 모듈만 새로 붙여서 추가로 학습하는 단계임. 즉 메인 어텐션의 분포는 이미 의미 있는 패턴을 가진 상태에서 학습함
- 이 단계에서는 dense attention을 유지하고, 인덱서를 제외한 모든 파라미터를 동결함. 인덱서의 q, w, k 파라미터만 업데이트됨
- 논문 설정: learning rate $10^{-3}$, 1000 steps, step당 128K 토큰 시퀀스 16개로 총 2.1B 토큰
Sparse Training Stage
\(\mathcal{L}^I = \sum_t D_{KL}\left(p_{t,S_t} \;\Vert\; \mathrm{Softmax}(I_{t,S_t})\right)\)
- warm-up 단계에서는 모든 key 토큰들에 대해서 분포를 비교했는데, 이 단계에서는 top-k로 선택된 key 토큰들 $S_t$에 대해서만 분포를 비교함
- 타깃 분포도 마찬가지로 전체 $p_t$ 중에서 top-k로 뽑힌 인덱스에 해당하는 부분만 select한 뒤 다시 정규화한 분포
- 이 단계에서는 모든 파라미터를 학습함(메인 모델 + 인덱서)
- 논문 설정: learning rate $7.3 \times 10^{-6}$, 쿼리당 2048개의 key-value 토큰 선택, 15000 steps, step당 128K 토큰 시퀀스 480개로 총 943.7B 토큰
인덱서 입력을 계산 그래프에서 detach 시켜서 별도로 최적화한다. 흐름을 보면 $h_t$ → 인덱서 → score → top-k 추출과 동시에 $c^{KV}$에서 인덱스 선택 → attention 계산 → 출력 → CE Loss 순서인데, $c^{KV}$에서 선택한 인덱스가 메인 attention 입력으로 쓰이기 때문에 CE Loss의 gradient가 인덱서 파라미터까지 흘러들어온다. 그걸 방지하기 위해 인덱서는 detach시켜서 별도로 업데이트한다. 결과적으로 인덱서는 $\mathcal{L}^I$로만, 메인 모델은 language modeling loss로만 학습된다.
코드 구현
수식 (3)과 (4)는 topk_idx를 넘기느냐 아니냐로 구분된다.
def indexer_alignment_loss(indexer_scores, main_attn_scores, topk_idx=None):
    """
    indexer_scores:   (B, T, S) — I_{t,:}
    main_attn_scores: (B, T, H, S) — 메인 어텐션의 헤드별 attention 확률/logit
    topk_idx: (B, T, k) 또는 None
        - None이면 수식 (3) dense warm-up 단계
        - 지정되면 수식 (4) sparse training 단계 (S_t로 범위 제한)
    """
    # 헤드에 대해 합산 후 L1 정규화 -> target distribution p_{t,:}
    p = main_attn_scores.sum(dim=2)                # (B, T, S)
    p = p / (p.sum(dim=-1, keepdim=True) + 1e-8)   # L1 normalize

    if topk_idx is not None:
        # 수식 (4): S_t로 범위를 좁혀서 gather 후 다시 정규화
        B, T, k = topk_idx.shape
        dev = topk_idx.device
        B_idx = torch.arange(B, device=dev).view(B, 1, 1).expand(B, T, k)
        T_idx = torch.arange(T, device=dev).view(1, T, 1).expand(B, T, k)
        p = p[B_idx, T_idx, topk_idx]
        p = p / (p.sum(dim=-1, keepdim=True) + 1e-8)
        I_sub = indexer_scores[B_idx, T_idx, topk_idx]
        log_q = F.log_softmax(I_sub, dim=-1)
    else:
        # 수식 (3): 전체 S에 대해
        log_q = F.log_softmax(indexer_scores, dim=-1)

    # KL(p || softmax(I)) — 인덱서 파라미터만 이 loss로 업데이트 (detach 필요)
    loss = F.kl_div(log_q, p, reduction='batchmean')
    return loss
전체 구조: MLA 위에 얹은 DSA
DeepSeek-V3.1-Terminus에서 continued training으로 이어가기 위해, DSA는 MLA 위에 얹어서 구현된다. 커널 레벨에서 각 key-value entry가 여러 쿼리에 공유되어야 효율적이기 때문에, core attention은 MQA 모드로 수행한다.
class DSAAttention(nn.Module):
    """
    MLA(Multi-head Latent Attention) 위에 DSA를 얹은 core attention.
    Figure 1 구조를 따름: MLA의 압축된 KV latent(c_s^{KV})를
    lightning indexer + top-k selector로 sparsify한 뒤, MQA 모드로 core attention 수행.
    """
    def __init__(self, d_model, d_latent, n_heads, d_head, k_select=2048):
        super().__init__()
        self.n_heads = n_heads
        self.d_head = d_head
        self.k_select = k_select

        # --- MLA 파트 ---
        self.q_down_proj = nn.Linear(d_model, d_latent, bias=False)     # c_t^Q
        self.q_up_proj = nn.Linear(d_latent, n_heads * d_head, bias=False)
        self.kv_down_proj = nn.Linear(d_model, d_latent, bias=False)    # c_s^{KV}
        self.kv_up_proj = nn.Linear(d_latent, n_heads * d_head, bias=False)
        # (RoPE 부분 등은 생략 — 핵심 로직에 집중)

        # --- DSA 파트 ---
        self.indexer = LightningIndexer(d_model, d_indexer=64, n_indexer_heads=4)
        self.selector = TopKSelector(k_select)

    def forward(self, h_t, h_s_all, causal_mask=None):
        """
        h_t:     (B, T, d_model) 쿼리 토큰 입력
        h_s_all: (B, S, d_model) 전체 시퀀스(캐시 포함) — key-value 소스
        """
        B, T, _ = h_t.shape

        # 1) MLA의 KV latent 압축
        # c_s^{KV}: (B, S, d_latent) — 이게 MLA가 실제로 캐싱하는 "잠재벡터"
        c_kv_all = self.kv_down_proj(h_s_all)

        # 2) Lightning Indexer로 스코어 계산
        I = self.indexer(h_t, h_s_all, causal_mask)      # (B, T, S)

        # 3) Top-k Selector로 각 쿼리별 선택된 위치 인덱스 획득
        topk_idx, topk_scores = self.selector.select(I)  # (B, T, k)
        k_sel = topk_idx.shape[-1]   # S < k_select 인 경우를 대비해 실제 k를 사용

        # 4) ★핵심★ MLA의 key-value 잠재벡터들만 모은 집합 {c_s}
        # c_kv_all: (B, S, d_latent) 에서, 쿼리 t마다 선택된 k개의 s 위치만 gather.
        # 즉 "{c_s | I_{t,s} in Top-k(I_{t,:})}" 를 실제로 구현하는 부분.
        B_idx = torch.arange(B, device=h_t.device).view(B, 1, 1).expand(B, T, k_sel)
        selected_c_kv = c_kv_all[B_idx, topk_idx]        # (B, T, k, d_latent)

        # 5) 선택된 latent만으로 MQA 모드 core attention 수행
        # 쿼리는 헤드별로 up-project
        c_q = self.q_down_proj(h_t)                      # (B, T, d_latent)
        q = self.q_up_proj(c_q).view(B, T, self.n_heads, self.d_head)

        # 선택된 latent를 헤드 차원으로 up-project (MQA: 모든 헤드가 같은 latent 공유)
        # (B, T, k, d_latent) -> (B, T, k, n_heads, d_head)
        kv = self.kv_up_proj(selected_c_kv).view(
            B, T, k_sel, self.n_heads, self.d_head)

        # attention score: 쿼리 t의 각 헤드 h가, 자신이 선택한 k개의 KV에만 attend
        # q: (B, T, H, d),  kv(key로 사용): (B, T, k, H, d)
        attn_logits = torch.einsum('bthd,btkhd->bthk', q, kv) / (self.d_head ** 0.5)
        attn_probs = F.softmax(attn_logits, dim=-1)      # (B, T, H, k)

        # value도 동일 latent에서 나옴 (MLA 특성상 k/v projection 공유 형태)
        # MLA의 계산 트릭에 의해 q @ kv를 해도 k가 반영되어 있고,
        # kv에 weighted sum을 해도 v가 반영되어 있음.
        out = torch.einsum('bthk,btkhd->bthd', attn_probs, kv)   # (B, T, H, d)
        out = out.reshape(B, T, self.n_heads * self.d_head)

        return out, topk_idx   # u_t
통찰 및 요약
Key의 shape이 4차원인 이유
각 쿼리 토큰 $t$마다 선택하는 top-k가 서로 다르기 때문이다. 그래서 key 쪽에 top_k 축이 하나 더 생긴다.
| 일반 attention | sparse attention (DSA) | |
|---|---|---|
| q | (B, T, H, D) | (B, T, H, D) |
| k | (B, T, H, D) | (B, T, top_k, H, D) |
| attn | (B, T, H, T) | (B, T, H, top_k) |
| 의미 | 모든 q, k 쌍에 대한 스코어 | 각 t마다 자기가 고른 top-k에 대해서만 스코어링 |
즉 각 쿼리 위치 $T$마다 각자 다른 k개를 gather한 결과라서 축이 하나 늘어난다.
이 형태는 일반적인 batched matmul로는 효율적으로 처리가 안 되기 때문에, 저자는 전용 sparse 커널을 따로 최적화했다고 밝히고 있다. 위 코드는 einsum으로 같은 계산을 표현한 것이라 동작은 하지만, 실제 대규모 학습에서의 효율은 전용 커널에서 나온다.
댓글남기기