MLA(Multi-head Latent Attention): DeepSeek-V2 논문정리
논문: DeepSeek-V2: A Strong, Economical, and Efficient Mixture-of-Experts Language Model
DeepSeek-V2 논문 중 MLA(Multi-head Latent Attention) 부분만 정리한 글입니다. 앞선 MQA & GQA 정리와 이어지는 내용이며, 코드는 PyTorch로 직접 구현한 MLA를 기준으로 설명합니다.
Abstract
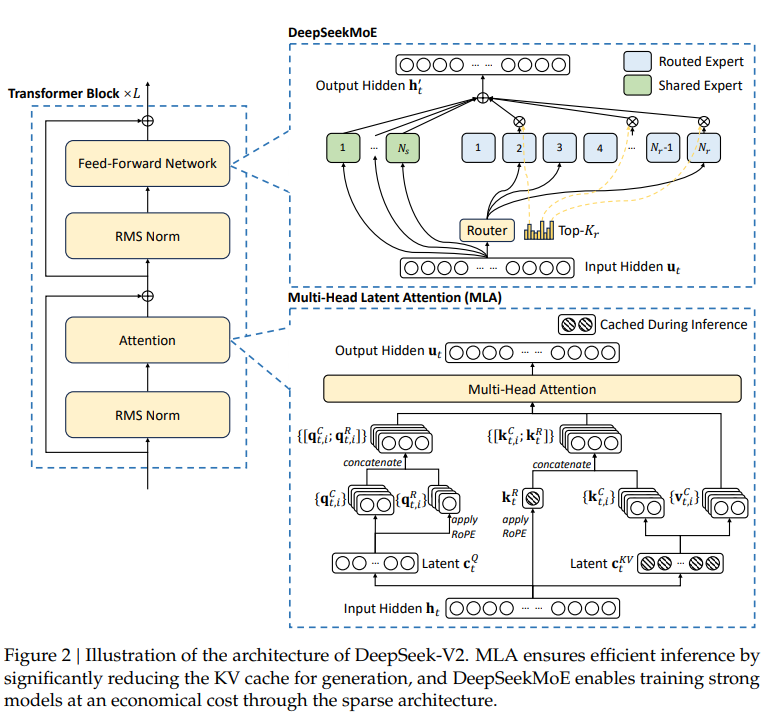
- DeepSeek-V2는 Multi-head Latent Attention(MLA)과 DeepSeekMoE를 포함한 혁신적인 아키텍처를 채택
- MLA는 Key-Value(KV) 캐시를 잠재 벡터(latent vector)로 대폭 압축하여 효율적인 추론을 보장하며, DeepSeekMoE는 희소 연산을 통해 경제적인 비용으로 강력한 모델을 학습할 수 있도록 함
- DeepSeek 67B 대비 학습 비용을 42.5% 절감하고, KV 캐시 크기를 93.3% 줄이며, 최대 생성 처리량을 5.76배 향상시킴
MLA
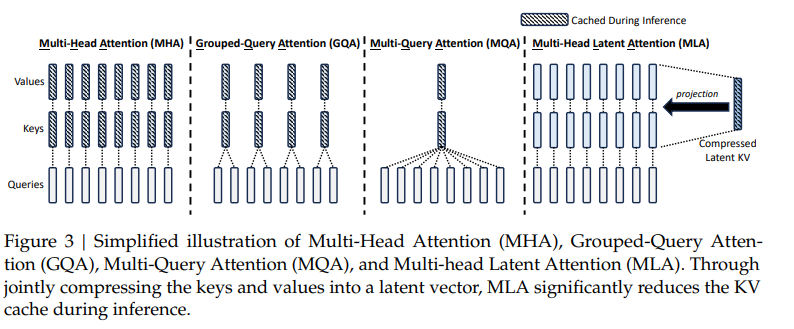
- MHA는 생성 과정에서 발생하는 과도한 KV 캐시가 추론 효율을 제한하는 병목 현상이 됨
- GQA와 MQA가 제안되었으나 성능은 MHA에 미치지 못함
- MLA는 low-rank key-value joint compression을 적용해서 우수한 성능을 달성하면서도 훨씬 적은 양의 KV 캐시를 필요로 함
Low-Rank Key-Value Joint Compression
MLA의 핵심은 key-value에 대한 저랭크 결합 압축을 통해 KV 캐시를 줄이는 것임.
\[\begin{aligned} \mathbf{c}_t^{KV} &= W^{DKV}\mathbf{h}_t, &(9)\\ \mathbf{k}_t^{C} &= W^{UK}\mathbf{c}_t^{KV}, &(10)\\ \mathbf{v}_t^{C} &= W^{UV}\mathbf{c}_t^{KV} &(11) \end{aligned}\]- (9) hidden state $\mathbf{h}_t$를 먼저 저차원 벡터로 압축함 ($W^{DKV}$, down-projection)
- (10) 필요할 때 key를 고차원 벡터로 복원함 ($W^{UK}$, up-projection)
- (11) value를 고차원 벡터로 복원함 ($W^{UV}$)
즉, hidden state를 down-projection하고 필요할 때 k, v를 up-projection하는 형식이다.
- (B, num_head, T, head_dim) 크기였던 KV 캐시가 (B, T, d_c) 크기의 latent 벡터 하나로 줄어듦. 캐시에는 $\mathbf{c}_t^{KV}$만 저장하면 됨
- 나중에 필요하면 $W^{UK}$, $W^{UV}$를 통해 고차원으로 변환 가능
- 디코딩 시 key, value를 명시적으로 계산할 필요가 없음 (아래 수식 전개 참고)
Key에 대한 수식 전개
$\mathbf{h}_t$와 $\mathbf{c}^{KV}$만 가지고 attention score를 바로 구할 수 있다.
\[\begin{aligned} score &= q_t^T k_t \\ k_t &= W^{UK} c_t^{KV} \\ q_t &= (W^{Q} h_t)^T \\ score &= (W^{Q} h_t)^T W^{UK} c_t^{KV} = h_t^T (W^{Q})^T W^{UK} c_t^{KV} \\ W'^{Q} &= (W^{Q})^T W^{UK} \\ score &= h_t^T W'^{Q} c_t^{KV} \end{aligned}\]$(W^{Q})^T W^{UK}$는 둘 다 학습이 끝난 가중치 행렬이므로, 미리 곱해서 $W’^{Q}$ 하나로 만들어 둘 수 있다(matrix absorption). 그러면 key를 복원하지 않고 latent $c^{KV}$와 바로 내적할 수 있다.
연산량 비교
- 압축 차원 = 512, 확장 차원 = 4096이라고 가정하면, T스텝일 때 key를 전부 복원하는 연산 비용은 (T × 512 × 4096)
- 트릭을 사용했을 때: $h_t^T W’^{Q}$는 쿼리 토큰 1개에 대해서만 딱 한 번 계산하고, 그 결과를 캐시된 $c^{KV}$들 각각과 내적. 따라서 (T × 512)
- Key를 아예 계산하지 않으니 메모리 R/W 속도가 빠름
Value에 대한 수식 전개
\(\begin{aligned} o_t &= \sum_i a_{t,i} v_i \\ v_i &= W^{UV} c_i^{KV} \\ out_t &= W^{O} o_t \\ out_t &= W^{O}\Big(\sum_i a_{t,i} W^{UV} c_i^{KV}\Big) \\ out_t &= \sum_i a_{t,i} W^{O} W^{UV} c_i^{KV} \\ W'^{O} &= W^{O} W^{UV} \\ out_t &= W'^{O}\Big(\sum_i a_{t,i} c_i^{KV}\Big) \end{aligned}\)
원래는 각 캐시된 토큰마다 $W^{UV} c_i^{KV}$로 value를 하나하나 복원한 뒤 가중합을 해야 했는데, 트릭을 사용하면 latent $c^{KV}$들을 먼저 가중합하고 그 결과를 딱 한 번 $W’^{O}$에 통과시키면 된다.
Query에 대한 저랭크 압축
추가로 Query에 대해서도 동일한 방식의 저랭크 압축을 적용한다.
\[\begin{aligned} \mathbf{c}_t^{Q} &= W^{DQ}\mathbf{h}_t, &(12)\\ \mathbf{q}_t^{C} &= W^{UQ}\mathbf{c}_t^{Q} &(13) \end{aligned}\]- (12) Query를 저차원 벡터로 압축
- (13) Query를 고차원 벡터로 복원
쿼리 압축은 KV 캐시 크기를 줄이는 데 기여하는 것이 아니라, 학습 과정에서의 activation 메모리를 줄이기 위한 것이 목적임.
예를 들어 hidden_dim=768, q_proj_dim=192일 때
- Q 압축 안 했을 때: hidden_dim × (num_head × head_dim) = 768 × 768
- Q 압축 했을 때: down = hidden_dim × q_proj_dim = 768 × 192, up = q_proj_dim × hidden_dim = 192 × 768
파라미터 수가 줄어들긴 하지만, 논문에서 강조하는 것은 학습 시 forward에서 저장해 둬야 하는 activation의 크기가 줄어든다는 점이다. 이로 인해 GPU 메모리 사용량이 감소한다.
Decoupled Rotary Position Embedding
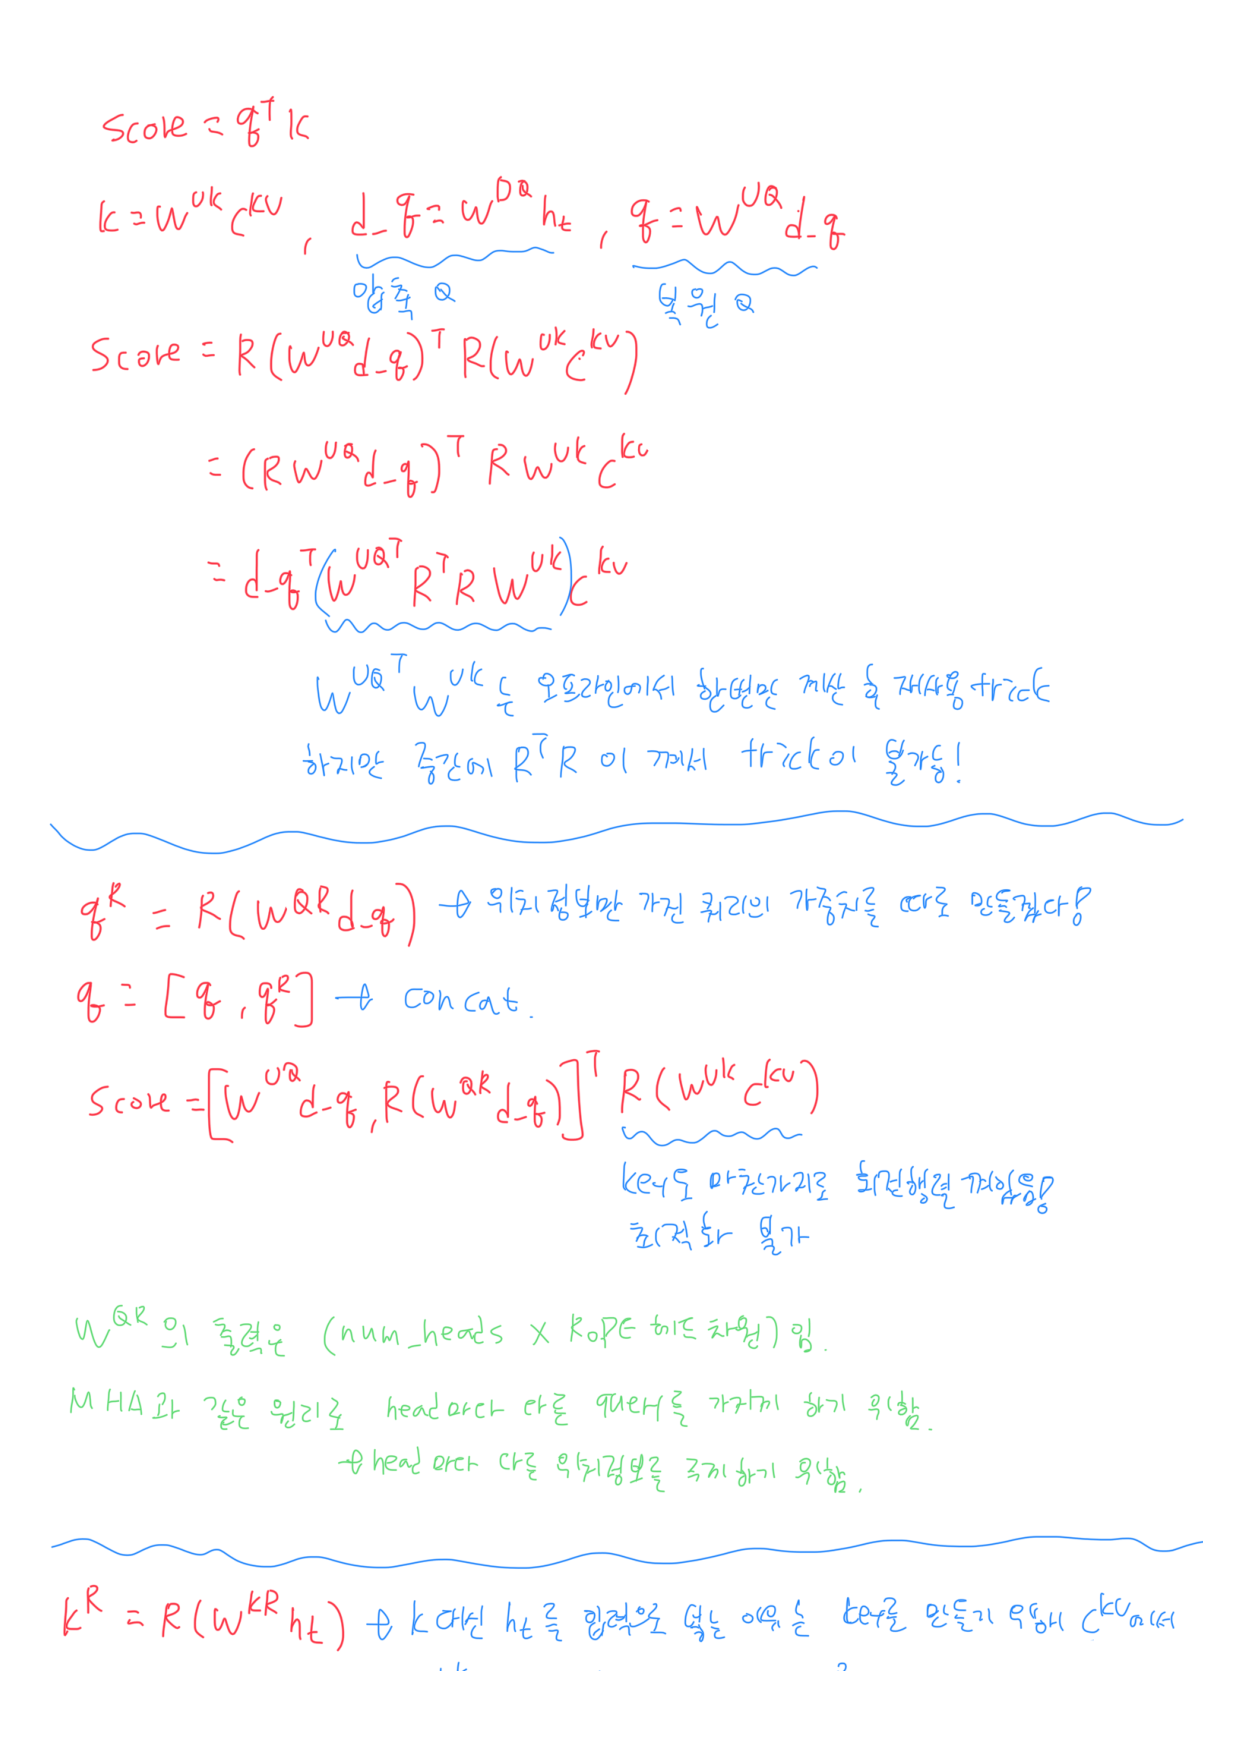
RoPE는 회전 행렬 $R$을 곱하는 방식으로 위치 정보를 주입한다. 그런데 RoPE를 그대로 사용하면 위에서 본 matrix absorption 최적화에 문제가 생긴다. 따라서 방식을 변경한다.
1. 왜 최적화에 문제가 있나?
- $q$ = 압축된 $d_q$를 $W^{UQ}$로 복원한 것
- $k$ = 압축된 $c^{KV}$에서 $W^{UK}$를 통해 복원한 것
수식을 보면 중간에 $R^T R$ 항이 끼어 있어서 $(W^{UQ})^T$와 $W^{UK}$를 미리 곱해 두는 최적화를 사용할 수 없다. $R$은 토큰 위치에 따라 달라지므로 매번 RoPE를 계산해서 다시 구해야 한다.
2. 쿼리에 대해 RoPE 적용 방법
\(\begin{aligned} q^{R} &= R(W^{QR} d_q) \\ q &= [q, q^{R}] \\ score &= [W^{UQ} d_q,\ R(W^{QR} d_q)]^T\, R(W^{UK} c^{KV}) \end{aligned}\)
- $q^R$ = 압축된 $d_q$를 새로운 행렬 $W^{QR}$에 통과시켜, 쿼리의 위치 정보만 가진 벡터를 따로 만듦
- attention 계산 시, 복원된 $q$와 $q^R$을 concat해서 사용
- $W^{QR}$의 출력 차원은 (num_heads × RoPE head_dim)임. MHA와 같은 원리로 head마다 독립적인 위치 정보를 주기 위함
3. 키에 대해 RoPE 적용 방법
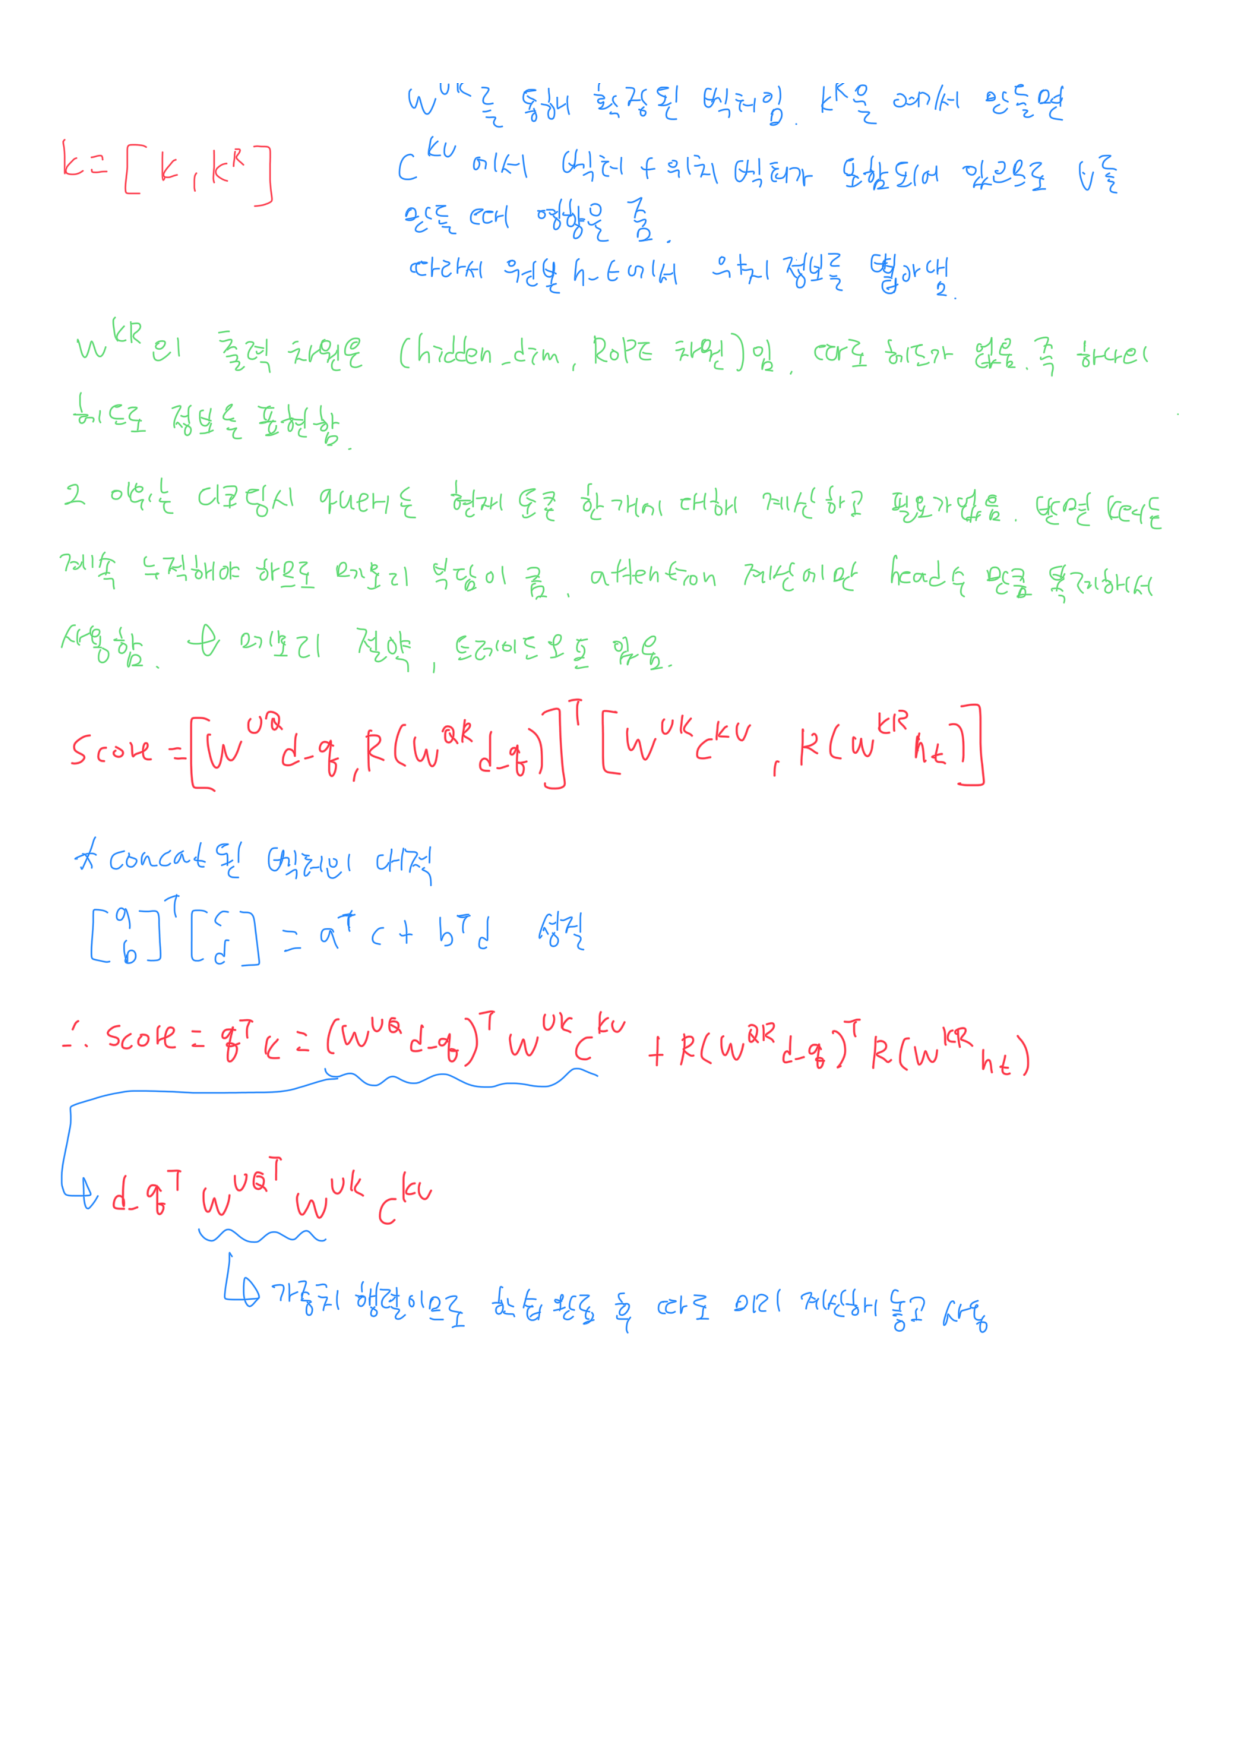
\(\begin{aligned} k^{R} &= R(W^{KR} h_t) \\ k &= [k, k^{R}] \\ score &= [W^{UQ} d_q,\ R(W^{QR} d_q)]^T\, [W^{UK} c^{KV},\ R(W^{KR} h_t)] \end{aligned}\)
- $k^R$ = 입력 $h_t$를 $W^{KR}$에 통과시켜 key에 대한 위치 정보를 가진 벡터를 만듦
- attention 계산 시, 복원된 $k$와 위치 벡터 $k^R$을 concat해서 사용
- $h_t$를 입력으로 넣는 이유: key는 $c^{KV}$에서 $W^{UK}$를 통해 만들어진 벡터인데, $k^R$을 이 벡터에서 만들게 되면 $c^{KV}$에 정보 + 위치 벡터가 포함되게 됨. 이게 V를 만들 때 영향을 줌. 따라서 원본 입력 $h_t$에서 위치 정보를 뽑아냄
- $W^{KR}$의 출력 차원은 (hidden_dim → RoPE head_dim)으로, 따로 헤드 없이 1개로 통일됨. 디코딩 시 query는 현재 들어온 토큰 1개에 대해서만 계산하면 되지만, key는 계속 누적해서 다음 계산 때 사용해야 하므로 메모리 부담이 큼. 따라서 attention 계산 시에만 head 수만큼 복제해서 계산하고, 캐시에는 1개 차원만 저장함. 메모리 절약이 목적이고 트레이드오프가 있음
4. 수식 전개
concat된 벡터의 내적은 $[a; b]^T [c; d] = a^T c + b^T d$ 성질을 따르므로
\[\begin{aligned} score &= (W^{UQ} d_q)^T W^{UK} c^{KV} + R(W^{QR} d_q)^T R(W^{KR} h_t) \\ (W^{UQ} d_q)^T &= d_q^T (W^{UQ})^T \\ score &= d_q^T (W^{UQ})^T W^{UK} c^{KV} + R(W^{QR} d_q)^T R(W^{KR} h_t) \end{aligned}\]첫 번째 항의 $(W^{UQ})^T W^{UK}$는 사전에 정의된 가중치 행렬이므로, 디코딩 시 미리 계산해서 사용함으로써 메모리 효율성을 향상시킴. 위치 정보는 두 번째 항(decoupled RoPE)이 따로 담당한다.
KV Cache 비교
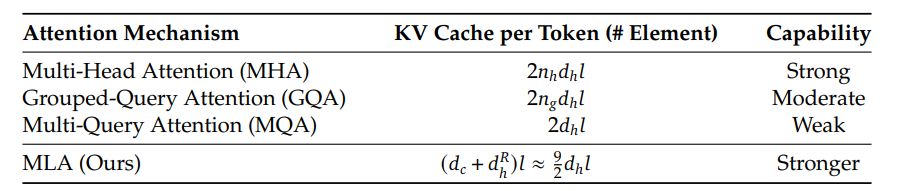
- MLA는 토큰당 $(d_c + d_h^R)\,l$ 만큼만 캐시하면 됨. 논문 설정에서는 $d_c = 4d_h$, $d_h^R = d_h/2$라 약 $\frac{9}{2} d_h l$로, GQA에서 그룹이 2.25개인 것과 같은 수준의 캐시 크기이면서 MHA보다 강한 성능을 보임
MLA 코드 구현
아래 구현은 hidden_dim=768, num_heads=96, KV 압축 차원 d_c=64, Query 압축 차원 d_c_q=32, decoupled RoPE 차원 d_h_r=16으로 설정한 예시다. 캐시에는 압축된 latent $c^{KV}$와 RoPE가 적용된 $k^R$만 저장한다.
먼저 RoPE 관련 헬퍼 함수다.
import math

import torch
import torch.nn as nn
import torch.nn.functional as F


def build_rope_cache(seq_len: int, dim: int, base: float = 10000.0, device=None):
    """위치별 cos/sin 캐시를 만든다. dim은 짝수여야 함."""
    assert dim % 2 == 0, "RoPE dim은 짝수여야 합니다."
    inv_freq = 1.0 / (base ** (torch.arange(0, dim, 2, device=device).float() / dim))
    t = torch.arange(seq_len, device=device).float()
    freqs = torch.einsum("i,j->ij", t, inv_freq)          # (seq_len, dim/2)
    emb = torch.cat([freqs, freqs], dim=-1)                # (seq_len, dim)
    return emb.cos(), emb.sin()                             # 각각 (seq_len, dim)


def rotate_half(x: torch.Tensor) -> torch.Tensor:
    """x의 뒷 절반을 앞으로, 앞 절반을 부호 반전해 뒤로 보낸다 (RoPE 표준 트릭)."""
    x1, x2 = x.chunk(2, dim=-1)
    return torch.cat([-x2, x1], dim=-1)


def apply_rope(x: torch.Tensor, cos: torch.Tensor, sin: torch.Tensor) -> torch.Tensor:
    """
    x:   (..., seq_len, dim)
    cos/sin: (seq_len, dim)  -- build_rope_cache의 출력
    RoPE(x) = x * cos + rotate_half(x) * sin
    """
    return x * cos + rotate_half(x) * sin
MLA 본체. 주석의 식 번호는 논문의 수식 번호다.
class MultiHeadLatentAttention(nn.Module):
    def __init__(self, hidden_dim=768, num_heads=96):
        super().__init__()
        assert hidden_dim % num_heads == 0

        self.hidden_dim = hidden_dim
        self.num_heads = num_heads
        self.head_dim = hidden_dim // num_heads # 8
        self.d_c = 64   # KV 압축 차원
        self.d_c_q = 32 # 쿼리 압축 차원
        self.d_h_r = 16 # 헤드당 decoupled RoPE 차원

        # q도 압축버전
        self.W_DQ = nn.Linear(hidden_dim, self.d_c_q, bias=False)   # c_t^Q = W_DQ h_t
        self.W_UQ = nn.Linear(self.d_c_q, num_heads * self.head_dim, bias=False)    # q_t^C = W_UQ c_t^Q

        # ---- K, V는 오직 latent를 거쳐서만 생성됨. k_proj, v_proj가 없음. ----
        self.W_DKV = nn.Linear(hidden_dim, self.d_c, bias=False)    # c_t^{KV} = W_DKV h_t
        # k, v를 다시 hidden_dim으로 up-projection
        self.W_UK = nn.Linear(self.d_c, self.num_heads * self.head_dim, bias=False) # k_t^C = W^{UK} c_t^{KV}
        self.W_UV = nn.Linear(self.d_c, self.num_heads * self.head_dim, bias=False) # v_t^C = W^{UV} c_t^{KV}

        # 식 14: decoupled query
        self.W_QR = nn.Linear(self.d_c_q, num_heads * self.d_h_r, bias=False)   # q_t^R = RoPE(W_QR c_t^Q)

        # 식 15: decoupled key
        self.W_KR = nn.Linear(hidden_dim, self.d_h_r, bias=False)   # k_t^R = RoPE(W_KR h_t)

        # ---- 출력 projection ----
        # weight shape: (num_heads * head_dim, hidden_dim) = (768, 768)
        self.W_O = nn.Linear(num_heads * self.head_dim, hidden_dim, bias=False)  # (768, 768)

        cos, sin = build_rope_cache(4096, self.d_h_r)   # (seq_len, dim=d_h_r)
        self.register_buffer("rope_cos", cos, persistent=False)
        self.register_buffer("rope_sin", sin, persistent=False)

        # ---- 파라미터 수 비교 ----
        # 기존 MHA의 K,V projection:
        #   k_proj + v_proj = 768*768 + 768*768 = 1,179,648
        #
        # MLA의 K,V 경로:
        #   W_DKV : 768*64 = 49,152
        #   W_UK  : 64*768 = 49,152
        #   W_UV  : 64*768 = 49,152
        #   W_KR  : 768*16 = 12,288   (decoupled RoPE key, MHA엔 없는 추가 비용)
        #   합계             159,744   <- MHA 대비 약 1/7
        #
        # ※ 진짜 이득은 "토큰당 KV 캐시 크기":
        #   MHA : 2 * num_heads * head_dim = 2*768   = 1,536 / token
        #   MLA : d_c + d_h_r              = 64 + 16 =    80 / token   (약 1/19)

    def forward(self, x, use_cache: bool = False, kv_cache=None):
        # 학습/프리필: kv_cache is None, T_new == T_total
        # 디코딩: kv_cache에 과거 latent가 들어있고, T_new(보통 1) < T_total
        B, T_new, _ = x.shape
        device = x.device

        past_len = 0 if kv_cache is None else kv_cache["c_kv"].size(1)
        T_total = past_len + T_new

        # ============= down-projection : 새 토큰만 =============
        c_kv_new = self.W_DKV(x)    # (B, T_new, d_c=64)   -> KV 압축(식9)
        c_q      = self.W_DQ(x)     # (B, T_new, d_c_q=32) -> Query 압축(식12)

        # ============= decoupled RoPE : 새 토큰만, 절대위치 past_len..T_total =============
        cos = self.rope_cos[past_len:T_total].to(device)   # (T_new, d_h_r)
        sin = self.rope_sin[past_len:T_total].to(device)   # (T_new, d_h_r)

        q_R = self.W_QR(c_q).view(B, T_new, self.num_heads, self.d_h_r)      # (B, T_new, 96, 16)
        q_R = apply_rope(q_R.transpose(1, 2), cos, sin).transpose(1, 2)      # 헤드별 각각 적용 -> 식 14

        k_R_new = apply_rope(self.W_KR(x), cos, sin)                         # (B, T_new, 16) -> 식 15

        # ============= cache 갱신 : 압축 latent + post-RoPE k_R 만 저장 =============
        if kv_cache is not None:
            c_kv = torch.cat([kv_cache["c_kv"], c_kv_new], dim=1)   # (B, T_total, d_c)
            k_R  = torch.cat([kv_cache["k_R"],  k_R_new],  dim=1)   # (B, T_total, d_h_r)
        else:
            c_kv, k_R = c_kv_new, k_R_new
        new_cache = {"c_kv": c_kv, "k_R": k_R} if use_cache else None

        # ============= up-projection : Q는 T_new, K/V는 T_total =============
        q_C = self.W_UQ(c_q).view(B, T_new,   self.num_heads, self.head_dim)  # (B, T_new,  96, 8) -> 식13
        k_C = self.W_UK(c_kv).view(B, T_total, self.num_heads, self.head_dim) # (B, T_total, 96, 8) -> 식10
        v_C = self.W_UV(c_kv).view(B, T_total, self.num_heads, self.head_dim) # (B, T_total, 96, 8) -> 식11

        # k_R은 head 차원이 없으므로 broadcast해서 모든 head에 동일하게 붙여준다
        k_R_expand = k_R.unsqueeze(2).expand(B, T_total, self.num_heads, self.d_h_r)  # (B, T_total, 96, 16)

        q = torch.cat([q_C, q_R],        dim=-1)   # (B, T_new,   96, head_dim + d_h_r = 24)
        k = torch.cat([k_C, k_R_expand], dim=-1)   # (B, T_total, 96, head_dim + d_h_r = 24)
        v = v_C                                    # (B, T_total, 96, head_dim = 8)

        # ============= 식 18: Attention 연산 =============
        q = q.transpose(1, 2)   # (B, 96, T_new,   24)
        k = k.transpose(1, 2)   # (B, 96, T_total, 24)
        v = v.transpose(1, 2)   # (B, 96, T_total, 8)

        scale = 1.0 / math.sqrt(self.head_dim + self.d_h_r)
        attn_scores = torch.matmul(q, k.transpose(-1, -2)) * scale   # (B, 96, T_new, T_total)

        # 일반화된 causal mask (T_q != T_k 대응: 프리필/디코딩/청크드 프리필 모두 처리)
        T_q, T_k = attn_scores.shape[-2], attn_scores.shape[-1]
        causal_mask = torch.triu(
            torch.full((T_q, T_k), float("-inf"), device=device), diagonal=T_k - T_q + 1
        )
        attn_scores = attn_scores + causal_mask

        attn_probs = torch.softmax(attn_scores, dim=-1)
        o = torch.matmul(attn_probs, v)   # (B, 96, T_new, 8)

        # ============= 식 19: head 합치고 출력 projection =============
        o = o.transpose(1, 2).contiguous().view(B, T_new, self.num_heads * self.head_dim)
        u = self.W_O(o)

        if use_cache:
            return u, new_cache
        return u
학습 시와 디코딩 시의 흐름
학습 시: T는 seq_len이고 배치 내 T가 모두 동일. Causal mask 사용.
- x = (B, T, hidden_dim)
W_DQ통과 → (B, T, d_c_q)로 Query 압축 →W_UQ로 복원 → (B, num_head, T, head_dim)- k_proj, v_proj를 통과하는 대신
W_DKV를 통해 KV 압축 → (B, T, d_c) - 압축 KV를
W_UK,W_UV에 통과 → (B, T, hidden_dim) → k, v를 (B, num_head, T, head_dim)으로 reshape - 학습 시에는 Q, K 길이가 같으므로 표준 causal mask를 사용해서 attention 연산
- (B, T, num_head × head_dim = hidden_dim)으로 reshape →
W_O통과 → (B, T, hidden_dim)
디코딩 시: 학습 때와 T가 다름. 첫 입력(prefill)이 T=10이면 이후 디코딩 시 T=1. 캐시에는 압축된 latent만 저장.
- 첫 입력 x = (1, 10, hidden_dim) → 압축 → 이전 캐시가 없으므로 그대로 사용 (1, 10, d_c) → up-projection → attention (Q, K 길이 같으므로 causal mask 사용) → 출력
- 다음 토큰 x = (1, 1, hidden_dim) → 압축 → 이전 캐시 (1, 10, d_c)와 cat → (1, 11, d_c) →
W_UK,W_UV로 up-projection → (1, num_head, 11, head_dim) - q = (1, num_head, 1, head_dim + d_h_r), K = (1, num_head, 11, head_dim + d_h_r)로 attention 연산 (새 토큰 1개가 과거 전체를 보므로 mask 불필요) →
W_O통과 → 출력 - 계속 반복. 캐시는 (1, T, d_c)와 (1, T, d_h_r)만 커짐
위 코드에서는 torch.triu(..., diagonal=T_k - T_q + 1)로 만든 일반화된 causal mask를 써서, prefill(T_q = T_k)과 decoding(T_q = 1)을 하나의 코드로 처리한다.
Decoupled RoPE 수식 정리 (손필기)
Decoupled RoPE 부분을 직접 손으로 전개해 본 노트다. 위 “Decoupled Rotary Position Embedding” 섹션의 수식 1~4번 전개 과정을 그대로 따라간다.
댓글남기기