Interleaved Pipeline Parallelism과 BitPipe 논문정리
논문: BitPipe: Bidirectional Interleaved Pipeline Parallelism for Accelerating Large Models Training
파이프라인 병렬화의 버블 문제부터 시작해, 인터리브드 방식과 양방향 방식을 결합한 BitPipe까지 정리했습니다.
Background
분산 학습 방식은 크게 세 가지로 나뉜다.
- 데이터 병렬화: 이상적인 속도 향상을 가능하게 하지만, 단일 디바이스의 용량을 초과하는 대규모 모델 앞에서는 한계가 있다
- 모델 병렬화: 모델 가중치를 여러 디바이스에 분산시켜 디바이스당 메모리 사용량을 줄여주지만 심각한 자원 활용 저하 문제가 있다
- 파이프라인 병렬화: 하나의 배치를 더 작은 마이크로배치로 나누고 모델을 파이프라인 내 여러 스테이지로 분할하여, 서로 다른 마이크로배치가 여러 디바이스에서 동시에 실행될 수 있게 한다
파이프라인 병렬화는 다시 두 가지로 나뉜다.
- 동기식: iteration이 끝날 때마다 주기적으로 flush하여 디바이스 유휴 시간(버블)이 발생한다
- 비동기식: 가중치 업데이트를 지연시킴으로써 flush를 완전히 없애지만, 모델 성능이 저하된다
flush: 하나의 iteration 안에 넣은 배치들이 순전파, 역전파를 모두 끝마쳐서 파이프라인 안에 처리 중인 것이 하나도 남지 않은 상태로 비워내는 것.
동기식은 flush를 하기 때문에 버블이 필연적으로 발생하고, 비동기식은 flush를 하지 않기 때문에 버블이 없다. 대신 가중치나 그래디언트를 여러 버전으로 보관하는 식으로 보완하며, 그 결과 성능이 저하된다.
이 논문은 동기식 파이프라인 병렬화를 다룬다. 초기 동기식 방식은 파이프라인에 동시에 존재하는 배치 수를 늘려 파이프라인 버블을 줄이는 데 초점을 맞췄고, 그 결과로 최대 활성화 메모리 요구량이 증가했다. 이후 1F1B 스케줄의 성공에 힘입어 연구자들은 메모리 효율적인 방식들을 제안했다.
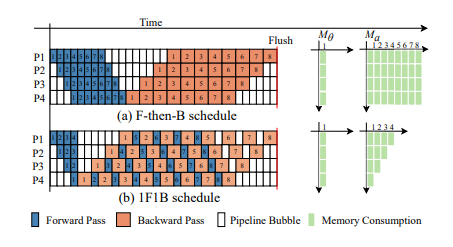
F-then-B는 순전파를 전부 끝낸 뒤 역전파를 시작하므로 활성값 메모리가 마이크로배치 수만큼 쌓인다. 1F1B는 순전파 하나와 역전파 하나를 번갈아 수행해서 활성값 메모리를 일정하게 유지한다.
Abstract
최근의 방식들은 양방향 파이프라인 병렬화나 인터리브드 파이프라인 병렬화 방향으로 발전해왔다. 하지만 두 가지 문제가 있다.
- 서로 다른 디바이스에 걸친 파이프라인 내 연산 의존성 때문에 버블은 불가피하며, 기존 방식에서는 전체 시간의 50%가 파이프라인 플러시에 소요될 수 있다
- 양방향 파이프라인 병렬화는 파이프라인 버블을 줄이기 위해 추가적인 가중치 메모리와 데이터 병렬 통신을 필요로 하며, 인터리브드 파이프라인 병렬화는 추가 P2P 통신을 대가로 버블 크기를 줄인다
따라서 본 논문은 양방향 인터리브드 파이프라인 병렬화 기법인 BitPipe를 제안한다. 기여점은 세 가지다.
- 인터리브드 파이프라인과 양방향 파이프라인을 결합한 하이브리드 파이프라인 방식을 제안한다. 이 설계는 처리량을 향상시킬 뿐 아니라 메모리 사용에서도 조화로운 균형을 달성한다
- 디바이스 간 통신의 일부를 로컬 복사로 전환하는 V자형 스케줄과 즉시 그래디언트 동기화 방식을 도입하여 디바이스 간 통신을 줄인다
- 실험 결과, BitPipe는 GPT 계열 및 BERT 계열 모델에서 SOTA 동기식 파이프라인 방식 대비 반복당 종단 간 성능을 최대 1.28배 향상시킨다
인터리브드 vs 양방향 파이프라인
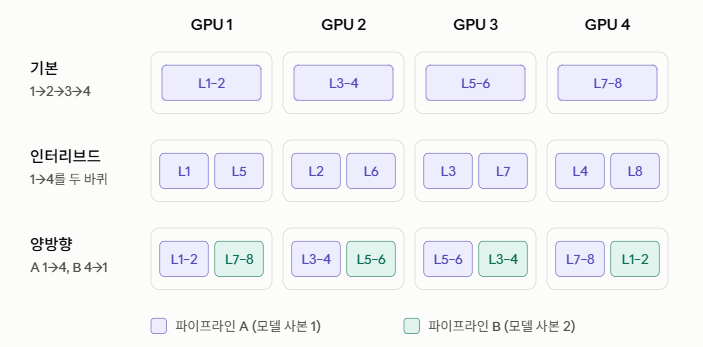
인터리브드 파이프라인
- 각 GPU가 연속된 층 덩어리 하나를 맡는 대신, 서로 떨어진 작은 덩어리 여러 개를 나눠 맡는다
- GPU 1이 L1과 L5를 함께 갖고 있으면, GPU 1에서 4까지 한 바퀴 돌며 L1~L4를 계산하고 다시 GPU 1로 돌아와 L5~L8을 계산한다
장점: GPU 한 장이 한 번에 처리하는 층이 절반으로 줄어 계산 시간이 짧아지므로, 다음 GPU가 기다리는 시간(버블)도 줄어든다.
단점: 스테이지 경계가 두 배로 늘어나 GPU 간 데이터를 주고받는 횟수도 늘고, GPU 4에서 GPU 1로 되돌아가는 통신이 추가된다.
양방향 파이프라인
- 모델 사본을 두 개 두고, 하나는 GPU 1에서 4 방향으로, 다른 하나는 GPU 4에서 1 방향으로 흐르게 하는 방식이다
- 단방향 파이프라인에서는 학습 초반에 GPU 4가 놀지만, 반대 방향 파이프라인이 있으면 GPU 4가 놀지 않고 바로 일을 시작할 수 있다
- 두 사본은 데이터 병렬처럼 동작하므로 반복이 끝날 때 그래디언트를 서로 맞춰 줘야 한다
단점: GPU마다 사본 두 개 분량의 층을 들고 있어야 하므로 파라미터 메모리가 늘어나고, 반복마다 두 사본 간 그래디언트 동기화 통신이 필요하다.
각 방식 비교
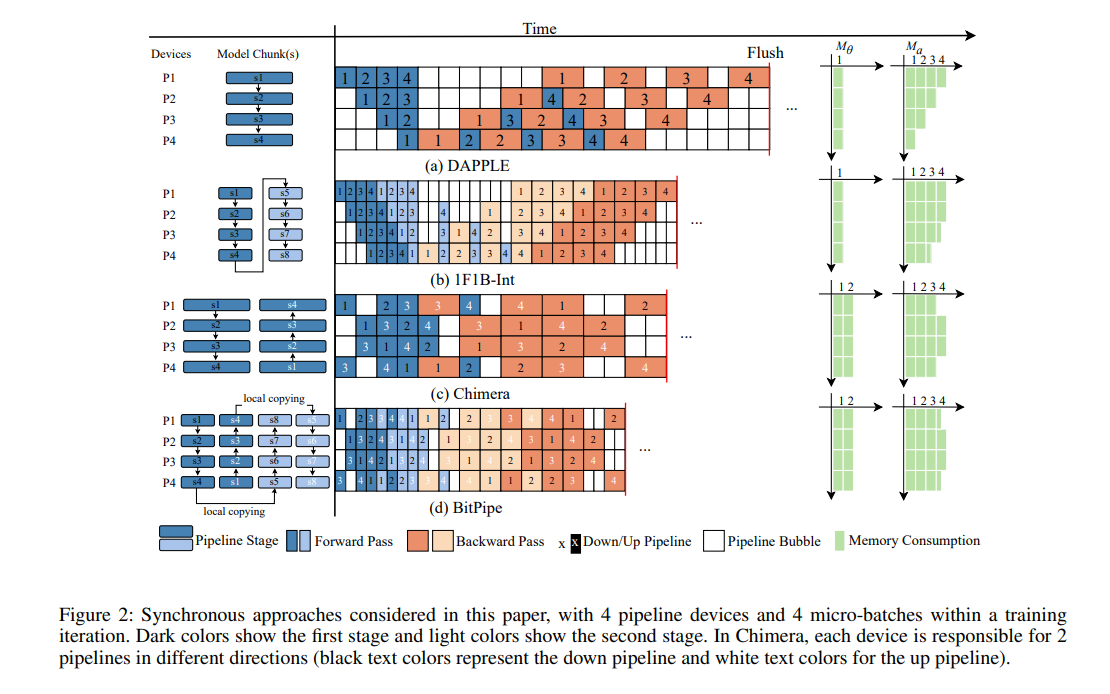
디바이스 4개, 마이크로배치 4개일 때의 스케줄을 비교한 그림이다. DAPPLE, 1F1B-Int, Chimera, BitPipe 순으로 버블(흰 칸)이 줄어드는 것을 볼 수 있다.
미니배치를 32, 마이크로배치를 8이라고 가정해 보자. 마이크로배치는 단순히 GPU를 더 효율적으로 사용하기 위해 작게 나눈 것이다. 기존의 큰 배치 대신 마이크로배치를 사용해도 수학적으로 최종 그래디언트는 미니배치를 사용한 것과 동일하다.
다만 달라지는 것은 그래디언트를 어디에 저장할지, 언제 계산되는지, GPU끼리 얼마나 통신해야 하는지다.
Method: Bidirectional Interleaved Pipelines
인터리브드 방식을 변형하여 버블 비율을 더 작게 만들고 활성화 메모리 사용을 균형 있게 만든다.
V자형 스케줄
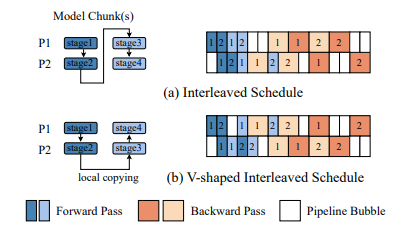
기존 인터리브드 방식은 GPU 1에서 4로 간 뒤, GPU 4에서 GPU 1로 돌아가서 다시 GPU 1에서 4를 도는 방식이다. 이때 GPU 4에서 1로 네트워크 통신이 일어난다.
V자형은 L5부터 방향을 꺾어서 GPU 1에서 4로 간 다음 4에서 1로 돌아오게 설계한다.
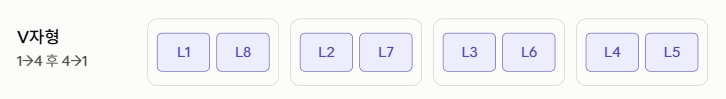
이렇게 하면 GPU 4가 L4와 L5를 함께 맡게 되니, 다른 GPU로 보낼 필요 없이 메모리 안에서 전달(로컬 복사)만 하면 된다.
두 파이프라인 병합
서로 반대 방향의 V자형 인터리브드 파이프라인 두 개를 매끄럽게 병합한다.
- 디바이스가 4개, 마이크로배치는 4개로 가정한다. 이는 모든 스테이지가 활성화 상태를 유지하기 위한 최솟값이다
- 각 파이프라인은 1F1B-Int 전략을 사용해 마이크로배치의 절반을 스케줄링한다 (마이크로배치가 짝수라고 가정)
- 두 파이프라인을 하나로 겹치면 충돌되는 부분 없이 온전히 병합이 가능하다. 디바이스가 짝수이면 병합 과정에서 충돌이 발생하지 않음이 보장된다
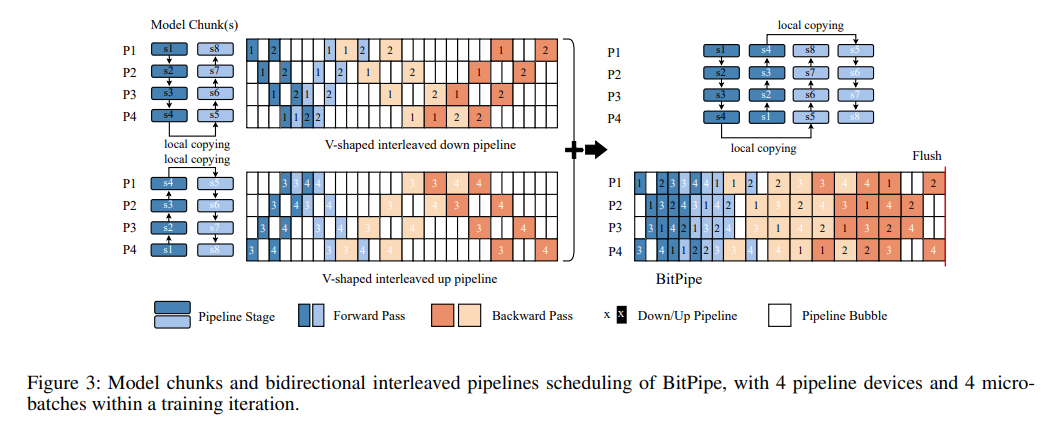
다른 방식들에 비해 버블 비율이 적고 활성값 메모리 사용도 더 균형 있게 동작한다. 다만 양방향 파이프라인 특성상 모델(또는 레이어) 사본 두 개를 들고 있어야 하기 때문에 가중치 메모리를 더 많이 잡아먹고, 두 사본 사이의 그래디언트 동기화 통신도 추가된다.
버블 비율과 메모리 소비
디바이스 $D=4$, 마이크로배치 $N=4$를 대입해 보면 다음과 같다.
| 방식 | 버블 비율 | 활성값 메모리 (최소~최대) |
|---|---|---|
| GPipe, DAPPLE | 3/7 ≈ 43% | GPipe 4Ma / DAPPLE 1~4Ma |
| 1F1B-Int | 3/11 ≈ 27% | 2.5~4Ma |
| Chimera | 2/8 = 25% | 3~4Ma |
| BitPipe | 2/14 ≈ 14% | 3.5~4Ma |
BitPipe가 버블 비율을 가장 크게 줄이면서 활성값 메모리는 다른 방식과 비슷한 수준으로 유지한다.
Method: 통신 분석과 최적화
두 종류의 통신
BitPipe에서 일어나는 통신은 두 종류다.
1. P2P 통신
- GPU 대 GPU의 1대1 통신이다
- 각 단계의 활성값(순전파)과 활성값 그래디언트(역전파)가 GPU 사이를 이동할 때 생기는 통신이다
- 단, 같은 GPU 안에서는 로컬 이동만 이루어진다
2. All-reduce 통신
- 여러 GPU가 각자 가진 값을 모아 합치거나 평균 낸 뒤, 그 결과를 모든 GPU가 똑같이 나눠 갖게 하는 통신 연산이다
- 같은 스테이지 내의 그래디언트를 하나로 모아 평균 낸 뒤, 각각의 GPU가 같은 값을 나눠 갖고 연산한다
- 각 GPU는 그래디언트 값에 따라 각각 업데이트한다
Eager gradient synchronization
All-reduce의 오버헤드를 줄이기 위해 eager gradient synchronization 기법을 사용한다.
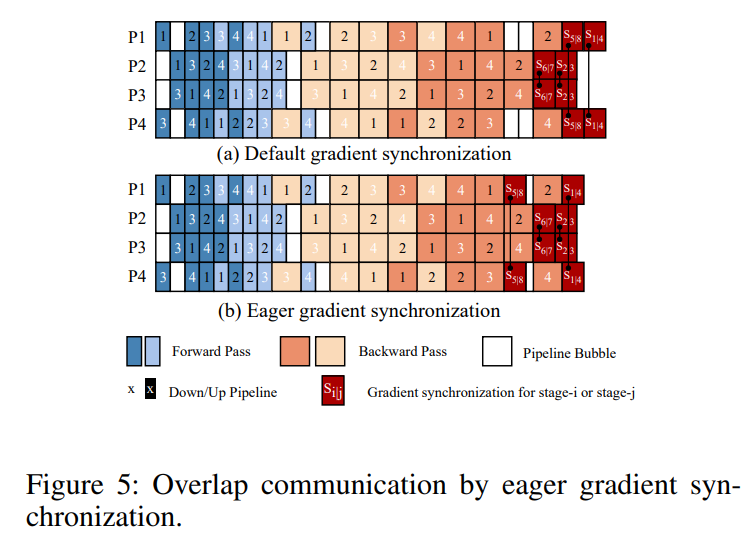
- 그림 (a)는 일반적인 기본 그래디언트 동기화 방식이다. 역전파가 끝난 뒤 스테이지별로 all-reduce를 시작한다
- 그림 (b)는 한 걸음 더 나아가서, 그래디언트가 준비된 스테이지는 파이프라인 버블을 활용해서 미리 all-reduce를 시작한다
디바이스 매핑
통신 효율을 높이기 위해 파이프라인 단계를 여러 장치에 매핑하는 방법도 탐색한다.
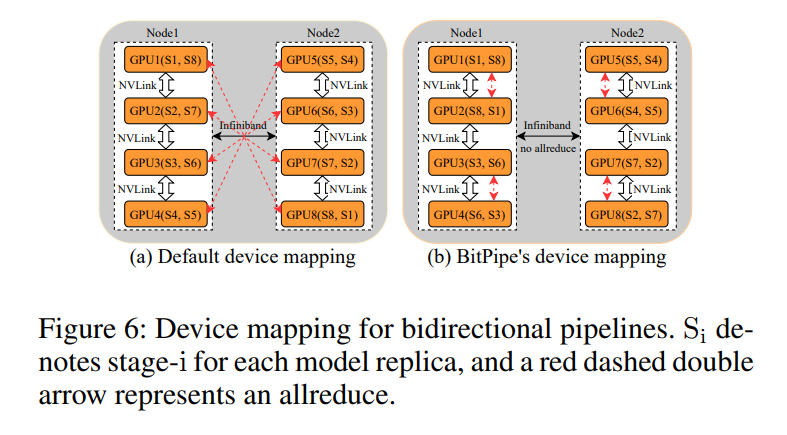
양방향 파이프라인에서 같은 스테이지의 사본들을 같은 노드에 배치하면, 무거운 그래디언트 all-reduce는 빠른 NVLink로 처리하고 상대적으로 가벼운 활성값 P2P 통신만 느린 InfiniBand를 거치게 되어 전체 통신 비용이 줄어든다.
Method: 마이크로 배치 확장
위에서는 디바이스 수 $D$와 마이크로배치 수 $N$이 같다고 가정했는데, 마이크로배치가 $D$보다 많을 때는 $N=D$의 스케줄을 기본 단위로 삼고 이 단위를 $K = N/D$개 이어붙인다.
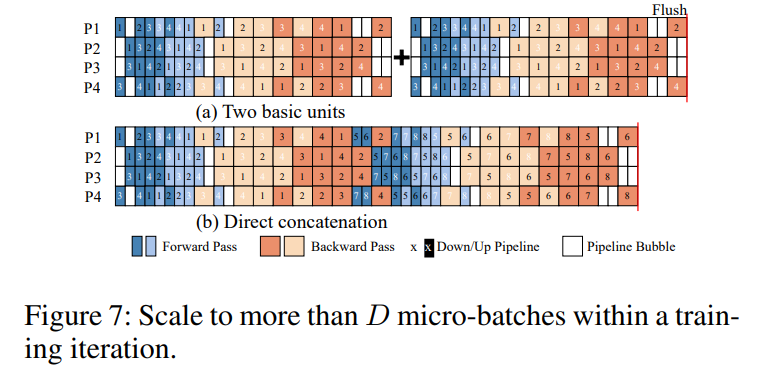
그냥 이어 붙이면 첫 번째 단위 끝에 남는 버블이 낭비되는데, 두 번째 단위의 처음 두 순전파를 그 자리로 당겨서 채운다.
통찰
이 논문은 인터리브드 파이프라인 방식의 통신 일부를 V자형 스케줄링을 통해 로컬 복사로 바꾸고, 양방향 파이프라인과 결합하여 버블 낭비와 all-reduce를 줄였다. 추가로 디바이스 매핑을 사용해서 all-reduce를 빠른 NVLink를 통해 처리하는 식으로 통신 부담을 줄였다.
댓글남기기