RoPE(Rotary Position Embedding): RoFormer 논문정리
논문: RoFormer: Enhanced Transformer with Rotary Position Embedding
위치 인코딩의 흐름(절대 → 상대 → 회전)을 따라가면서, RoPE의 수식 유도를 단계별로 정리하고 PyTorch 구현까지 확인합니다. 손으로 정리한 유도 과정은 맨 뒤에 첨부했습니다.
Abstract
- RoPE는 회전 행렬을 이용해 절대 위치 정보와 상대 위치 정보를 동시에 자연스럽게 self-attention에 녹여내는 인코딩 방법
- 시퀀스 길이에 유연해서 long-context에서도 잘 동작하며, 먼 거리의 토큰 간 상관관계는 자연스럽게 감소시킨다는 장점이 있음
Absolute Position Embedding
기존 인코딩 방식은 단어 임베딩 $x_i$에 포지션 벡터 $p_i$를 더한 뒤 선형변환 $W_{q,k,v}$를 사용해서 Q, K, V를 만들어낸다.
\[f_{t:t \in \{q,k,v\}}(x_i, i) := W_{t:t \in \{q,k,v\}}(x_i + p_i)\]$p_i$를 만드는 방식은 크게 두 가지다.
- 최대 시퀀스 길이 $L$만큼 위치 벡터를 미리 만들어 두고 학습 → 위치 벡터 학습 O
- 짝수 차원에는 sin, 홀수 차원에는 cos을 이용해 위치 벡터를 계산으로 생성 → 위치 벡터 학습 X
RoPE는 위치 정보를 사인/코사인 함수와 곱셈(회전)으로 반영한다는 점이 다르다. 더하는 게 아니라 곱한다.
Relative Position Embedding
RoPE로 가기 전에, 상대 위치를 다룬 기존 연구들을 먼저 본다.
[2018] 상대 거리를 K, V에 더하기
- Query에는 위치 정보를 넣지 않고, Key와 Value에만 위치 정보를 더함
- 이때 위치는 절대 위치 $m$, $n$이 아니라 상대 거리 $r = \mathrm{clip}(m-n,\ r_{min},\ r_{max})$를 사용
- 너무 멀리 떨어진 토큰 사이의 정확한 거리는 중요하지 않다고 가정하고 그냥 clip으로 잘라버림
- 절대 위치 대신 상대 거리를 학습 가능한 벡터로 만들어서 K, V에 더하는 방식
[2019] 내적을 네 항으로 분해하기
절대 위치 임베딩을 쓸 때 query와 key의 내적을 전개하면 네 개의 항으로 나뉜다. $x_{m}$, $x_{n}$은 입력 시퀀스 $m$, $n$번째의 토큰 임베딩이고, $p_{m}$, $p_{n}$은 각 위치의 위치 임베딩이다.
\[\begin{aligned} q_m &= W_q(x_m + p_m), \qquad k_n = W_k(x_n + p_n) \\ q_m^\top k_n &= \big(W_q(x_m + p_m)\big)^\top W_k(x_n + p_n) \\ &= (x_m + p_m)^\top W_q^\top W_k (x_n + p_n) \\ &= x_m^\top W_q^\top W_k x_n \quad (a) \\ &\quad + x_m^\top W_q^\top W_k p_n \quad (b) \\ &\quad + p_m^\top W_q^\top W_k x_n \quad (c) \\ &\quad + p_m^\top W_q^\top W_k p_n \quad (d) \end{aligned}\]각 항의 의미는 다음과 같다.
- (a) 토큰-토큰 관계
- (b) 토큰-위치 관계
- (c) 위치-토큰 관계
- (d) 위치-위치 관계
이 논문은 위 분해를 다음과 같이 바꾼다.
\[\begin{aligned} &x_m^\top W_q^\top W_k x_n \quad (a) \\ +\ &x_m^\top W_q^\top W_k p_{m-n} \quad (b) \\ +\ &u^\top W_q^\top W_k x_n \quad (c) \\ +\ &v^\top W_q^\top W_k p_{m-n} \quad (d) \end{aligned}\]- (b), (d)의 절대 위치 $p_n$을 상대 위치 $p_{m-n}$으로 교체
- (c), (d)의 $p_m$을 학습 가능한 고정 벡터 $u$, $v$로 교체. query 쪽에 있는 위치는 중요하지 않다고 판단한 것
- 추가로 Key에 대한 가중치도 분리하고, Value에는 위치 정보를 아예 넣지 않고 바로 $W_v$를 통과시킴
[2020] 이후의 변형들
변형 1: 복잡한 항들을 다 버리고 학습 가능한 편향 $b_{i,j}$ 하나만 더한다.
\[q_m^\top k_n = x_m^\top W_q^\top W_k x_n + b_{i,j}\]변형 2: 단어와 위치 쌍을 서로 다른 투영 행렬 $W$, $U$로 따로 모델링하자는 제안이다.
\[q_m^\top k_n = x_m^\top W_q^\top W_k x_n + p_m^\top U_q^\top U_k p_n + b_{i,j}\]변형 3: 두 토큰의 상대 위치 관계는 단어-위치 항만으로 충분히 표현 가능하다고 주장한다. 절대 위치 $p_m$, $p_n$을 전부 상대 위치 하나로 통일해서 교체한다.
\[q_m^\top k_n = x_m^\top W_q^\top W_k x_n + x_m^\top W_q^\top W_k \tilde{p}_{m-n} + \tilde{p}_{m-n}^\top W_q^\top W_k x_n\]Rotary Position Embedding
목표: 상대 거리에만 의존하는 함수 g
저자들의 목표는 아래 식을 만족하는 함수 $g$를 모델링하는 것이다. Query와 key를 만든 뒤 내적을 했을 때, 그 결과값이 $x_m$, $x_n$이라는 벡터와 $m-n$이라는 상대 거리에만 의존하는 함수 $g$를 찾아야 한다.
\[\langle f_q(x_m, m),\ f_k(x_n, n) \rangle = g(x_m,\ x_n,\ m-n)\]- $f_q$ = 임베딩 $x_m$과 위치 $m$을 받아서 만든 query 벡터
- $f_k$ = 임베딩 $x_n$과 위치 $n$을 받아서 만든 key 벡터
- $g$ = 임베딩 벡터 $x_m$, $x_n$과 그 둘의 상대 거리 $m-n$을 입력으로 받는 함수
복소수로 표현하기
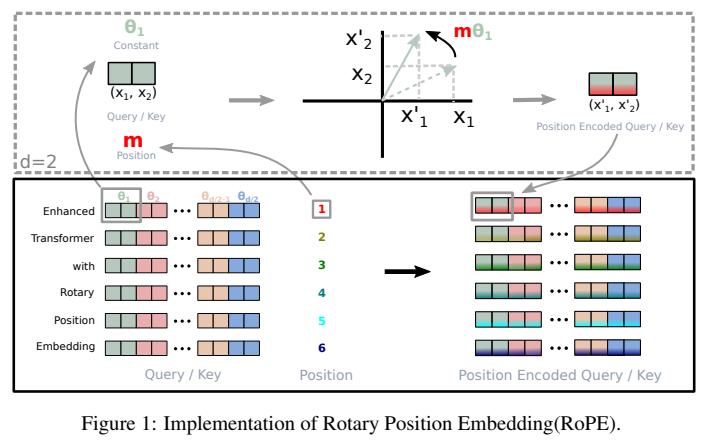
저자들이 제안한 형태는 다음과 같다. 복소수에 $e^{i\theta}$를 곱하는 것은 기하학적으로 그 벡터를 원점 중심으로 $\theta$만큼 회전시키는 것이다.
\[f_q(x_m, m) = (W_q x_m)\,e^{im\theta}, \qquad f_k(x_n, n) = (W_k x_n)\,e^{in\theta}\]복소수에서의 내적은 한쪽에 켤레 복소수를 취한 뒤 계산한다.
\[\langle f_q(x_m,m),\ f_k(x_n,n) \rangle = (W_q x_m)e^{im\theta} \times \overline{(W_k x_n)e^{in\theta}}\]오일러 공식으로 켤레를 정리하면 지수의 부호가 뒤집힌다.
\[\begin{aligned} e^{in\theta} &= \cos(n\theta) + i\sin(n\theta) \\ \overline{e^{in\theta}} &= \cos(n\theta) - i\sin(n\theta) = e^{-in\theta} \end{aligned}\]따라서 두 회전이 하나로 합쳐지면서, 각각의 절대 위치 $m$, $n$은 사라지고 $m-n$의 상대적 차이만 결과에 남는다.
\[g(x_m,\ x_n,\ m-n) = (W_q x_m)\,\overline{(W_k x_n)} \times e^{i(m-n)\theta}\]실수 벡터로 치환하기
복소수를 2차원 실수 벡터로 치환하면, 복소수에 $e^{i\theta}$를 곱하는 것과 실수에서 회전 행렬을 곱하는 것은 같다. 단계별로 따라가 보자.
1단계. 복소수를 2차원 실수 벡터로 치환
\[W_q x_m = \begin{pmatrix} a \\ b \end{pmatrix}, \qquad W_k x_n = \begin{pmatrix} c \\ d \end{pmatrix}\]2단계. 회전을 곱셈이 아닌 회전 행렬로 표현
\[R = \begin{pmatrix} \cos\theta & -\sin\theta \\ \sin\theta & \cos\theta \end{pmatrix}, \qquad f_q(x_m, m) = R_m \begin{pmatrix} a \\ b \end{pmatrix}, \qquad f_k(x_n, n) = R_n \begin{pmatrix} c \\ d \end{pmatrix}\]3단계. 내적을 켤레가 아닌 전치로 정의
복소수에서 내적은 켤레 복소수를 곱하지만, 실수에서는 전치로 정의된다.
\[\langle f_q(x_m,m),\ f_k(x_n,n) \rangle = \left[ R_m \begin{pmatrix} a \\ b \end{pmatrix} \right]^\top \left[ R_n \begin{pmatrix} c \\ d \end{pmatrix} \right]\]4단계. 전치 풀기
$R_m$과 $R_n$이 같이 붙어 있어야 상대 위치 $(m-n)$에 대응하는 하나의 회전 행렬이 된다. $(AB)^\top = B^\top A^\top$을 이용해 전치를 풀어서 식을 재정리한다.
\[\left[ R_m \begin{pmatrix} a \\ b \end{pmatrix} \right]^\top R_n \begin{pmatrix} c \\ d \end{pmatrix} = \begin{pmatrix} a \\ b \end{pmatrix}^\top R_m^\top R_n \begin{pmatrix} c \\ d \end{pmatrix}\]5단계. 회전 행렬의 성질
(A) 회전 행렬의 전치는 역회전과 같다.
\[R_m^\top = \begin{pmatrix} \cos m\theta & \sin m\theta \\ -\sin m\theta & \cos m\theta \end{pmatrix}\] \[R_{-m} = \begin{pmatrix} \cos(-m\theta) & -\sin(-m\theta) \\ \sin(-m\theta) & \cos(-m\theta) \end{pmatrix} = \begin{pmatrix} \cos m\theta & \sin m\theta \\ -\sin m\theta & \cos m\theta \end{pmatrix}\]$\cos(-\theta) = \cos\theta$, $\sin(-\theta) = -\sin\theta$이므로 두 식이 같다. 따라서 $R_m^\top = R_{-m}$이다.
(B) 회전 행렬끼리의 곱은 각도가 더해진다. 삼각함수 덧셈 공식을 적용하면 다음과 같다.
\[\begin{aligned} \cos(n-m)\theta &= \cos n\theta \cos m\theta + \sin n\theta \sin m\theta \\ \sin(n-m)\theta &= \sin n\theta \cos m\theta - \cos n\theta \sin m\theta \end{aligned}\] \[R_{-m} R_n = \begin{pmatrix} \cos(n-m)\theta & -\sin(n-m)\theta \\ \sin(n-m)\theta & \cos(n-m)\theta \end{pmatrix} = R_{n-m}\]6단계. 최종 실수 행렬 형태
\[\langle f_q(x_m, m),\ f_k(x_n, n) \rangle = \begin{pmatrix} a \\ b \end{pmatrix}^\top R_{n-m} \begin{pmatrix} c \\ d \end{pmatrix}\]결국 내적 결과에는 상대 거리 $n-m$에 대응하는 회전 행렬 하나만 남는다. 목표였던 식 $g(x_m, x_n, m-n)$을 만족한다.
코드로 옮길 때의 형태
실제 구현에서는 회전 행렬을 만들어 곱하지 않고, 아래 전개를 이용해 원소별 곱셈 두 번으로 처리한다.
\[R \begin{pmatrix} a \\ b \end{pmatrix} = \begin{pmatrix} a\cos\theta - b\sin\theta \\ a\sin\theta + b\cos\theta \end{pmatrix} = \begin{pmatrix} a \\ b \end{pmatrix}\cos\theta + \begin{pmatrix} -b \\ a \end{pmatrix}\sin\theta\]즉 원본 벡터에 $\cos$을 곱한 것과 두 원소를 뒤집고 앞쪽에 음수를 붙인 벡터에 $\sin$을 곱한 것을 더하면 된다. 뒤에 나오는 rotate_half가 정확히 $(-b, a)$를 만드는 함수다.
여기서 $a$, $b$는 $W_q x_m$의 출력이고 $c$, $d$는 $W_k x_n$의 출력이다. $\theta$는 사전에 값을 정해 놓고, 예를 들어 $x$가 (6, 128)이면 $a$ = (6, 64), $b$ = (6, 64) 두 개로 분리해서 계산한다. 기본적으로 홀수/짝수 인덱스로 나누고, 최근 논문에서는 길이별로 앞뒤 절반으로 자르기도 한다.
\[\langle f_q(x_m,m),\ f_k(x_n,n) \rangle = R_m (W_q x_m)^\top R_n (W_k x_n)\]코드 구현
회전각 테이블 만들기
각 차원 쌍마다 서로 다른 회전 속도 $\theta_i = \text{base}^{-2(i-1)/d}$를 쓰고, 위치 $m$을 곱해서 실제 회전각 $m\theta_i$를 만든다.
import torch
import torch.nn as nn
import math


class SinusoidalPositionEmbedding(nn.Module):
    def __init__(self, dim, base=10000.0):
        super().__init__()
        # theta_i = base^(-2(i-1)/d),  i=1,...,d/2
        # 세타 생성
        inv_freq = 1.0 / (base ** (torch.arange(0, dim, 2).float() / dim))  # (dim/2,)
        self.register_buffer("inv_freq", inv_freq)

    def forward(self, seq_len, device):
        positions = torch.arange(seq_len, device=device).float()   # (seq_len,)
        # 포지션에 대한 각도표를 만듦.
        freqs = torch.outer(positions, self.inv_freq.to(device))   # (seq_len, dim/2) = m*theta_i
        return freqs
인접 짝짓기 방식으로 RoPE 적용
논문 방식은 $(x_0, x_1)$, $(x_2, x_3)$처럼 인접한 원소끼리 짝을 지어 2차원 회전을 적용한다. rotate_half가 위에서 본 $(-b, a)$를 만들고, sin과 cos을 짝 구조에 맞게 각각 두 번씩 늘려서(interleave) 곱한다.
def rotate_half(x):
    # x: (..., dim)
    x1 = x[..., 0::2]   # 짝수 인덱스: x0, x2, x4, ...
    x2 = x[..., 1::2]   # 홀수 인덱스: x1, x3, x5, ...
    # [-x1, x0, -x3, x2, ...] 형태로 interleave해서 되돌림
    return torch.stack((-x2, x1), dim=-1).reshape_as(x)


def apply_rotary_position_embeddings(freqs, query_layer, key_layer, value_layer=None):
    sin, cos = freqs.sin(), freqs.cos()          # 각각 (seq_len, dim/2)

    # [θ1,θ2,...] -> [θ1,θ1,θ2,θ2,...]  인접 짝짓기 구조에 맞게 interleave
    sin_pos = torch.stack([sin, sin], dim=-1).reshape(sin.shape[0], -1)  # (seq_len, dim)
    cos_pos = torch.stack([cos, cos], dim=-1).reshape(cos.shape[0], -1)  # (seq_len, dim)

    # 논문 수식 열벡터(x1, x2)cosθ + 열벡터(-x2, x1)sinθ
    # (x1, x2) -> 그냥 입력 x, (-x2, x1)은 입력을 두개로 쪼개고 반전 후 -부호 붙임.
    query_layer = query_layer * cos_pos + rotate_half(query_layer) * sin_pos
    key_layer   = key_layer   * cos_pos + rotate_half(key_layer)   * sin_pos

    if value_layer is not None:
        value_layer = value_layer * cos_pos + rotate_half(value_layer) * sin_pos
        return query_layer, key_layer, value_layer
    return query_layer, key_layer
RoPE가 적용된 셀프 어텐션
Q, K를 평소대로 만든 뒤 회전만 추가로 적용하고, 그 뒤는 일반 어텐션과 완전히 같다. V에는 RoPE를 적용하지 않는다.
class RoFormerSelfAttention(nn.Module):
    def __init__(self, embed_dim, num_heads):
        super().__init__()
        self.num_heads = num_heads
        self.head_dim = embed_dim // num_heads

        self.W_q = nn.Linear(embed_dim, embed_dim, bias=False)
        self.W_k = nn.Linear(embed_dim, embed_dim, bias=False)
        self.W_v = nn.Linear(embed_dim, embed_dim, bias=False)
        self.W_o = nn.Linear(embed_dim, embed_dim, bias=False)

        self.pos_emb = SinusoidalPositionEmbedding(self.head_dim)

    def forward(self, x):
        batch, seq_len, embed_dim = x.shape

        # (1) 평범한 Q, K, V 계산
        q = self.W_q(x).view(batch, seq_len, self.num_heads, self.head_dim).transpose(1, 2)
        k = self.W_k(x).view(batch, seq_len, self.num_heads, self.head_dim).transpose(1, 2)
        v = self.W_v(x).view(batch, seq_len, self.num_heads, self.head_dim).transpose(1, 2)

        # (2) 위치별 회전각(m*theta) 테이블
        freqs = self.pos_emb(seq_len, x.device)   # (seq_len, head_dim/2)

        # (3) Q, K에 인접 짝짓기 방식으로 RoPE 적용 (V는 적용 안 함)
        q, k = apply_rotary_position_embeddings(freqs, q, k)

        # (4) 평범한 어텐션 계산
        scores = (q @ k.transpose(-2, -1)) / math.sqrt(self.head_dim)
        attn = torch.softmax(scores, dim=-1)
        out = attn @ v

        out = out.transpose(1, 2).contiguous().view(batch, seq_len, embed_dim)
        return self.W_o(out)
입력은 위치 정보가 전혀 없는 순수 임베딩을 그대로 넣으면 된다.
bs, seq_len, embed_dim = 2, 10, 1024
model = RoFormerSelfAttention(embed_dim=embed_dim, num_heads=16)
x = torch.randn(bs, seq_len, embed_dim)   # 위치 정보 없는 순수 임베딩
out = model(x)                            # RoPE가 자동으로 적용된 어텐션 결과
print(out.shape)                          # torch.Size([2, 10, 1024])
검증
위 구현이 실제로 논문의 성질을 만족하는지 두 가지를 확인해 본다.
torch.manual_seed(0)

dim = 8                                   # 검증용 head_dim
max_len = 16
pos_emb = SinusoidalPositionEmbedding(dim)
freqs_table = pos_emb(max_len, torch.device("cpu"))   # (max_len, dim/2) = m*theta_i

def apply_rope(vec, pos):
    """vec: (dim,) 한 벡터에 위치 pos의 RoPE 적용 -> (dim,)"""
    f = freqs_table[pos:pos + 1]                      # (1, dim/2)
    rotated, _ = apply_rotary_position_embeddings(f, vec.unsqueeze(0), vec.unsqueeze(0))
    return rotated[0]

# ---- 검증 1: (x0, x1) 쌍이 논문 회전 공식대로 계산되는가 ----
m = 3                                     # 확인할 위치
x = torch.randn(dim)

# 수동 계산: 첫 번째 쌍 (x0, x1), 회전각 = m * theta_0
theta0 = pos_emb.inv_freq[0].item()
ang = m * theta0
c, s = math.cos(ang), math.sin(ang)
x0, x1 = x[0].item(), x[1].item()
x0_manual = x0 * c - x1 * s
x1_manual = x1 * c + x0 * s

x_rot = apply_rope(x, m)
print(f"수동 계산: x0'={x0_manual:.5f}, x1'={x1_manual:.5f}")
print(f"함수 결과: x0'={x_rot[0].item():.5f}, x1'={x_rot[1].item():.5f}")

# ---- 검증 2: 상대 위치 성질 <f(q,m), f(k,n)> = g(q, k, m-n) ----
q = torch.randn(dim)
k = torch.randn(dim)

def rope_dot(pos_q, pos_k):
    return torch.dot(apply_rope(q, pos_q), apply_rope(k, pos_k)).item()

print(f"위치(0,1) 내적 = {rope_dot(0, 1):.6f}")   # 상대거리 -1
print(f"위치(5,6) 내적 = {rope_dot(5, 6):.6f}")   # 상대거리 -1
print(f"위치(0,3) 내적 = {rope_dot(0, 3):.6f}")   # 상대거리 -3
실행 결과는 다음과 같다.
수동 계산: x0'=-1.48417, x1'=0.50796
함수 결과: x0'=-1.48417, x1'=0.50796

위치(0,1) 내적 = 1.098421
위치(5,6) 내적 = 1.098421
위치(0,3) 내적 = 0.173762
- 검증 1: 함수 결과가 회전 공식을 손으로 계산한 값과 소수점까지 일치한다
- 검증 2: 절대 위치가 (0, 1)이든 (5, 6)이든 상대 거리가 같으면 내적이 완전히 동일하다. 상대 거리가 다른 (0, 3)에서는 값이 달라진다. 목표했던 $\langle f_q(x_m,m), f_k(x_n,n)\rangle = g(x_m, x_n, m-n)$ 성질이 그대로 성립한다
RoPE의 장점
- 위 수식의 성질에 따라 각 토큰의 절대적 위치는 사라지고 오직 둘 사이의 거리라는 정보만 남는다.
-
여러 개의 서로 다른 $\theta$(빠른 회전 / 느린 회전)를 섞어 쓰다 보니, 수학적으로 상대 거리 $\lvert m-n \rvert$이 커질수록 두 토큰의 어텐션 스코어 기댓값은 점점 작아지는 경향을 보인다. 가까운 단어끼리 더 강하게 연관되고 멀리 떨어진 단어는 상대적으로 관련성이 약해진다.
-
절대 위치 인코딩은 학습 때 $L$까지의 위치 벡터만 존재해서 그보다 긴 문장이 들어오면 처리를 못 한다. RoPE는 각도 계산식이라 학습 길이에 상관없이 더 긴 위치도 계산할 수 있다.
수식 정리 (손필기)
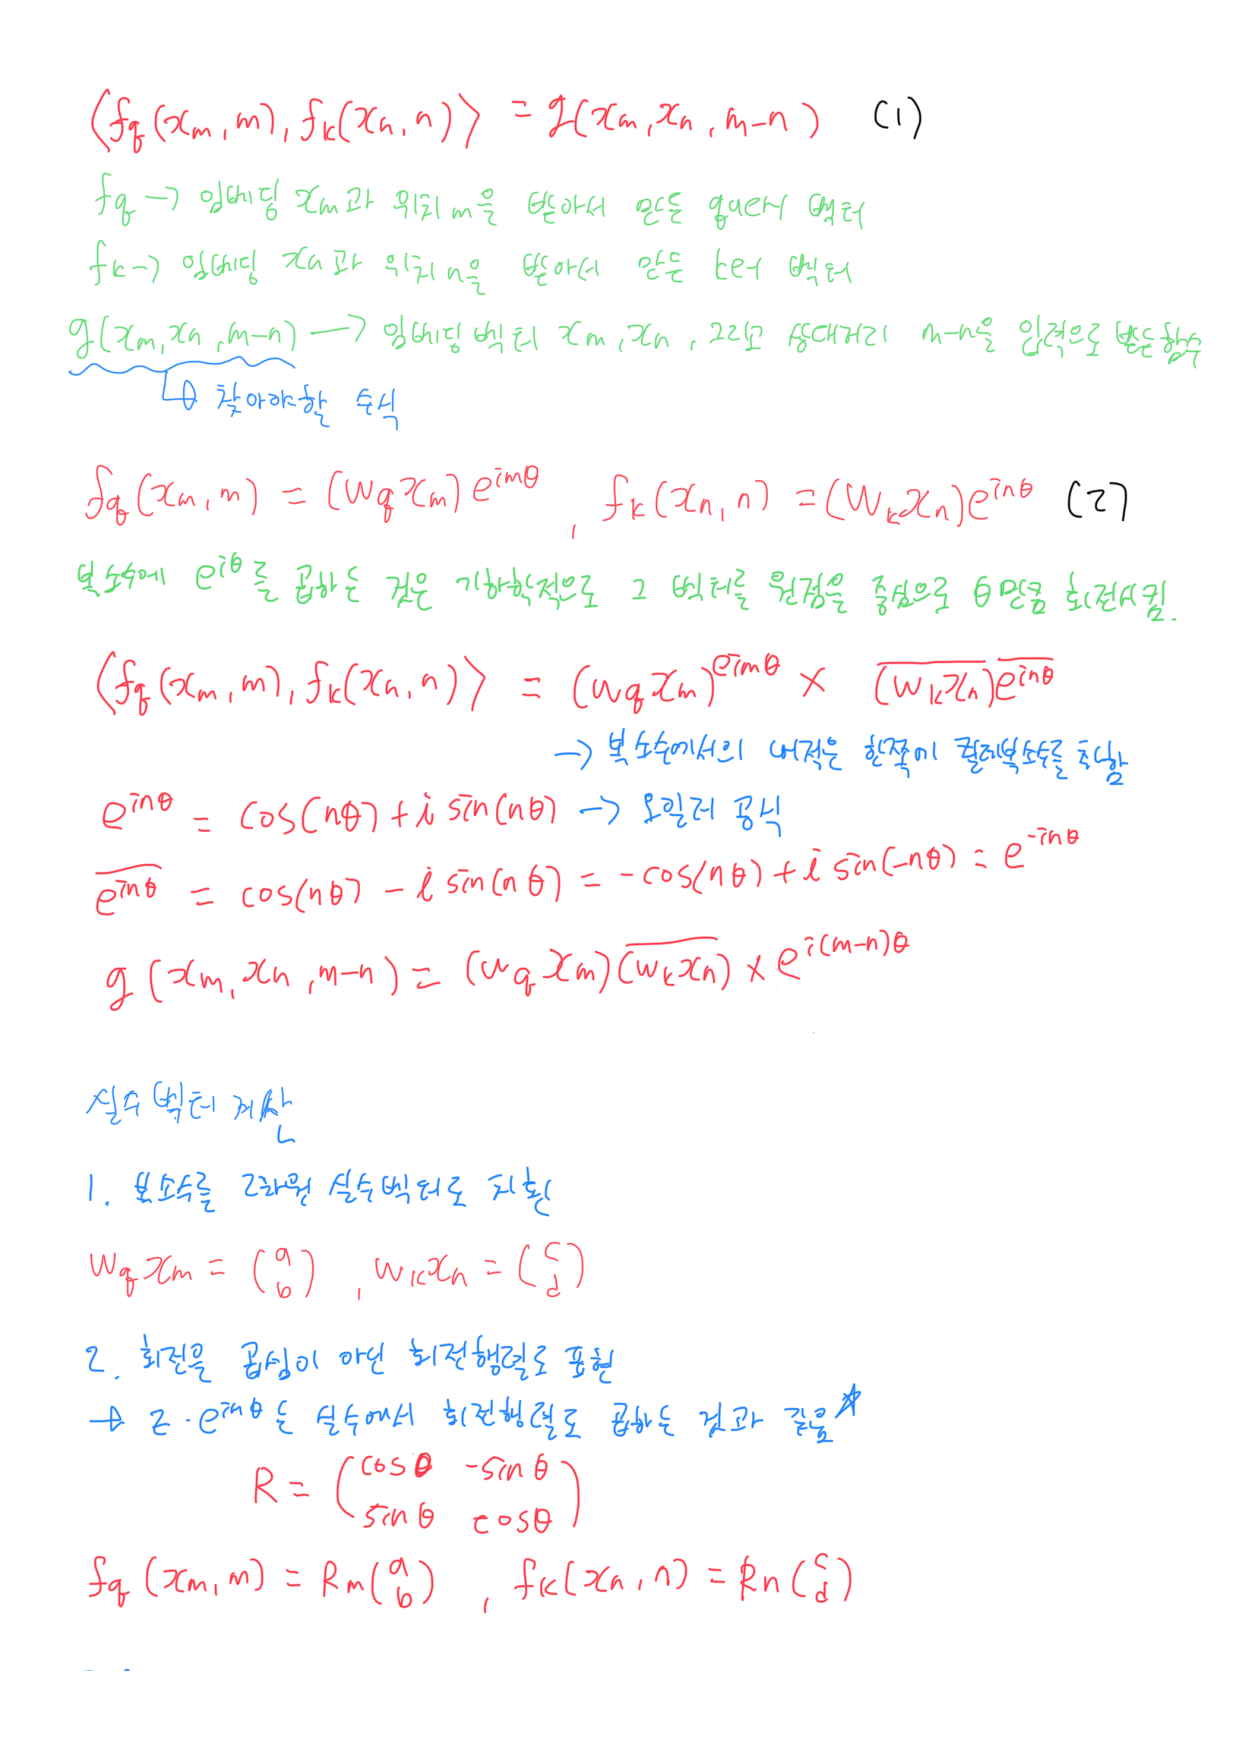
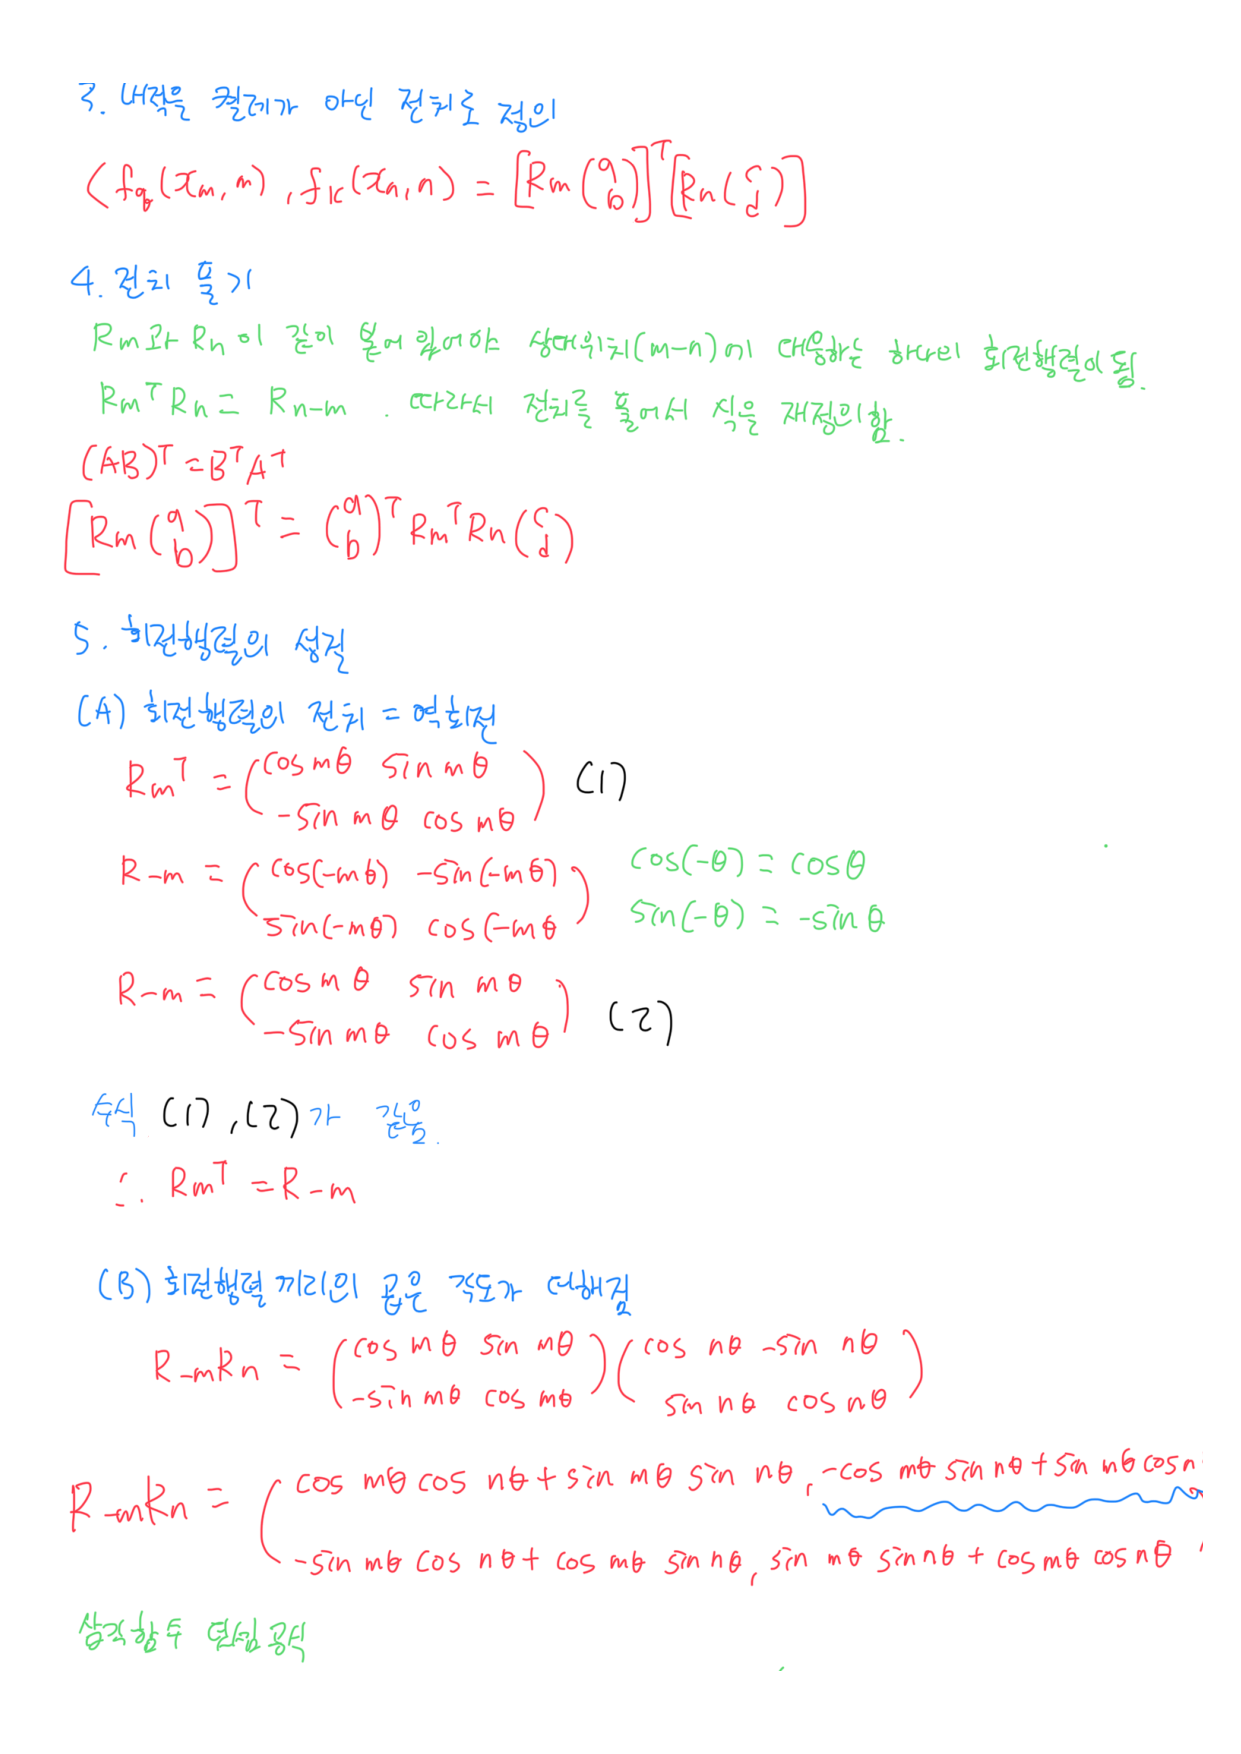
위 유도 과정을 직접 손으로 정리한 노트다. 본문의 “Rotary Position Embedding” 섹션과 같은 순서로 전개된다.
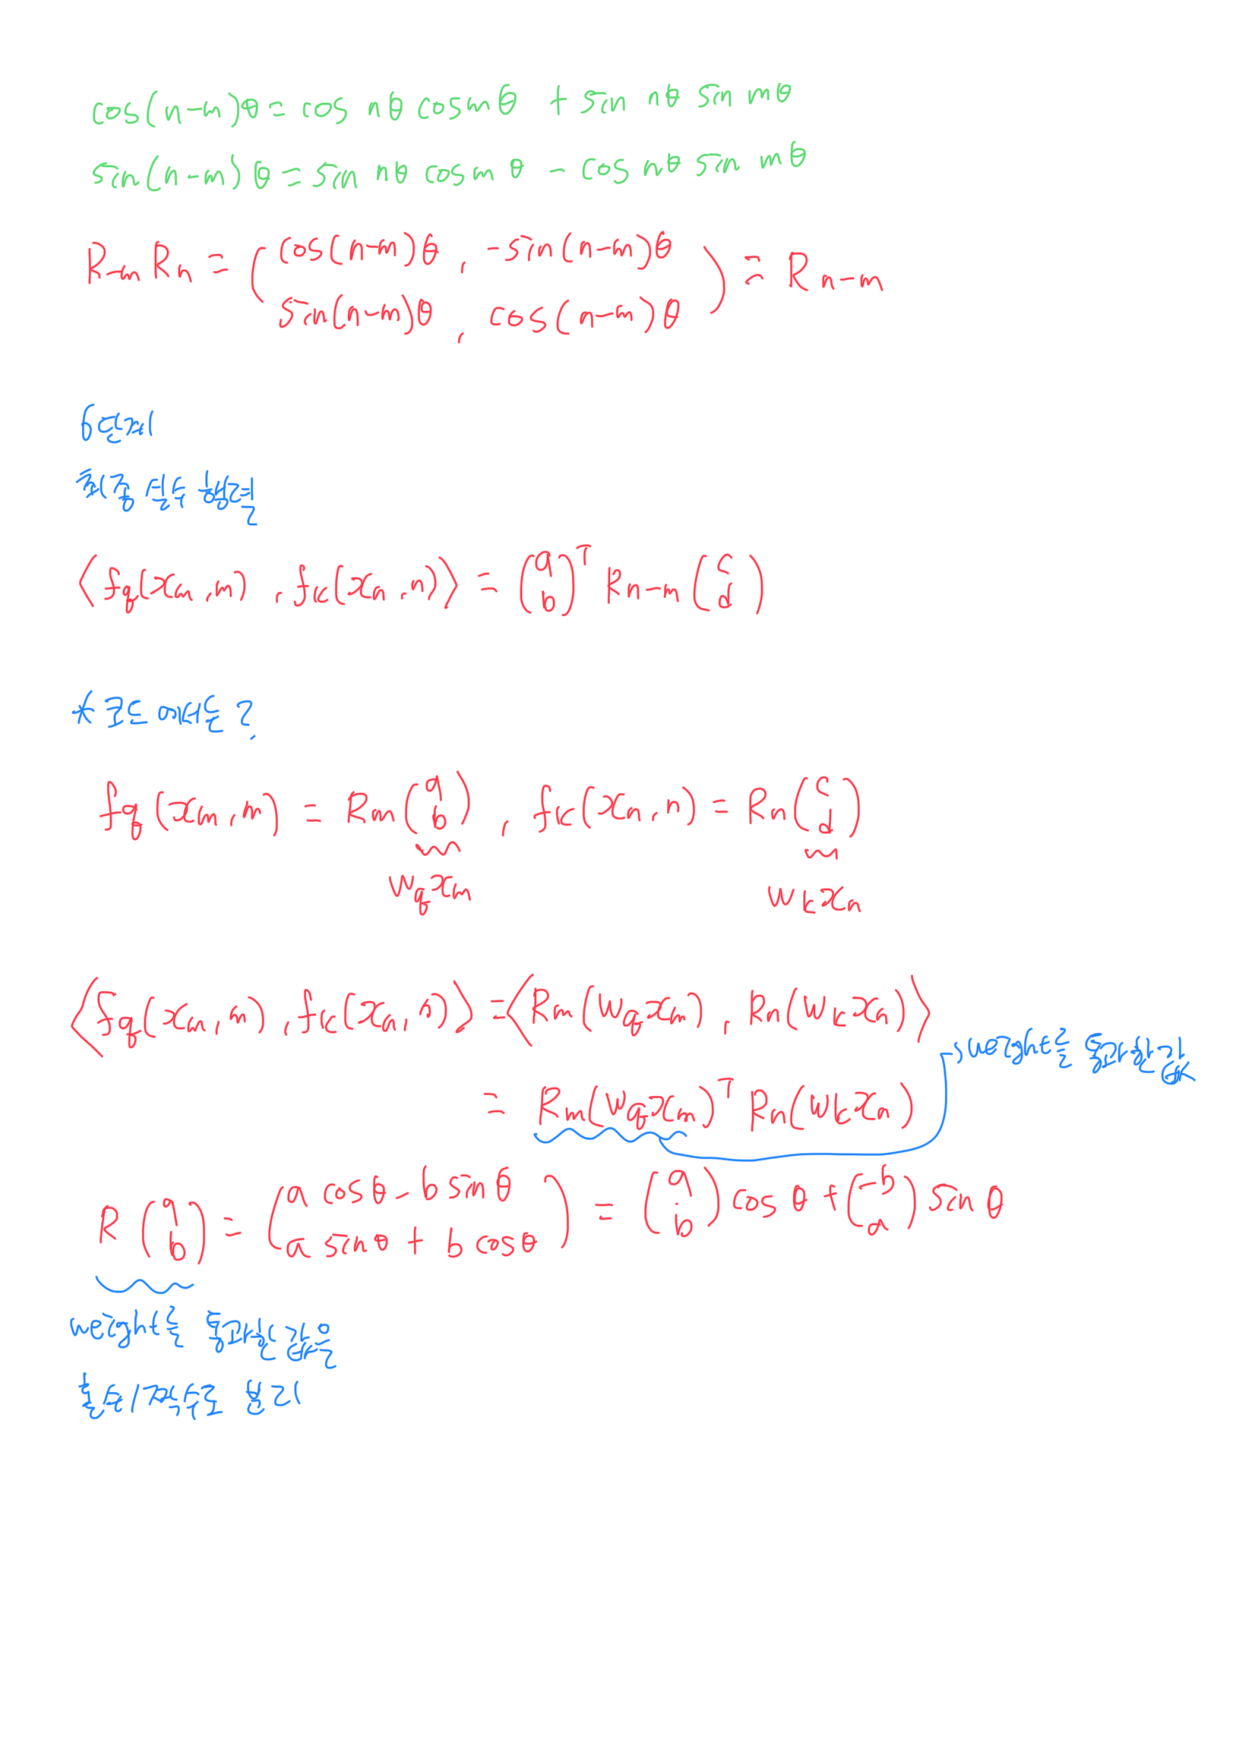
댓글남기기