MTP(Multi-token Prediction) 논문정리
논문: Better & Faster Large Language Models via Multi-token Prediction
한 번에 여러 개의 미래 토큰을 예측하도록 학습시키는 MTP를 정리한 글입니다. 뒤에 나오는 코드는 구조를 이해하기 위한 의사 코드로, 그대로 실행되지는 않습니다.
Abstract
- 언어모델이 한 번에 여러 개의 미래 토큰을 예측하도록 학습시키는 것이 더 높은 샘플 효율성을 가져옴
- $n$개의 독립적인 출력 헤드를 사용하여 그 뒤에 이어지는 $n$개의 토큰을 예측하도록 함으로써, 학습 시간의 추가적인 부담 없이 다운스트림 작업 수행 능력이 향상됨을 확인
- 모델 규모가 커질수록 유용하며, 4개의 토큰 예측 방식으로 학습된 모델은 대규모 배치 크기에서도 추론 속도가 최대 3배 더 빠름
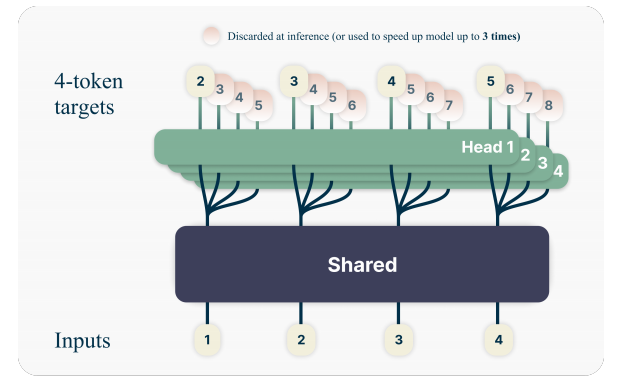
공유 트렁크(Shared) 하나 위에 4개의 헤드가 올라가 있고, 각 헤드가 $t+1$부터 $t+4$까지를 각각 맡는 구조다. 추론 시에는 헤드를 버리거나, 반대로 속도를 최대 3배까지 끌어올리는 데 쓴다.
Method
Next-token prediction
기존 방식은 이전 토큰 $x_t$가 주어졌을 때 다음 토큰 $x_{t+1}$을 예측할 확률을 최대화한다.
\[L_1 = -\sum_t \log P_\theta(x_{t+1} \mid x_{t:1})\]Multi-token prediction
MTP는 이전 토큰 $x_t$가 주어졌을 때, 미래 $n$개 토큰이 전부 나올 결합확률을 최대화한다.
\[L_n = -\sum_t \log P_\theta(x_{t+n:t+1} \mid x_{t:1})\]여기서 $x_{t+n:t+1}$은 미래 $n$개 토큰을 묶은 것이다.
\[\begin{aligned} x_{t+n:t+1} &= (x_{t+1},\ x_{t+2},\ \ldots,\ x_{t+n}) \\ P_\theta(x_{t+n:t+1} \mid x_{t:1}) &= P_\theta(x_{t+1},\ x_{t+2},\ \ldots,\ x_{t+n} \mid x_{t:1}) \end{aligned}\]문제는 $n$개의 토큰이 동시에 특정 조합으로 나올 결합확률은 일반적으로 구하기 힘들다는 점이다. $n$개 토큰을 한 번에 예측하는 head를 만들려면 출력 공간이 $V^n$이 되어야 한다. 어휘 크기가 32,000이고 $n$이 4라면 출력 공간이 $32000^4$이 되므로 현실적으로 불가능하다.
공유 트렁크와 n개의 헤드
그래서 입력 $x$에 대해서 압축된 $z$를 만들고, $z$를 가지고 여러 토큰을 예측하도록 한다.
- $z$는 transformer의 output hidden state다
- $z$만 가지고 독립적인 $n$개의 헤드에 입력하여 토큰을 병렬로 예측한다
두 가지 가정
- 원래 문맥 $x$를 다시 보지 않고 $z$가 $x$를 충분히 압축할 수 있다고 가정한다. (Markov 가정. 바로 직전 상태 하나만 알면 충분하다고 단순화)
- $z$만 주어지면 $x_{t+1}$, $x_{t+2}$ …는 서로 독립적으로 동시에 예측 가능하다고 가정한다. $n$개의 토큰을 순차적으로 예측할 필요 없이, $z$만 있으면 $n$개의 헤드가 각각 독립적으로 병렬 예측할 수 있다
일반 autoregressive 방식은 매 스텝마다 $x_t$를 매번 처리해야 한다. 하지만 여기서는 $x_t$를 $z$를 구할 때 한 번만 계산하고, 예측할 때는 $z$만 사용한다.
결합확률 분해
$z$가 주어졌을 때 미래 $n$개 토큰이 정답 레이블로 나올 결합확률을 높이는 것이 목표다. 하지만 결합확률을 직접 모델링하기 어렵기 때문에, 미래 각 토큰들은 $z$만 주어지면 서로 독립적으로 예측 가능하다는 조건부 독립을 도입해서 결합확률을 각 토큰별 확률의 곱으로 쪼갠다.
먼저 조건부 확률의 연쇄 법칙을 적용한다.
\[\begin{aligned} P(A,\ B \mid C) &= P(A \mid B,\ C) \cdot P(B \mid C) \\ P_\theta(x_{t+n:t+1},\ z_{t:1} \mid x_{t:1}) &= P_\theta(x_{t+n:t+1} \mid z_{t:1},\ x_{t:1}) \cdot P_\theta(z_{t:1} \mid x_{t:1}) \\ P_\theta(x_{t+n:t+1} \mid x_{t:1}) &\approx P_\theta(x_{t+n:t+1} \mid z_{t:1}) \cdot P_\theta(z_{t:1} \mid x_{t:1}) \end{aligned}\]마지막 줄에서 $x_{t:1}$이 조건에서 빠지는 것이 1번 가정($z$가 $x$를 충분히 압축)이다. 이제 2번 가정(조건부 독립)을 적용하면 앞쪽 항이 곱으로 쪼개진다.
\[\begin{aligned} P_\theta(x_{t+n:t+1} \mid x_{t:1}) &\approx P_\theta(x_{t+n:t+1} \mid z_{t:1}) \cdot P_\theta(z_{t:1} \mid x_{t:1}) \\ P_\theta(x_{t+n:t+1} \mid z_{t:1}) &= \prod_{i=1}^{n} P_\theta(x_{t+i} \mid z_{t:1}) \end{aligned}\]이것을 loss에 대입하면 곱이 로그 안에서 합으로 바뀐다.
\[\begin{aligned} L_n &= -\sum_t \log P_\theta(x_{t+n:t+1} \mid z_{t:1}) \cdot P_\theta(z_{t:1} \mid x_{t:1}) \\ &= -\sum_t \sum_{i=1}^{n} \log P_\theta(x_{t+i} \mid z_{t:1}) \cdot P_\theta(z_{t:1} \mid x_{t:1}) \end{aligned}\]결국 $V^n$짜리 거대한 출력층 하나가 아니라, $V$짜리 헤드 $n$개의 loss 합으로 학습할 수 있게 된다.
헤드 구성
각 헤드의 예측은 다음과 같이 세 단계를 거친다.
\[P_\theta(x_{t+i} \mid x_{t:1}) = \mathrm{softmax}\big(f_u(f_{h_i}(f_s(x_{t:1})))\big)\]- $f_s$ = 트랜스포머 모델 (공유 트렁크)
- $f_{h_i}$ = 트랜스포머 레이어 구조의 헤드
- $f_u$ = hidden_dim에서 vocab_size로 선형 변환하는 lm_head
Contribution
논문에서는 학습을 통해 $z_t$가 $x_t$, $x_{t+1}$ …에 대한 정보까지 미리 예측해서 저장하도록 학습 압력을 줄 수 있다고 주장한다. 즉 “앞으로 이런 토큰들이 나올 것 같다”는 정보를 $z$에 녹여 넣게 학습이 되고, 그게 더 나은 표현 학습으로 이어진다는 것이다.
여러 미래 토큰을 동시에 맞추도록 훈련시키면 모델이 더 멀리 내다보는 표현을 학습하게 되어, 1개의 토큰만 생성할 때의 성능도 좋아진다는 주장이다.
Limitation
조건부 독립 가정
미래 토큰들이 서로 조건부 독립이라는 가정 자체가 한계다. 각 헤드는 이전 토큰이 무엇을 뽑았는지 전혀 알지 못한다.
예를 들어 원본 문장이 “오늘 날씨는 맑음 입니다.”일 때 다음과 같은 상황이 생길 수 있다.
입력:  [오늘]
예측:  [날씨는], [하루의], [날씨는], [맑음], [입니다]
“오늘”이라는 입력이 주어지면 그 뒤에 토큰을 $n$개 뽑아야 하는데, 각 헤드들은 $z$(“오늘”)만 가지고 예측하게 된다. 헤드끼리 서로 뭘 뽑았는지 알 수 없다.
학습 시와 추론 시
학습 시에는 각 헤드가 자기 위치의 정답과 비교해서 loss를 계산한다. 정답 시퀀스가 “오늘 날씨는 맑음 입니다”이고 [오늘]이 입력으로 들어오면 다음과 같다.
헤드1 -> 날씨는  -> loss 계산
헤드2 -> 맑음    -> loss 계산
헤드3 -> 입니다  -> loss 계산
추론 시에는 헤드들이 낸 예측이 서로 안 맞을 수도 있다. 따라서 후보들을 하나씩 검증하면서 맞는 데까지만 사용하고, 틀리기 시작하는 지점부터는 다시 예측한다.
디코딩 방법
1. Autoregressive
한 개의 헤드만 남기고 나머지 헤드는 버리고, Autoregressive와 같은 방식으로 디코딩한다.
2. Speculative decoding
- 현재 context를 $f_s$에 통과시켜 $z_{t:1}$을 얻는다. 이때 $z_t$는 마지막 토큰의 $z$다
- 이 $z$를 $n$개의 헤드에 각각 통과시키고 $f_u$로 logit화한 뒤 argmax를 취해 $n$개의 토큰을 생성한다
- 원래 context와 생성된 토큰을 하나로 concat해서 $f_s$에 통과시켜 $z_t$를 얻는다. 이때의 $z_t$는 모든 토큰 위치의 $z$다
- next-token head($f_{h_1}$)에 통과시키고 $f_u$로 logit화한 뒤, 각 위치마다의 argmax 토큰을 추출해서 앞서 생성한 $n$개의 토큰과 비교한다
코드 구현
모델 구조
공유 트렁크는 딱 한 번만 통과하고, 그 출력 $z$를 $n$개의 헤드가 각자 독립적으로 사용한다.
import torch
import torch.nn as nn

class MultiTokenPredictionModel(nn.Module):
    def __init__(self, hidden_dim, vocab_size, n_future_tokens=4, n_shared_layers=30):
        super().__init__()

        # 1. 공유 트렁크 (Shared Trunk) - 기존 트랜스포머와 동일
        #    딱 1개만 존재하며, 모든 헤드가 이 출력을 공유해서 사용
        self.shared_trunk = TransformerModel
        self.lm_head = nn.Linear(hidden_dim, vocab_size=32000, bias=False)

        # 2. n개의 독립적인 출력 헤드
        #    각 헤드는 (작은 트랜스포머 블록) + (선형층) 으로 구성
        #    헤드끼리 파라미터를 공유하지 않음 (독립적)
        self.n_future_tokens = n_future_tokens
        self.output_heads = nn.ModuleList([
            nn.ModuleDict({
                "transformer_block": TransformerBlock(hidden_dim),  # 헤드마다 별도 블록
                "unembed": self.lm_head                             # 헤드마다 별도 출력층(가중치는 공유함)
            })
            for _ in range(n_future_tokens)
        ])

    def forward(self, input_ids):
        # --- 무거운 연산: 트렁크는 딱 한 번만 통과 ---
        x = input_ids
        z = self.shared_trunk(x)  # 공유 은닉 표현 (shared hidden representation)

        # --- 가벼운 연산: 헤드 n개가 z를 각자 독립적으로 사용 ---
        predictions = []
        for i, head in enumerate(self.output_heads):
            h = head["transformer_block"](z)      # 헤드 i 전용 처리
            logits = head["unembed"](h)            # t+i+1 번째 토큰 예측
            predictions.append(logits)

        # predictions[0] -> t+1 예측
        # predictions[1] -> t+2 예측
        # ...
        # predictions[n-1] -> t+n 예측
        return predictions
Loss 계산
헤드 $i$는 $t+i+1$ 위치의 정답을 맞혀야 하므로, 정답 시퀀스를 그만큼 밀어서 정렬한 뒤 cross entropy를 계산한다. 마지막에 $n$개 헤드의 loss를 평균낸다.
def compute_loss(predictions, target_ids, n_future_tokens):
    total_loss = 0
    for i in range(n_future_tokens):
        # 헤드 i는 (t+i+1) 위치의 정답 토큰을 맞혀야 함
        shifted_targets = target_ids[:, i+1:]  # 정답을 i+1칸씩 밀어서 정렬
        logits = predictions[i][:, :shifted_targets.size(1)]

        loss_i = nn.functional.cross_entropy(
            logits.reshape(-1, logits.size(-1)),
            shifted_targets.reshape(-1)
        )
        total_loss += loss_i

    return total_loss / n_future_tokens  # n개 헤드 loss 평균
이 compute_loss가 앞에서 유도한 $L_n = -\sum_t \sum_{i=1}^{n} \log P_\theta(x_{t+i} \mid z_{t:1})$에 대응한다. 각 헤드의 cross entropy가 안쪽 합의 한 항씩을 담당한다.
댓글남기기