DeepSeek-V3의 MTP(Multi-token Prediction) 정리
논문: DeepSeek-V3 Technical Report Section 2.2
앞서 정리한 MTP(Multi-token Prediction)의 후속 글입니다. 원래 MTP가 독립적인 헤드를 병렬로 두었다면, DeepSeek-V3는 모듈을 순차로 이어 붙여 인과 체인을 유지합니다.
Multi-token Prediction
독립적인 출력 헤드를 사용해 $n$개의 추가 토큰을 병렬로 예측하는 원래 논문과 달리, 추가 토큰을 순차적으로 예측하며 각 예측 깊이에서 완전한 인과 체인을 유지한다.
- MTP module 1에서 $t_3$를 예측할 때, Main Model의 임베딩 $t_1$과 현재 입력 $t_2$를 concat해서 예측함
- 이전 방법과 달리 이전 토큰의 정보를 참고할 수 있음
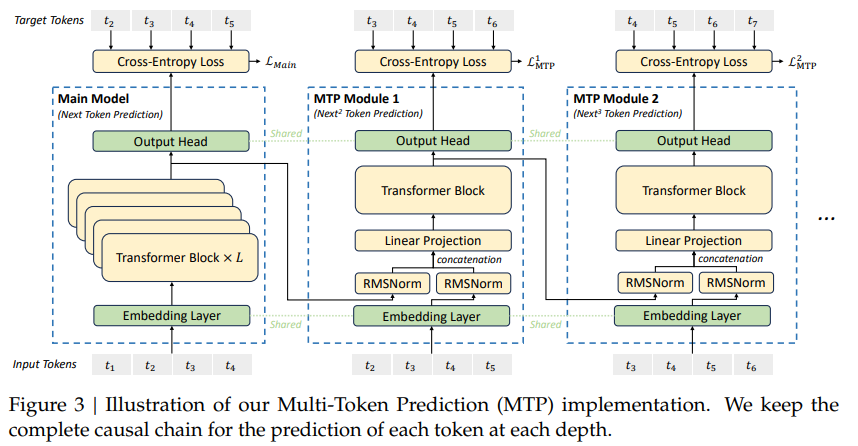
그림에서 보듯 Embedding Layer와 Output Head는 메인 모델과 모든 MTP 모듈이 공유하고, 각 모듈은 자기만의 Linear Projection과 Transformer Block을 가진다.
Method
수식 (21): 이전 깊이의 표현과 임베딩 결합
$i$번째 입력 토큰 $t_i$에 대해 $k$번째 예측 깊이에서, 먼저 $(k-1)$번째 깊이에서의 $i$번째 토큰 표현 $h^{k-1}i \in \mathbb{R}^d$와 $(i+k)$번째 토큰의 임베딩 $\mathrm{Emb}(t{i+k}) \in \mathbb{R}^d$를 선형 투영으로 결합한다.
\[\mathbf{h}'^{k}_{i} = M_k \big[ \mathrm{RMSNorm}(\mathbf{h}^{k-1}_{i})\ ;\ \mathrm{RMSNorm}(\mathrm{Emb}(t_{i+k})) \big]\]- 깊이가 1일 때, 첫 번째 토큰 $t_1$에 대해서 0번째 깊이(메인 모델)에서의 첫 번째 토큰 표현과 $t_2$ 토큰의 임베딩을 선형 투영으로 결합한다
- RMSNorm을 따로 적용한다. hidden state와 embedding은 스케일이 다른 벡터이기 때문이다
- $k=1$일 때만 메인 모델의 출력을 받고, $k \geq 2$부터는 앞 MTP 모듈의 출력을 받는다
수식 (22): 트랜스포머 블록 통과
결합된 벡터는 트랜스포머 입력으로 들어가서 $h^k$를 생성한다.
\[h^{k}_{1:T-k} = \mathrm{TRM}_k \big( h'^{k}_{1:T-k} \big)\]깊이 $k$에서는 시퀀스 길이가 $T-k$로 줄어든다. $\mathrm{Emb}(t_{i+k})$를 입력으로 써야 하므로 뒤쪽 $k$개는 만들 수 없기 때문이다.
수식 (23): 출력 헤드와 softmax
$h^k$가 output head를 통과해 softmax를 적용하면 예측 확률이 나온다.
\[P^{k}_{i+k+1} = \mathrm{OutHead}(h^{k}_{i})\]깊이 $k$의 위치 $i$는 $t_{i+k+1}$을 예측한다.
수식 (24): 깊이별 손실
각 깊이마다 cross entropy를 계산한다.
\[\mathcal{L}^{k}_{\mathrm{MTP}} = \mathrm{CrossEntropy}\big(P^{k}_{2+k:T+1},\ t_{2+k:T+1}\big) = -\frac{1}{T} \sum_{i=2+k}^{T+1} \log P^{k}_{i}[t_i]\]분모가 실제 항의 개수가 아니라 $T$라는 점에 주의한다. 논문 표기를 그대로 따른 것이다.
수식 (25): 전체 MTP 손실
깊이별 손실을 평균내고 가중치 $\lambda$를 곱한다.
\[\mathcal{L}_{\mathrm{MTP}} = \frac{\lambda}{D} \sum_{k=1}^{D} \mathcal{L}^{k}_{\mathrm{MTP}}\] \[\mathcal{L}_{\text{total}} = \mathcal{L}_{\text{main}} + \mathcal{L}_{\mathrm{MTP}}\]$D=1$인 경우를 예로 들면, 메인 모델의 $t_1, t_2, t_3, t_4$ 입력에 대한 target $t_2, t_3, t_4, t_5$의 손실과, MTP 모듈 1의 입력 $t_2, t_3, t_4, t_5$에 대한 target $t_3, t_4, t_5, t_6$의 손실을 각각 구한 뒤 평균을 계산해서 가중치를 곱해 최종 손실을 만든다.
DeepSeek의 MTP 전략은 메인 모델의 성능을 향상시키는 것을 목표로 하며, 추론 시에는 MTP 모듈을 그냥 버려도 메인 모델은 독립적으로 정상 작동한다.
코드 구현
아래 구현은 DeepSeek-V3의 MTP 학습 과정을 재현한 것이다. RMSNorm, causal self-attention, SwiGLU, TransformerBlock 같은 기본 블록은 표준 구현이라 생략하고, MTP 구조에 해당하는 부분만 싣는다.
Config
share_mtp_weights를 켜면 깊이마다 별개 파라미터를 두는 DeepSeek-V3 방식 대신, 깊이 간에 파라미터를 공유하는 GLM-5 방식이 된다.
@dataclass
class Config:
    vocab_size: int = 1024
    d_model: int = 256
    n_heads: int = 4
    n_layers: int = 4          # 메인 모델 레이어 수 L
    d_ff: int = 704            # SwiGLU 중간 차원
    max_seq_len: int = 512

    n_mtp: int = 2             # D — 추가 예측 깊이 개수
    mtp_lambda: float = 0.3    # λ — DeepSeek-V3: 앞 10T 토큰 0.3 → 뒤 4.8T 토큰 0.1
    share_mtp_weights: bool = False   # True면 GLM-5 방식 (M_k, TRM_k를 깊이 간 공유)
    tie_embeddings: bool = False      # OutHead 가중치를 Emb와 묶을지
MTP 모듈: 수식 (21), (22)
hidden state용과 임베딩용 RMSNorm을 따로 두는 것이 핵심이다.
class MTPModule(nn.Module):
    """k번째 MTP 모듈.

    구성요소 (논문 표기):
        M_k    : projection matrix  ∈ R^{d × 2d}
        TRM_k  : Transformer block (단 1개 레이어)
        RMSNorm 2개 — hidden state용, 임베딩용 (스케일이 다르므로 따로 정규화)

    Emb(·)와 OutHead(·)는 바깥(메인 모델)에서 받아 쓰므로 여기엔 없다.
    """

    def __init__(self, cfg: Config):
        super().__init__()
        self.norm_h = RMSNorm(cfg.d_model)     # RMSNorm(h^{k-1}_i)
        self.norm_e = RMSNorm(cfg.d_model)     # RMSNorm(Emb(t_{i+k}))
        self.proj = nn.Linear(2 * cfg.d_model, cfg.d_model, bias=False)  # M_k
        self.block = TransformerBlock(cfg)     # TRM_k

    def forward(self, h_prev: torch.Tensor, emb: torch.Tensor) -> torch.Tensor:
        """
        h_prev : (B, L, d)  — 이전 깊이의 표현 h^{k-1}
        emb    : (B, L, d)  — Emb(t_{i+k}), 이미 시프트된 상태로 들어옴
        return : (B, L, d)  — h^k
        """
        # Eq. (21): concat 후 2d → d 로 투영
        combined = torch.cat([self.norm_h(h_prev), self.norm_e(emb)], dim=-1)
        h = self.proj(combined)
        # Eq. (22): 모듈 내부에서도 causal self-attention이 일어난다 (가로 방향 정보 흐름)
        return self.block(h)
전체 모델: 공유 컴포넌트와 모듈 구성
embed와 out_head는 메인 모델과 모든 MTP 모듈이 공유하고, mtp 리스트만 깊이마다 별개다.
class DeepSeekMTPModel(nn.Module):
    def __init__(self, cfg: Config):
        super().__init__()
        self.cfg = cfg

        # ── 공유 컴포넌트 (메인 모델 ↔ 모든 MTP 모듈) ──
        self.embed = nn.Embedding(cfg.vocab_size, cfg.d_model)          # Emb(·)  [shared]
        self.pos = nn.Parameter(torch.zeros(cfg.max_seq_len, cfg.d_model))
        self.final_norm = RMSNorm(cfg.d_model)
        self.out_head = nn.Linear(cfg.d_model, cfg.vocab_size, bias=False)  # OutHead(·) [shared]
        if cfg.tie_embeddings:
            self.out_head.weight = self.embed.weight

        # ── 메인 모델 ──
        self.blocks = nn.ModuleList([TransformerBlock(cfg) for _ in range(cfg.n_layers)])

        # ── MTP 모듈 D개 ──
        if cfg.share_mtp_weights:
            # GLM-5 방식: 모듈 1개를 만들고 D번 재사용 → 파라미터는 1개 분량
            shared = MTPModule(cfg)
            self.mtp = nn.ModuleList([shared] * cfg.n_mtp)
        else:
            # DeepSeek-V3 방식: 깊이마다 별개 M_k, TRM_k
            self.mtp = nn.ModuleList([MTPModule(cfg) for _ in range(cfg.n_mtp)])

        self.apply(self._init)
학습 forward: 수식 (23), (24), (25)
h_prev = h_k로 다음 깊이에 연결하는 부분이 인과 체인을 만드는 지점이다. 인덱싱이 헷갈리기 쉬워서 주석에 규칙을 적어 두었다.
    def forward(self, tokens: torch.Tensor) -> dict:
        """
        tokens : (B, T)  — t_1 .. t_T  (0-based 인덱스로는 0..T-1)

        인덱싱 규칙 (0-based)
        ---------------------
          메인    : 위치 i 는 tokens[i+1] 예측         → 유효 i = 0 .. T-2   (T-1개)
          깊이 k  : 위치 i 는 tokens[i+k+1] 예측
                    입력으로 Emb(tokens[i+k]) 필요     → h^k 길이 L_k = T-k
                    타겟이 존재해야 하므로 손실 위치    = 0 .. T-k-2  (T-k-1개)
        """
        B, T = tokens.shape
        cfg = self.cfg
        emb_all = self._embed(tokens)                       # (B, T, d)

        # ── 메인 모델 ──
        h = emb_all
        for blk in self.blocks:
            h = blk(h)
        h_main = h                                          # h^0, 길이 T

        main_logits = self.out_head(self.final_norm(h_main[:, :-1]))   # (B, T-1, V)
        loss_main = F.cross_entropy(
            main_logits.reshape(-1, cfg.vocab_size),
            tokens[:, 1:].reshape(-1),
        )

        # ── MTP 모듈 체인 ──
        mtp_losses: list[torch.Tensor] = []
        h_prev = h_main                                     # h^0

        for k in range(1, cfg.n_mtp + 1):
            L_k = T - k                                     # Eq.(22)의 1:T-k
            if L_k <= 1:                                    # 타겟을 만들 수 없음
                break

            # Eq.(21): h^{k-1}_{0:L_k} 와 Emb(t_{i+k}) 결합
            h_in = h_prev[:, :L_k]                          # (B, L_k, d)
            e_in = emb_all[:, k : k + L_k]                  # Emb(t_{i+k})
            h_k = self.mtp[k - 1](h_in, e_in)               # (B, L_k, d) = h^k

            # Eq.(23): 위치 i → tokens[i+k+1]
            logits_k = self.out_head(self.final_norm(h_k[:, :-1]))      # (B, L_k-1, V)
            target_k = tokens[:, k + 1 : T]                             # (B, L_k-1)

            # Eq.(24): 논문 표기대로 분모는 항 개수(T-k-1)가 아니라 T
            nll = F.cross_entropy(
                logits_k.reshape(-1, cfg.vocab_size),
                target_k.reshape(-1),
                reduction="sum",
            )
            mtp_losses.append(nll / (B * T))

            h_prev = h_k                                    # 다음 깊이로 체인 연결

        # Eq.(25)
        if mtp_losses:
            loss_mtp = cfg.mtp_lambda * torch.stack(mtp_losses).mean()
        else:
            loss_mtp = torch.zeros((), device=tokens.device)

        return {
            "loss": loss_main + loss_mtp,
            "loss_main": loss_main,
            "loss_mtp": loss_mtp,
            "loss_per_depth": [l.detach() for l in mtp_losses],
        }
Draft 생성
추론 시 speculative decoding용으로 draft를 뽑는 부분이다. 아래 docstring이 뒤에 나올 단점(학습과 추론의 불일치)을 그대로 설명한다.
    @torch.no_grad()
    def draft(self, tokens: torch.Tensor, n_steps: int) -> torch.Tensor:
        """Speculative decoding용 draft 생성 (greedy).

        주의 — 여기가 GLM-5 논문이 지적한 지점이다.
        학습 때 깊이 k 모듈은 `[h^{k-1}(정답 경로) ; Emb(정답 토큰)]` 만 보았지만,
        추론에서는 2단계부터 `[자기가 만든 h ; 자기가 추측한 draft 토큰]` 을 받는다.
        n_steps > n_mtp 이면 마지막 모듈을 재귀 호출하게 되어 괴리가 더 커진다.
        """
        h_prev = self.forward_main(tokens)[:, -1:]                 # 마지막 위치 h^0
        last = self.out_head(self.final_norm(h_prev)).argmax(-1)   # 메인이 뽑은 t_{T+1}
        drafts = [last]

        for k in range(1, n_steps + 1):
            module = self.mtp[min(k, self.cfg.n_mtp) - 1]          # 부족하면 마지막 모듈 재사용
            e = self.embed(last)
            h_prev = module(h_prev, e)
            last = self.out_head(self.final_norm(h_prev)).argmax(-1)
            drafts.append(last)

        return torch.cat(drafts, dim=1)                            # (B, n_steps+1)
실행 결과
$D=2$로 두고 토이 데이터에 60 스텝 학습시킨 결과다. $\lambda$는 DeepSeek-V3의 스케줄을 흉내내어 앞 구간 0.3, 뒤 구간 0.1로 바꿨다.
step   0 | λ=0.3 | total=9.0005 main=6.9933 mtp=2.0072 | L^1=6.732 L^2=6.649
step  20 | λ=0.3 | total=3.4665 main=2.3570 mtp=1.1095 | L^1=4.135 L^2=3.261
step  40 | λ=0.3 | total=1.0333 main=0.6811 mtp=0.3523 | L^1=1.428 L^2=0.920
step  59 | λ=0.1 | total=0.1917 main=0.1687 mtp=0.0230 | L^1=0.266 L^2=0.194

MTP 파라미터 (D=2)  |  별개: 1,869,824   공유: 934,912   비율: 2.00x
  depth k=1: 손실 위치 62개  (= T-k-1, T=64)
  depth k=2: 손실 위치 61개  (= T-k-1, T=64)
draft 출력 shape: (2, 5)  (메인 1토큰 + 추측 4토큰)
- 메인 손실과 깊이별 MTP 손실이 함께 내려간다
- 깊이마다 별개 파라미터를 두면 $D=2$에서 파라미터가 정확히 2배가 된다. 공유 방식은 1개 분량으로 유지된다
- 깊이 $k$의 손실 항 개수가 $T-k-1$로 나와 인덱싱 규칙과 일치한다
장단점
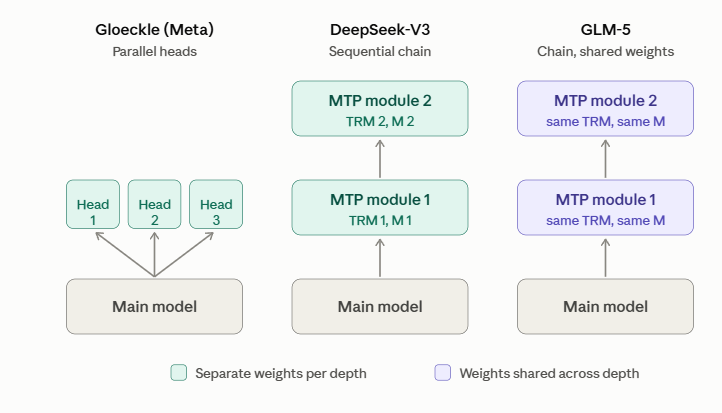
기존 MTP 방식
장점
- 구현이 단순하고 draft 생성이 병렬로 처리됨. Forward 1회로 $n$개가 한 번에 나옴
- 학습과 추론 latency가 거의 없음
단점
- 헤드끼리 서로를 안 보고 독립적으로 생성하기 때문에 시퀀스의 일관성이 떨어짐
DeepSeek MTP 방식
장점
- 각 단계가 앞 단계의 결과를 입력으로 받으니 draft 품질이 좋음
- 메인 모델이 먼 미래까지 고려하도록 학습 압력을 줄 수 있음
단점
- 모듈별 트랜스포머와 Linear Projection이 깊이마다 별개라 파라미터와 KV 캐시가 $K$에 선형 비례함
- 학습은 $k=1$로 했는데 추론에서 2단계 이상 뽑으려면 같은 모듈을 재귀적으로 호출하게 되어, 학습과 추론 사이에 불일치가 발생함
위 비교 그림의 세 번째가 이 단점을 겨냥한 GLM-5 방식이다. 깊이마다 별개 모듈을 두는 대신 같은 모듈을 공유해서 파라미터 증가를 막는다. 코드에서는 share_mtp_weights=True로 전환할 수 있고, 실행 결과에서 본 것처럼 $D=2$ 기준 파라미터가 절반이 된다.
댓글남기기