ZeRO: Memory Optimizations Toward Training Trillion Parameter Models 논문정리
논문: ZeRO: Memory Optimizations Toward Training Trillion Parameter Models
데이터 병렬화의 메모리 중복을 제거하는 ZeRO를 정리했습니다. 모델 상태를 다루는 ZeRO-DP와 잔여 상태를 다루는 ZeRO-R 두 축으로 나뉩니다.
Abstract
- 데이터 병렬화와 모델 병렬화 같은 기존 솔루션들은 제한된 디바이스 메모리 안에 대형 모델을 담으면서도 연산, 통신, 개발 효율성을 확보하는 데 근본적인 한계를 보임
- 메모리를 최적화하는 새로운 솔루션인 ZeRO(Zero Redundancy Optimizer) 를 개발했으며, 이를 통해 학습 속도를 크게 향상시키는 동시에 효율적으로 학습할 수 있는 모델의 크기를 늘림
- ZeRO는 데이터 병렬 및 모델 병렬 학습에서 발생하는 메모리 중복을 제거하면서도 낮은 통신량과 연산 세분성을 유지하여, 디바이스 수에 비례해 모델 크기를 확장하면서도 지속적으로 높은 효율을 낼 수 있게 함
- 400개의 GPU에서 1,000억 개가 넘는 파라미터를 가진 대형 모델을 초선형(super-linear) 속도 향상으로 학습시켜 15 페타플롭스의 처리량을 달성함. 이는 기존 최고 수준 대비 모델 크기는 8배, 달성 가능한 성능은 10배 증가한 결과임
- Megatron GPT의 83억 개나 T5의 110억 개보다 더 큰 최대 130억 개 파라미터의 모델을, 과학자들이 적용하기 더 어려운 모델 병렬화 없이도 학습시킬 수 있음
메모리는 어디에 쓰이는가
기존 시스템에서 모델 학습 시 발생하는 메모리 소비를 분석하면 크게 두 가지로 나뉜다.
- 모델 상태 메모리: 옵티마이저 상태, 그래디언트, 파라미터. 메모리의 대부분을 차지한다
- 잔여 상태 메모리: 활성화 값(activation), 임시 버퍼, 사용 불가능한 메모리 조각
ZeRO는 전자를 ZeRO-DP로, 후자를 ZeRO-R로 각각 최적화한다.
ZeRO-DP의 통찰
- DP는 MP보다 확장 효율성이 좋다
- DP는 모든 데이터 병렬 프로세스에 걸쳐 모델 상태가 중복으로 저장되는 단점이 있다. 단, MP는 모델 상태를 분할하여 메모리 효율성을 얻는다. 따라서 DP를 MP처럼 메모리 효율적으로 개선하자는 것이 출발점이다
- DP와 MP 모두 학습 전체 과정에서 필요한 모든 모델 상태를 계속 유지하지만, 사실 순전파와 역전파 시점에만 해당 파라미터가 필요하다. 동적 스케줄을 사용해서 필요할 때만 gather하고 나머지는 버린다
1.5B 파라미터를 가진 모델은 16비트 정밀도에서 가중치를 저장하는 데 3GB의 메모리만 필요하지만, 실제로는 32GB 단일 GPU에서도 학습이 되지 않는다. 모델 가중치 이외에도 그래디언트와 옵티마이저 상태가 저장되어야 하기 때문이다. 옵티마이저 상태에는 FP32 파라미터(FP16 정밀도로 학습할 경우 FP32 사본도 저장되어야 함), 모멘텀, 분산이 포함된다.
ZeRO-R의 통찰
- Activation은 학습 중 상당한 양의 메모리를 차지할 수 있다. ZeRO-DP로 옵티마이저 상태 문제를 해결하더라도 대형 모델에서는 activation이 병목으로 작용한다
- 중간 결과를 저장하는 데 사용되는 임시 버퍼도 무시할 수 없다. all-reduce나 norm 같은 연산은 처리량을 높이기 위해 flatten으로 융합하는데, 1.5B 기준으로 이 양도 6GB의 메모리를 필요로 한다
- 사용 가능한 메모리가 충분히 남아 있음에도 요청된 크기를 만족시킬 만큼 연속된 메모리가 없으면 할당을 하지 못하고 OOM이 뜬다
ZeRO-DP: 모델 상태 메모리 최적화
옵티마이저 상태, 그래디언트, 파라미터를 각 GPU에 나눠 갖게 최적화한다. 세 단계를 모두 활성화하면 이론적으로 단 1024개의 16GB GPU로 1T 파라미터 모델을 학습시킬 수 있다.
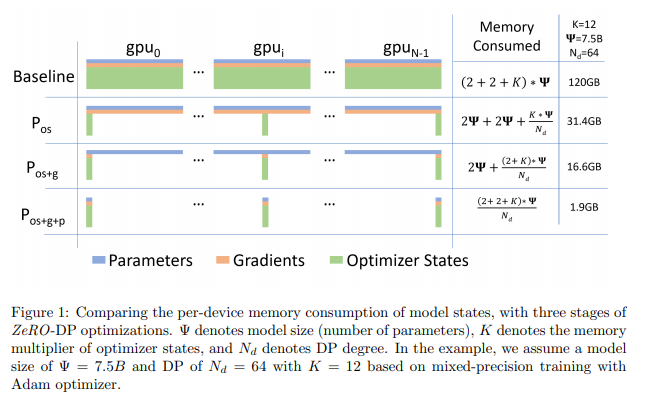
$\Psi$는 모델 크기(파라미터 수), $K$는 옵티마이저 상태의 메모리 배수, $N_d$는 DP 차수다. 아래 표는 $\Psi = 7.5B$, $K = 12$, $N_d = 64$인 경우다.
| 단계 | 디바이스당 메모리 | 예시 값 |
|---|---|---|
| Baseline | $(2 + 2 + K) \cdot \Psi$ | 120GB |
| $P_{os}$ | $2\Psi + 2\Psi + \dfrac{K \cdot \Psi}{N_d}$ | 31.4GB |
| $P_{os+g}$ | $2\Psi + \dfrac{(2 + K) \cdot \Psi}{N_d}$ | 16.6GB |
| $P_{os+g+p}$ | $\dfrac{(2 + 2 + K) \cdot \Psi}{N_d}$ | 1.9GB |
옵티마이저 상태 분할
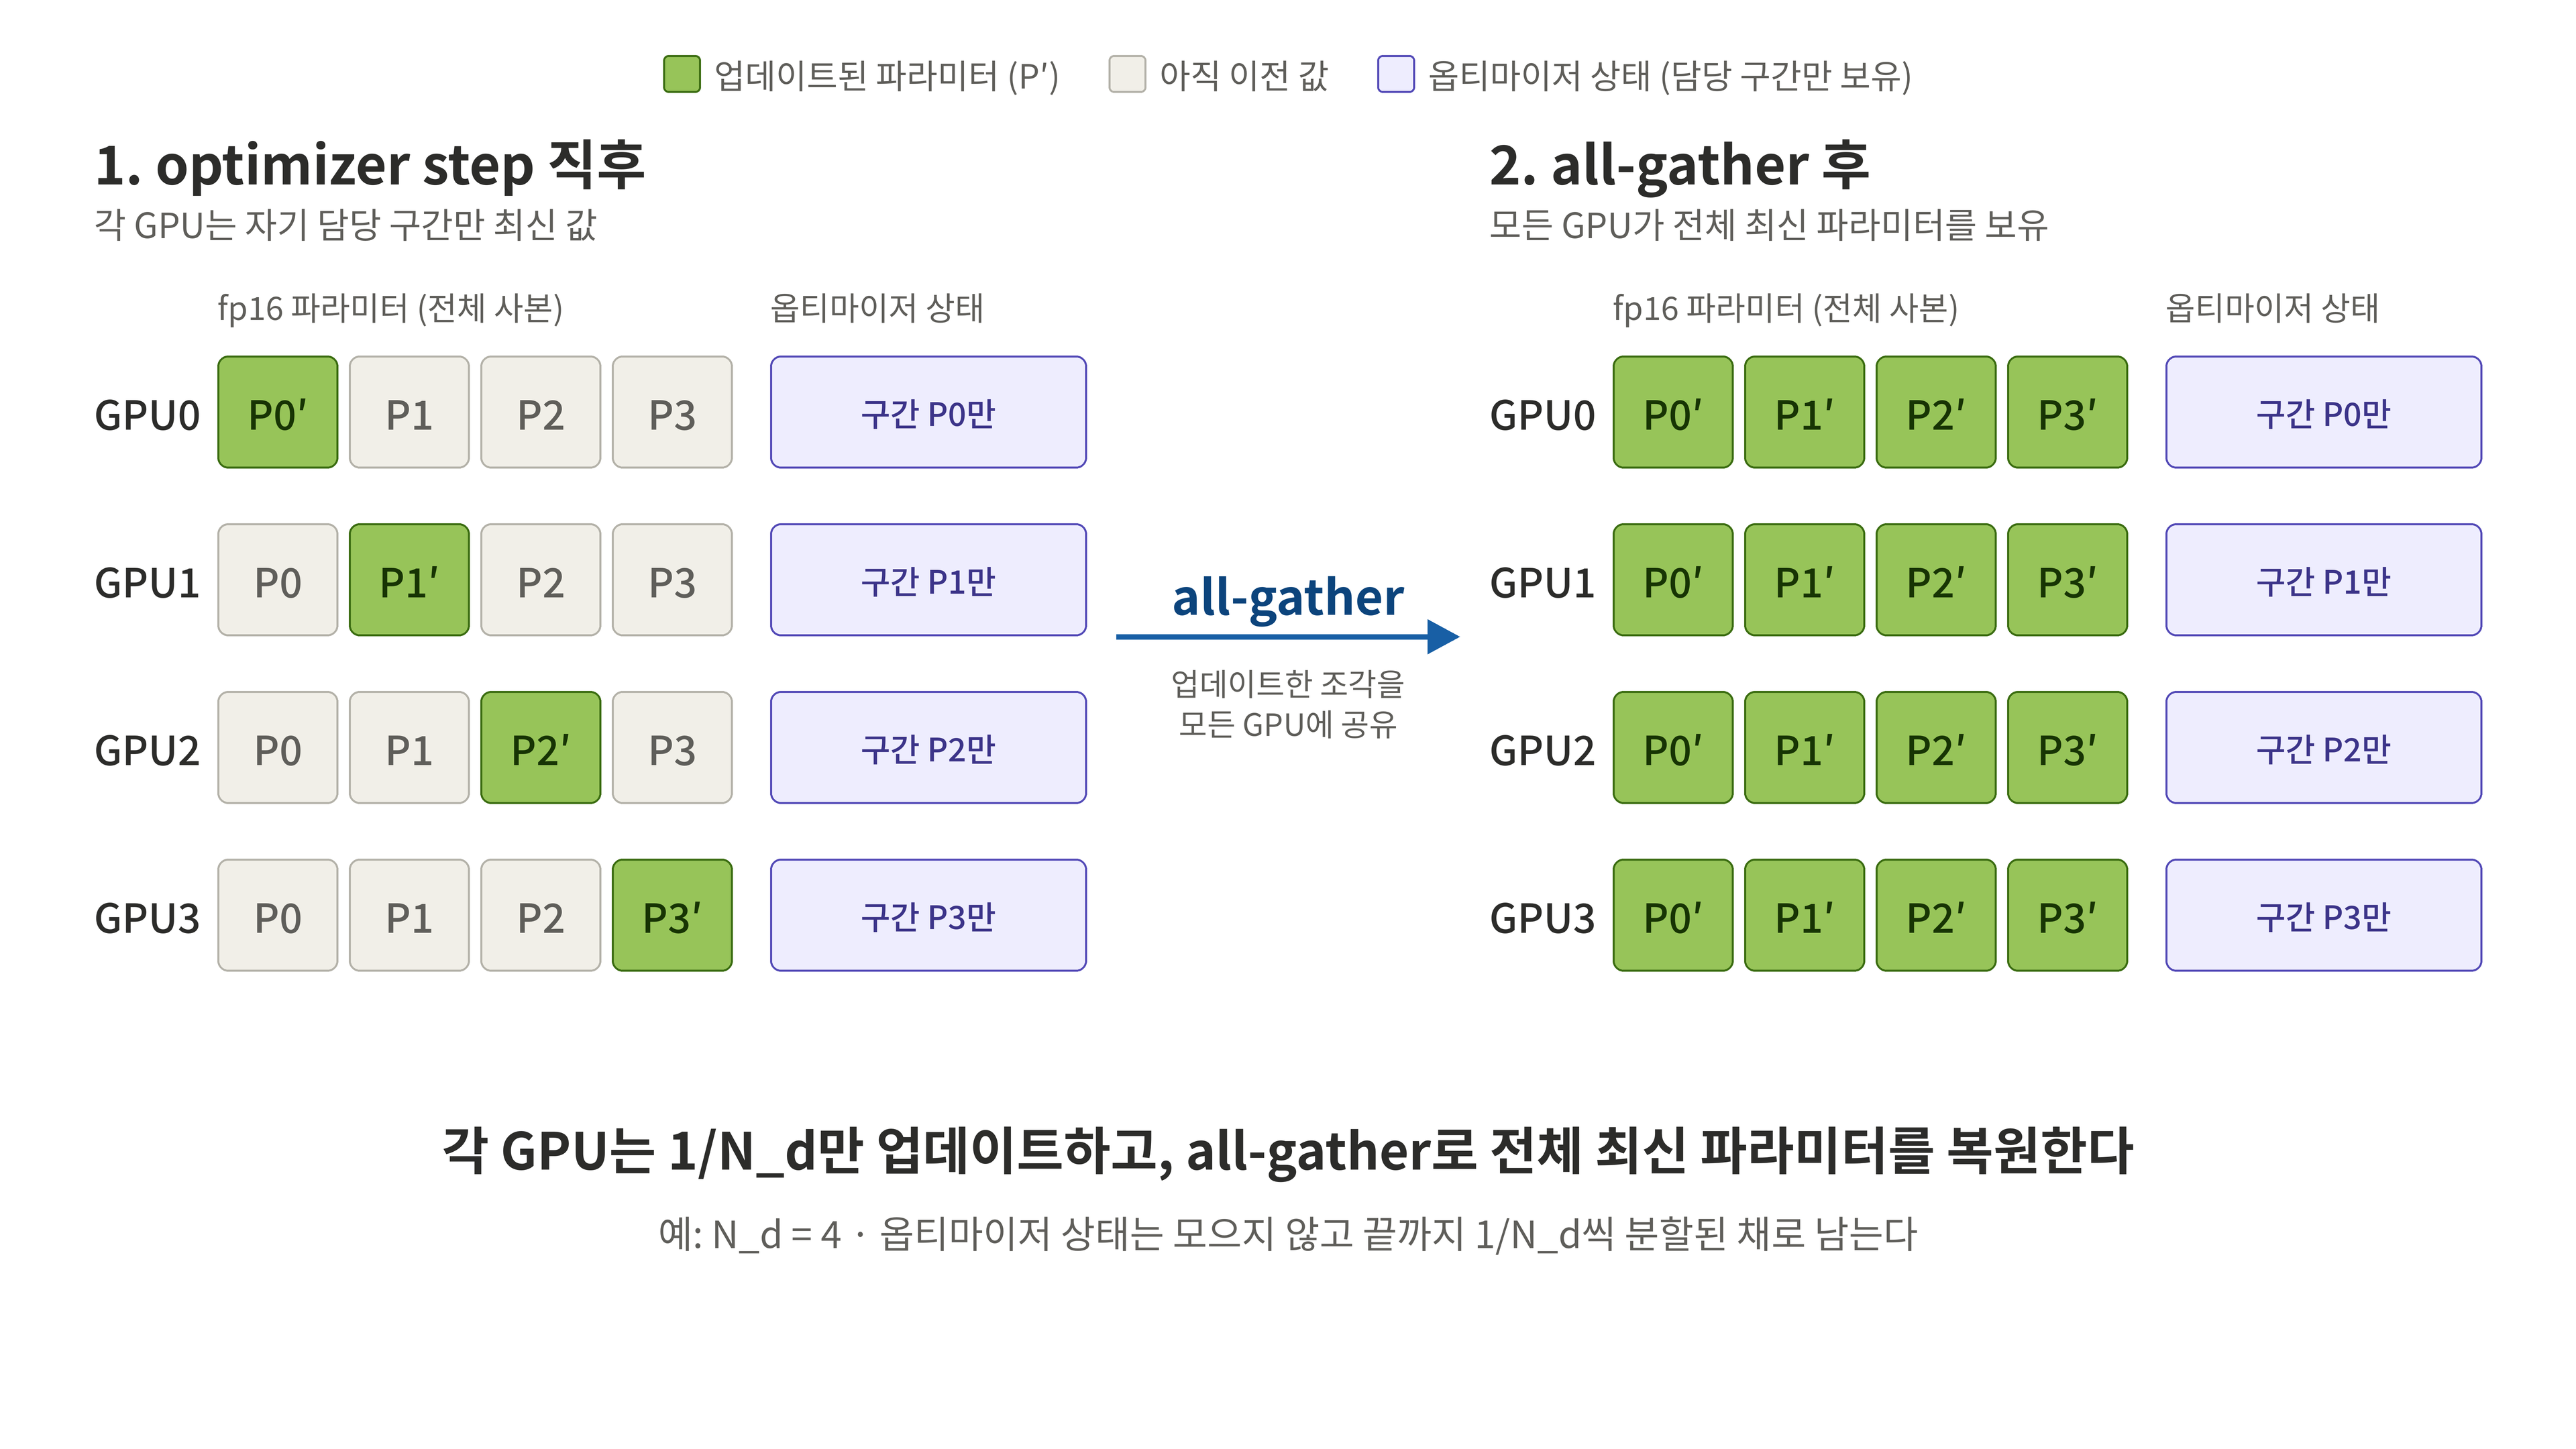
옵티마이저 상태를 $N_d$개의 동일한 분할로 나누어, $i$번째 데이터 병렬 프로세스가 오직 $i$번째 분할에 해당하는 옵티마이저 상태만 업데이트하도록 한다.
- 각 데이터 병렬 프로세스는 전체 옵티마이저 상태 중 $1/N_d$만 저장하고 업데이트하면 되고, 이에 따라 파라미터도 $1/N_d$만 업데이트하게 된다
- 각 학습 스텝이 끝날 때 all-gather를 수행해서, 모든 병렬 프로세스가 완전히 업데이트된 파라미터를 갖도록 한다
그래디언트 분할
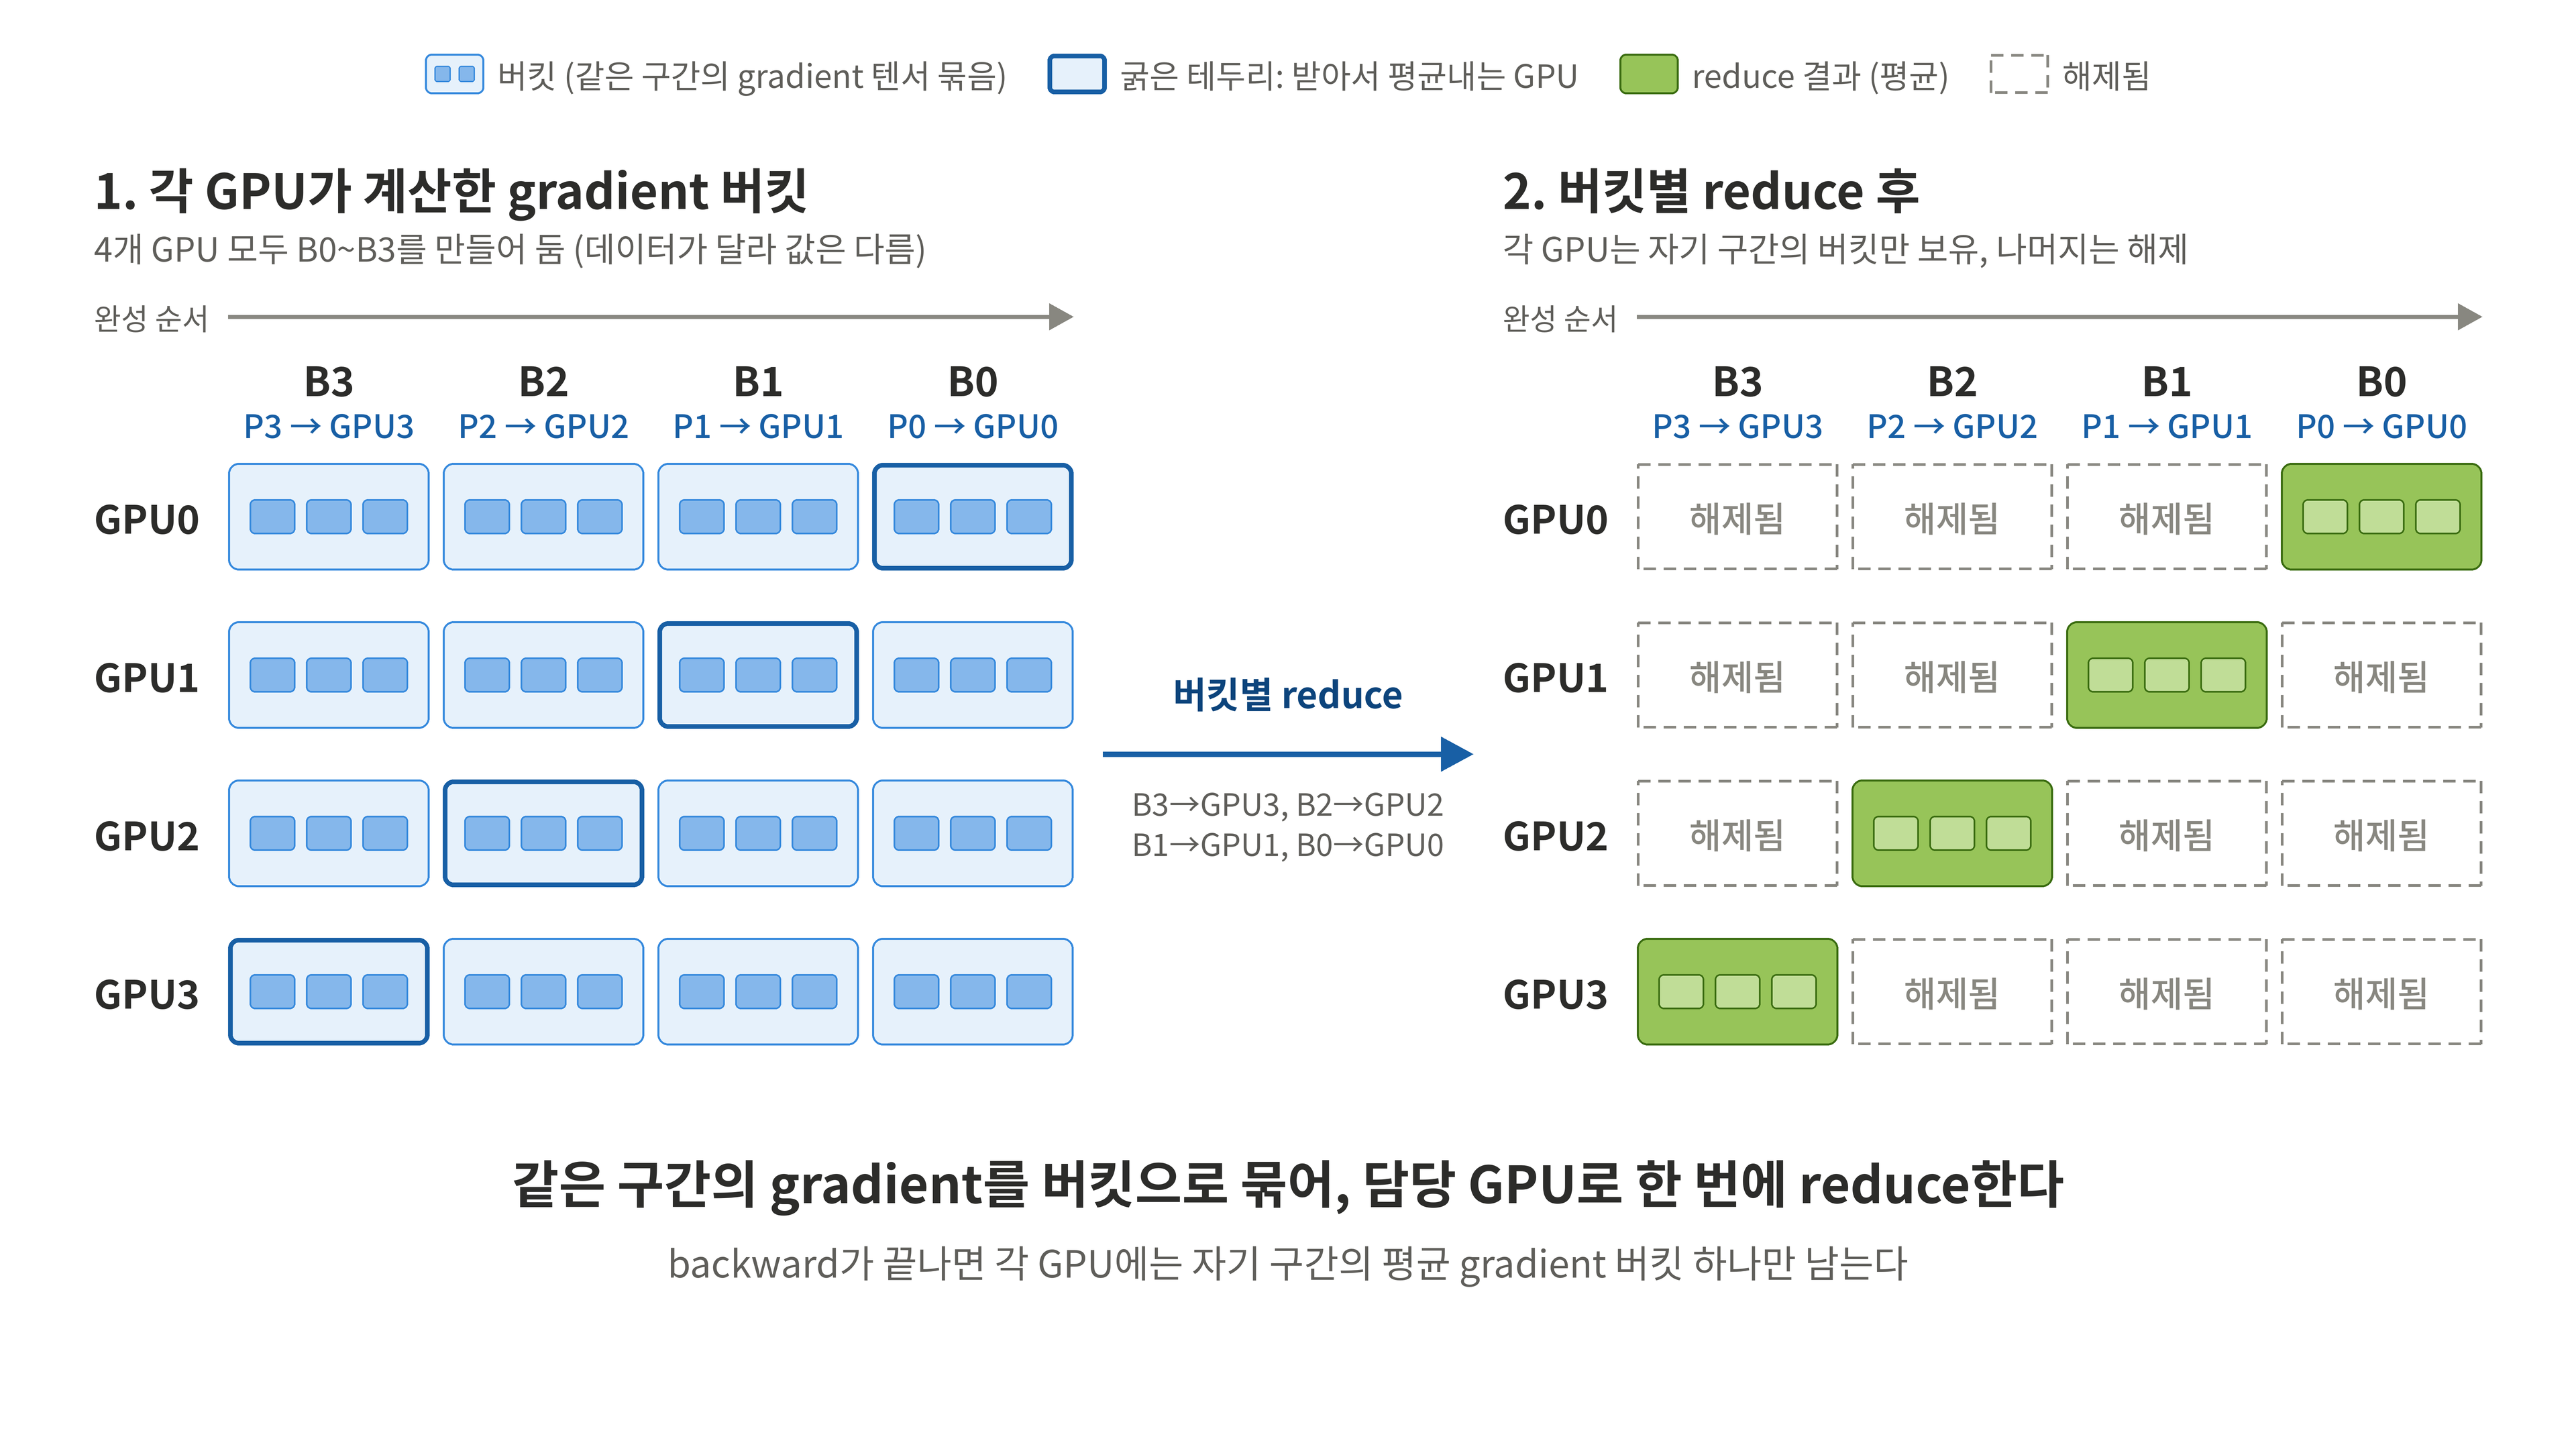
각 GPU는 전체 파라미터 중 자기 담당 구간만 업데이트한다(옵티마이저 상태 분할이 전제로 깔려 있는 상태). 따라서 자기 구간의 평균 gradient만 필요하다.
- Backward 중에 어떤 GPU 안에 있는 파라미터의 gradient가 계산될 때마다, 그 파라미터를 담당하는 GPU 한 곳으로만 모아서 평균을 내고 나머지 GPU는 바로 메모리에서 지운다
- 실제로 더 효율적으로 만들기 위해 버킷화 전략을 사용한다. 버킷을 보내는 동안 GPU는 backward를 계속한다
파라미터 분할
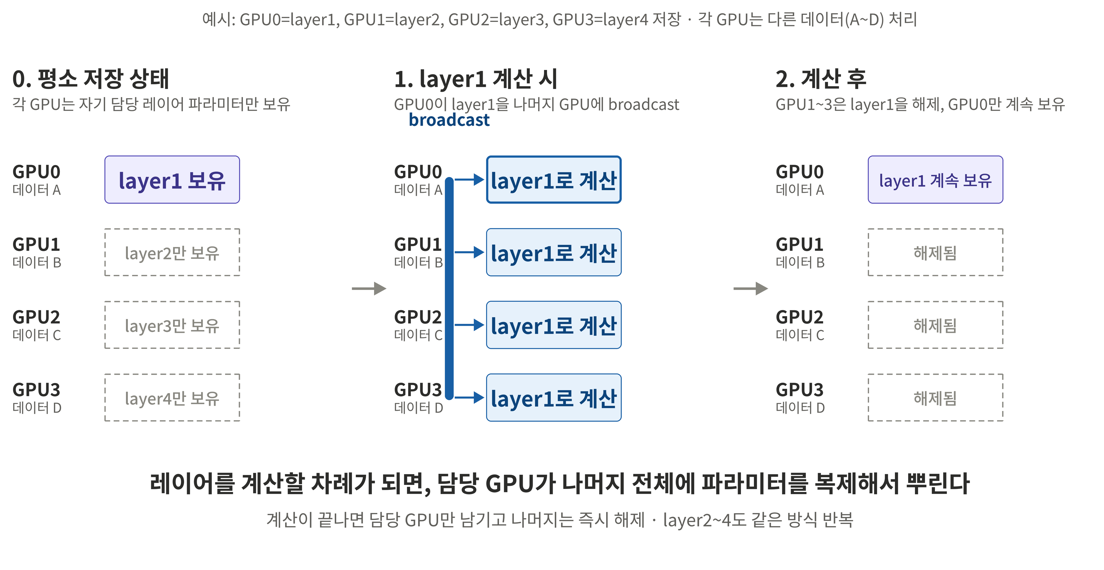
옵티마이저 상태와 그래디언트의 경우와 마찬가지로, 각 프로세스는 자신의 분할에 해당하는 파라미터만 저장한다.
- Forward나 backward propagation을 위해 분할 밖에 있는 파라미터가 필요할 경우에는 브로드캐스트(한 GPU가 가진 데이터를 다른 GPU들에게 복사해서 보내는 통신 연산)를 통해 전달받는다
- 계산이 끝난 파라미터는 해당 GPU에서 메모리 해제한다
- 메모리를 줄이는 대신 어느 정도 통신 비용이 부담된다. 트레이드오프다
ZeRO-R: 잔여 상태 메모리 최적화
ZeRO-DP가 모델 상태의 메모리 효율성을 높인 후에는, 활성화 값과 임시 버퍼, 사용 불가능한 메모리 조각들이 소비하는 메모리가 병목이 될 수 있다. ZeRO-R은 이 세 가지를 각각 해결한다.
Partitioned Activation Checkpointing
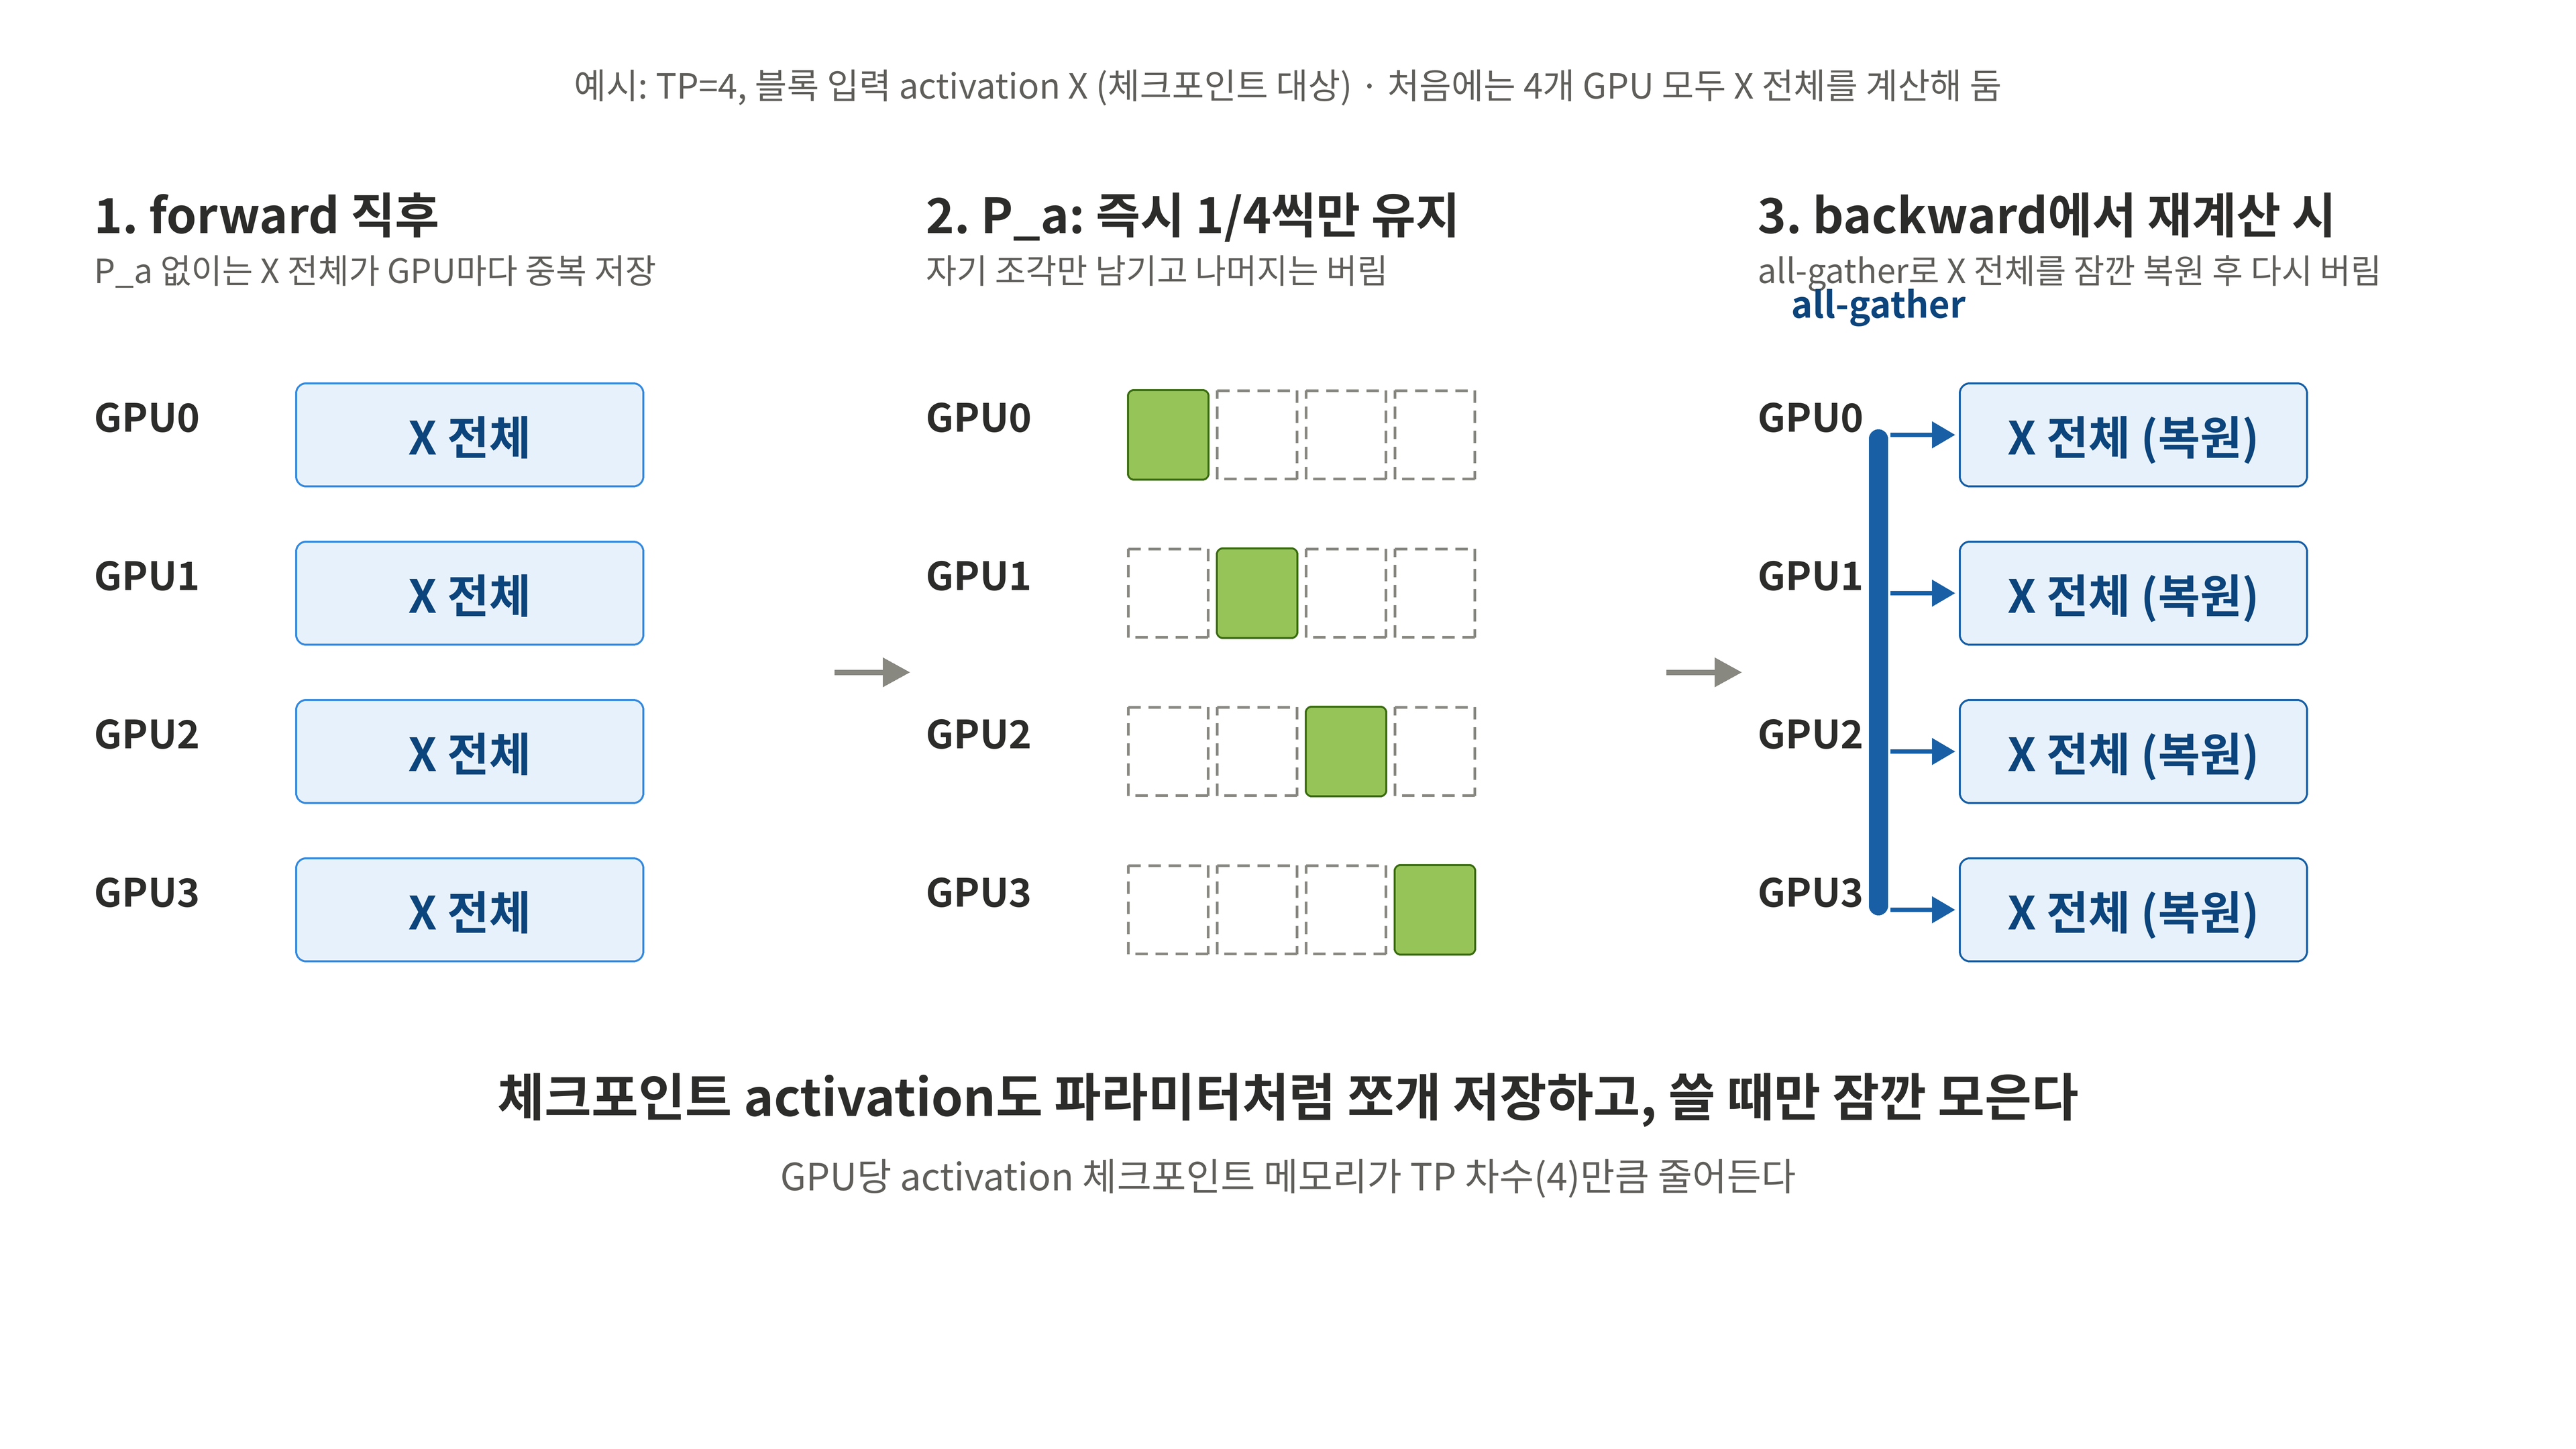
MP는 설계상 activation 값의 복제를 필요로 하며, 그 결과 모델 병렬 GPU들에 걸쳐 중복 사본이 생겨난다. Weight는 중복이 아니지만, 입력 $X$는 두 GPU가 모두 필요해서 양쪽에 똑같이 존재하고, all-reduce로 만든 출력 $Y$도 양쪽 모두 갖게 된다.
              X (블록 입력, 크기 [B, S, h])
        ┌──────────────┴──────────────┐
  GPU0: X 전체 필요            GPU1: X 전체 필요
     | (weight 절반)              | (weight 절반)
    부분결과 Y0                   부분결과 Y1
        └───────── all-reduce ────────┘
        Y = Y0 + Y1  (GPU0, GPU1 둘 다 전체 보유)
그래서 activation도 쪼개서 저장했다가 필요할 때만 all-gather 연산을 통해 복원한다. 매우 큰 모델이면서 디바이스 메모리가 매우 제한적인 경우 CPU로 오프로드할 수 있으며, 이를 통해 추가적인 통신 비용을 대가로 메모리 오버헤드를 0에 가깝게 줄일 수 있다.
Constant size buffer
큰 버퍼일수록 통신 효율(대역폭)이 좋아지기 때문에 기존 NVIDIA Apex나 Megatron 같은 고성능 라이브러리들은 모든 파라미터를 하나의 버퍼로 합친다. 하지만 이는 모델이 커질수록 버퍼도 같이 커지는 문제가 있다.
ZeRO는 버퍼가 파라미터 전체를 한 번에 담을 필요는 없다고 판단하고, 고정 크기 버퍼를 하나 정해두고 파라미터를 그 버퍼 크기만큼 나눠서 여러 번에 걸쳐 처리한다. 이때 버퍼를 너무 작게 잡으면 통신 효율이 떨어지기 때문에, 통신 효율을 낼 만큼은 충분히 큰 크기를 잡는다.
왜 파라미터를 하나로 묶는가?
all-reduce 같은 통신은 큰 메시지 하나가 작은 메시지 여러 개보다 효율적이다. 통신마다 고정 비용이 들기 때문에, 파라미터가 1000개 텐서로 흩어져 있으면 1000개 각각 통신하는 게 아니라 1000개를 하나의 버퍼로 복사해서 한 번에 통신한다.
Memory Defragmentation
메모리가 넉넉하면 조각나 있어도 어딘가에 큰 빈 공간이 남아 있을 가능성이 높아서 별 문제가 되지 않는다. 하지만 메모리를 거의 다 채워 쓰는 대형 모델 학습에서는 메모리가 부족할 수 있다. 또한 메모리를 할당할 때 맞는 연속 공간을 찾느라 시간을 쓰기 때문에 학습 자체가 느려질 수 있다.
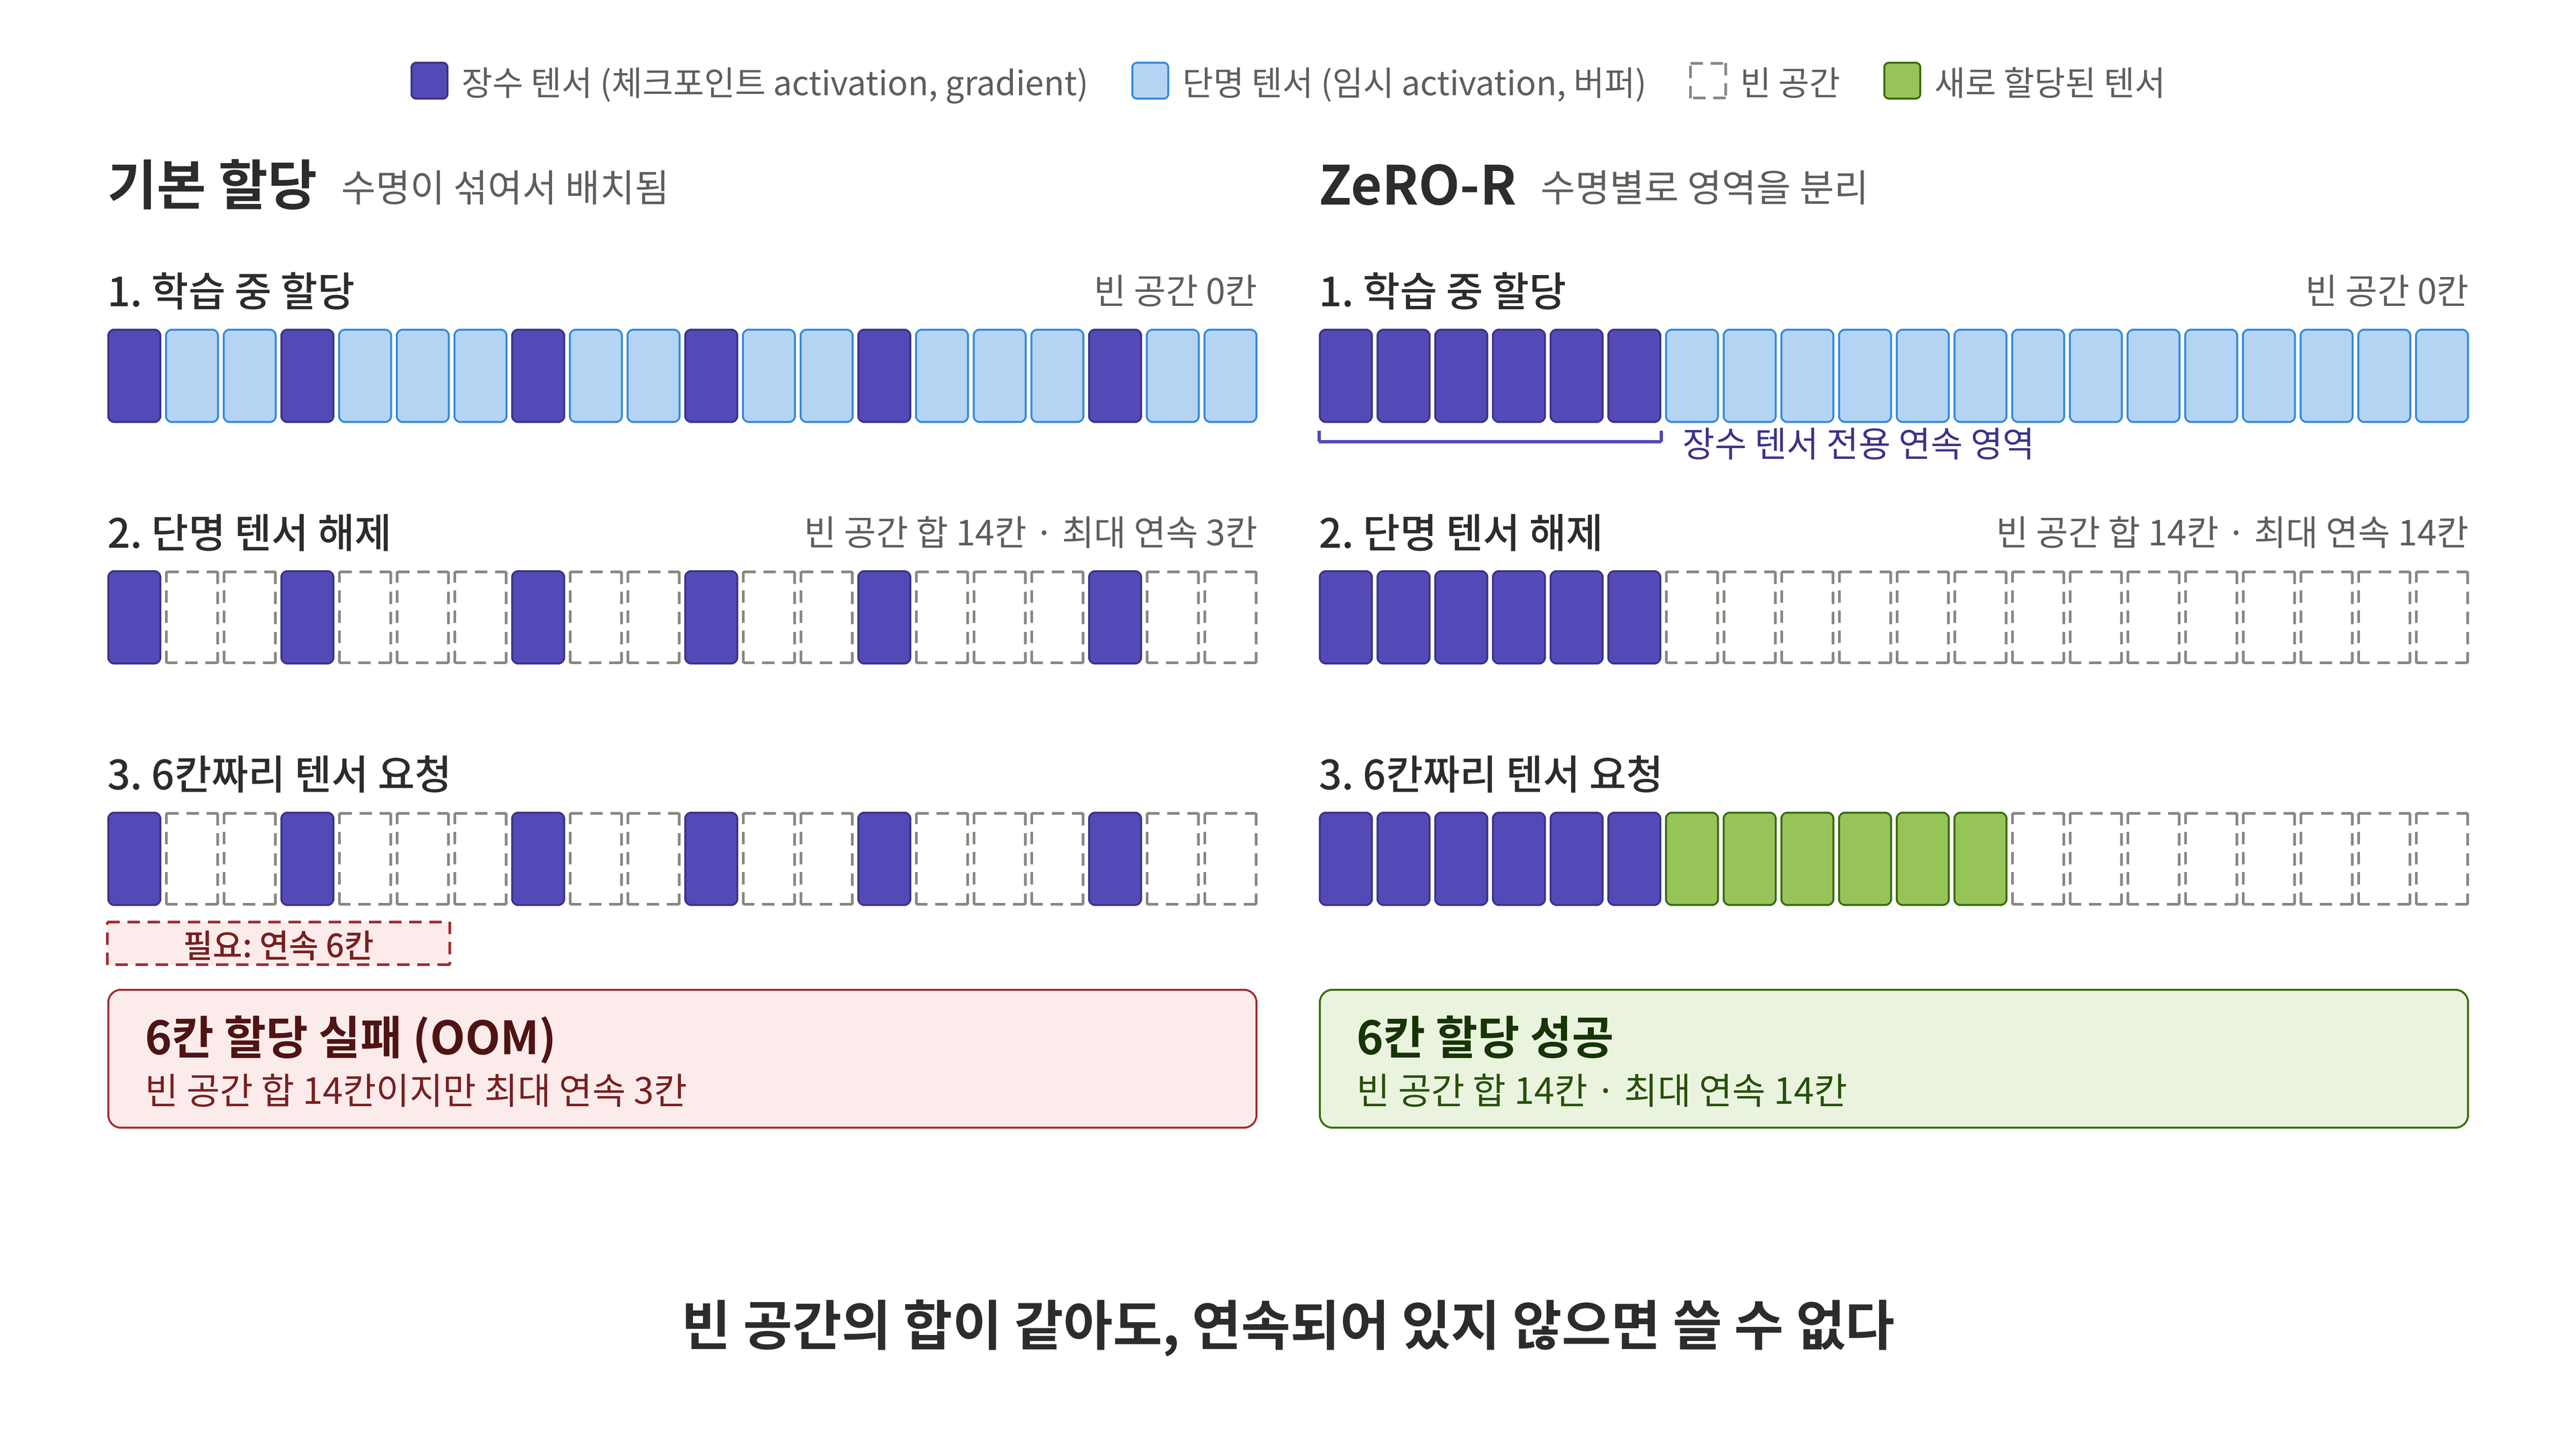
따라서 수명이 긴 텐서를 위한 공간을 미리 연속된 덩어리로 확보해 둔다. 그리고 수명이 긴 텐서가 생성될 때마다 메모리를 새로 할당받는 게 아니라 미리 예약해 둔 공간으로 복사해서 사용한다. 조각화된 메모리가 없으니 OOM 문제가 사라지고 처리 효율이 좋아진다.
ZeRO와 MP를 함께 쓰는 경우
ZeRO를 사용함으로써 모델을 GPU에 올리려고 MP를 쓸 필요는 줄었지만, 필요한 경우가 두 가지 남아 있다.
활성화 메모리가 너무 큰 경우
ZeRO-DP가 쪼개는 것은 파라미터, 그래디언트, 옵티마이저 상태뿐이다. 활성화 값은 각 GPU가 자기 배치에 대해 전부 들고 있다. 모델이 너무 크면 메모리가 부족할 수 있다.
이때 MP(여기서의 MP는 파이프라인 병렬이 아니라 weight를 쪼개는 방법)를 쓰면 한 레이어의 계산이 여러 GPU로 나뉘니까 GPU당 activation도 줄어든다. GPU1은 weight의 왼쪽 절반, GPU2는 오른쪽 절반을 맡는 식이다. 하지만 이때 중복으로 복제되는 부분이 생기는데, 이걸 ZeRO-R의 activation partitioning이 정리해 준다.
배치 크기가 너무 커지는 경우
GPU를 많이 사용해야 할 경우 전체 배치는 GPU 개수 곱하기 배치 크기가 된다. GPU 1024개에 배치가 4라면 총 4096배치가 된다. 배치가 너무 크면 학습이 잘 수렴하지 않는 문제가 있다.
이때 MP를 사용해서 GPU 일부를 묶어 글로벌 배치를 낮출 수 있다. MP 그룹 안의 GPU는 같은 데이터를 처리하기 때문이다. MP가 4라면 GPU 0, 1, 2, 3은 같은 데이터를 처리하므로 16배치가 4배치로 줄어든다.
통신량 분석
기존 DP와 비교한 ZeRO-DP의 통신량이다. 참고로 all-reduce = reduce-scatter + all-gather다.
옵티마이저 + 그래디언트 분할 단계
- 각 GPU는 자기 담당 구간의 gradient만 있으면 되니까, gradient는 all-reduce 대신 reduce-scatter 연산을 사용한다. 통신량 $= \Psi$
- 각 GPU가 자기 구간 파라미터를 업데이트하고 나면, 그 결과를 모든 GPU가 갖도록 all-gather 연산을 사용한다. 통신량 $= \Psi$
따라서 총 통신량은 $2\Psi$가 되며, 이는 기존 DP 방식과 통신량의 차이가 없으면서 메모리는 최대 8배 줄인다.
파라미터까지 분할한 단계
세 종류의 통신이 필요하다.
| 통신 | 통신량 | 용도 |
|---|---|---|
| gradient reduce-scatter | $\Psi$ | 업데이트하기 위한 가중치를 한곳에 모으는 통신 |
| forward 파라미터 all-gather | $\Psi$ | forward 가중치 브로드캐스트 통신 |
| backward 파라미터 all-gather | $\Psi$ | backward 가중치 브로드캐스트 통신 |
총 $3\Psi$로 기존 DP보다 1.5배 통신량이 많다. 메모리는 $N_d$배 줄이면서 통신량은 1.5배만 늘어나는 트레이드오프다.
성능
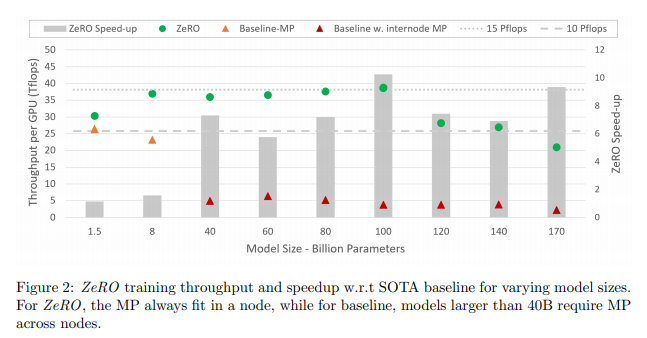
기존 시스템은 40B 파라미터를 넘어서면 효율적으로 확장이 불가능하지만, ZeRO는 100B 파라미터 모델을 GPU당 38TFlops 이상의 성능으로 실행할 수 있다.
댓글남기기