ReDiTT: Retrieval Augmented Conditional Diffusion Transformers for Asynchronous Time Series 논문정리
논문: ReDiTT: Retrieval Augmented Conditional Diffusion Transformers for Asynchronous Time Series (ICLR 2026 TSALM Workshop)
세미나 발표 자료를 정리한 글입니다. 비동기 시계열 예측에 검색(retrieval) 기반 조건을 붙인 latent diffusion transformer 모델입니다.
Abstract
- 비동기 시계열 데이터에서 다음 이벤트까지의 시간 간격과 이벤트 유형을 예측하기 위한 확산(diffusion) 기반 모델 ReDiTT 제안
- 학습과 추론 과정 모두에서 메모리 뱅크로부터 구조적으로 유사한 잠재(latent) 시퀀스를 검색하고, 이를 cross-attention으로 참조함
- 결과적으로 장기 예측을 안정화하고 샘플 다양성을 향상시킴. 7개의 실제 데이터셋에서 다음 이벤트 예측과 장기 예측 모두 SOTA 달성
비동기 시계열 데이터란?
비동기 시계열 데이터는 연속 시간 이벤트 시퀀스(continuous-time event sequence) 라고도 하며, 이벤트가 불규칙한 시간 간격으로 발생하는 데이터를 말한다.
- 의료: 환자가 병원을 방문하는 시점
- 금융: 비정상 거래가 발생하는 시각과 거래 종류
| 구분 | 일반(동기) 시계열 | 비동기 시계열 |
|---|---|---|
| 측정 간격 | 고정 (1초, 1분, 1일 …) | 불규칙 |
| 예시 | 주가(매일 종가), 기온(매시간) | 환자 입원 기록, 클릭 로그 |
| 예측 대상 | 다음 시점의 값 | 다음 이벤트의 시간과 종류 |
보통 Marked Temporal Point Process(TPP)로 모델링한다. $n$개의 이벤트로 이루어진 시퀀스는 다음과 같이 표현한다.
\[x_i = (t_i, e_i), \quad x = \{x_1, \dots, x_N\}\]- $t_i$: 직전 이벤트로부터의 시간 간격(inter-event time)
- $e_i$: 이벤트 유형(mark)
평가는 두 가지 과제로 한다.
- Next event prediction: 관측된 history $x_1, \dots, x_i$가 주어졌을 때 바로 다음 이벤트 $\hat{x}_{i+1} = (\hat{t}_{i+1}, \hat{e}_{i+1})$을 예측
- Long horizon prediction: 길이 $m$의 미래 이벤트 시퀀스 $\hat{x}_{i+1}, \dots, \hat{x}_{i+m}$을 한 번에 생성
Introduction
문제 배경
- 비동기 시계열은 의료, 금융, 사용자 행동 분석 등 다양한 분야에서 발생하며, 이벤트가 불규칙한 간격으로 일어나고 확률적이며 비정상적(nonstationary)인 특성을 가짐
- 기존의 autoregressive / likelihood 기반 TPP 모델들은 강한 모수적 가정이나 마르코프 구조에 의존해서, 복잡한 장기 패턴을 잘 잡지 못하는 한계가 있음
기존 diffusion 방법의 문제점
- 조건이 없거나 약한 diffusion 모델은 장기 예측이 어려움(Liu et al., 2024)
- 이미지와 달리 시계열에는 명시적인 label이나 의미 정보가 없어서 전역적인 조건 신호를 주기 어려움
- 그래서 장기 예측을 하면 개별 시퀀스의 특성을 살리지 못하고, 학습 데이터의 평균적인(높은 확률의) 패턴으로 흘러가버리는 경향이 있음
제안 방법
- 학습/추론 시 메모리 뱅크에서 유사한 시퀀스 top-k개를 검색
- 검색된 시퀀스를 cross-attention으로 조건으로 주입
- 이를 통해 장기 예측 안정화 + 샘플 다양성 향상
주요 기여
- 비동기 시계열 예측을 위한 최초의 검색 기반 diffusion 프레임워크 제안
- 검색된 정보를 효과적으로 통합하는 새로운 조건화(conditioning) 방식 제안
- 7개 실제 데이터셋에서 next event / long horizon 예측 SOTA 달성
Method
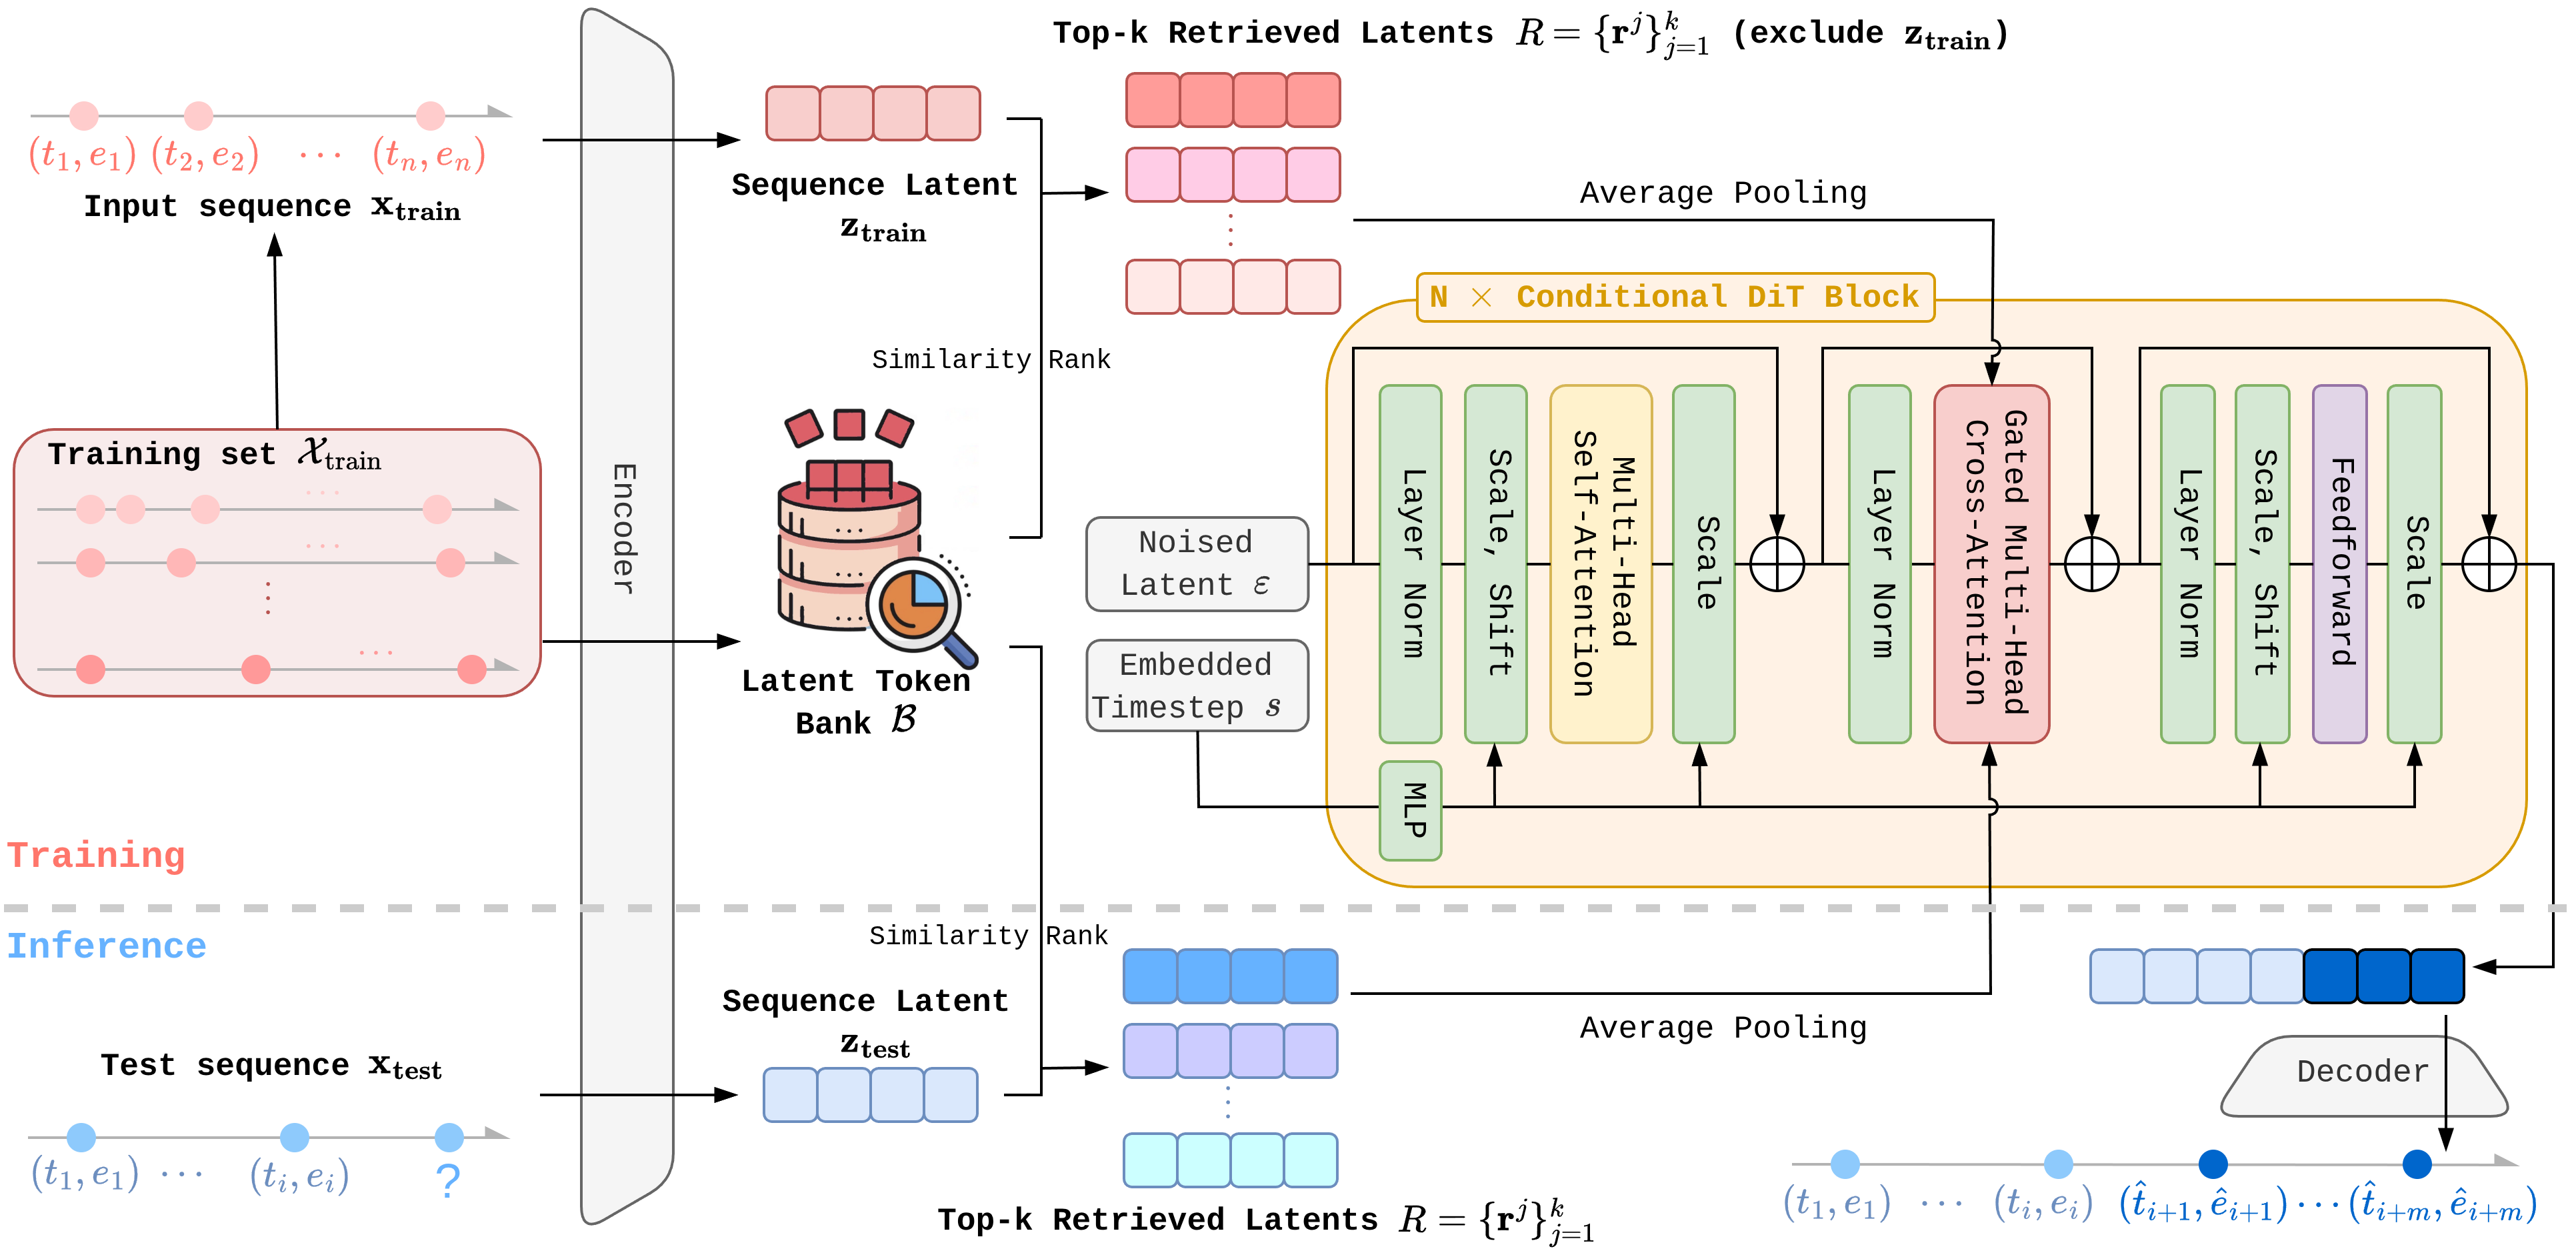
전체 구조는 다음과 같다.
- 학습: 학습 시퀀스 $x_{train}$을 사전학습된 VAE 인코더로 latent $z_{train}$으로 바꾸고, 학습셋 전체로 latent token bank $\mathcal{B}$를 만든다. 각 샘플마다 유사도가 높은 top-k latent를 검색해서 average pooling한 뒤, cross-attention으로 DiT에 조건으로 넣는다
- 추론: 관측된 prefix $x_{test}$를 인코딩하고 같은 방식으로 검색/집계한 뒤, reverse diffusion으로 미래 latent를 샘플링하고 디코더로 $(\hat{t}, \hat{e})$를 복원한다
Preliminary: 비동기 Flow Matching
ReDiTT는 ADiff4TPP(Mukherjee et al., 2025)의 latent flow matching 위에 구축된다.
1. VAE로 latent 압축
모든 시퀀스를 고정 길이 $N$으로 패딩하고, 사전학습된 VAE 인코더 $\mathcal{E}$로 latent로 바꾼다. 이 $z$ 하나가 flow matching의 학습 샘플 하나가 된다.
\[z = \mathcal{E}(x) \in \mathbb{R}^{N \times d}\]2. 비동기 행렬 보간(asynchronous matrix valued interpolation)
일반적인 rectified flow는 $z_s = (1-s)z + s\epsilon$처럼 모든 토큰에 같은 노이즈 레벨을 쓰지만, 여기서는 이벤트 위치마다 노이즈 스케줄을 다르게 준다.
\[z_s = A(s)\,z + \big(I - A(s)\big)\,\epsilon, \quad \epsilon \sim \mathcal{N}(0, I)\] \[A(s)_{ij} = \begin{cases} 0 & \text{if } i \neq j \\ \max\!\left(0,\ \min\!\left(\dfrac{2N - i - s(2N-1)}{N},\ 1\right)\right) & \text{if } i = j \end{cases}\]- $A(s) \in \mathbb{R}^{N \times N}$은 대각 행렬로, 이벤트 위치 $i$마다 별도의 노이즈 스케줄을 가짐
- $s=0$이면 $A(s)=I$(깨끗한 데이터), $s=1$이면 $A(s)=0$(순수 노이즈)
- 뒤쪽 이벤트(큰 $i$)일수록 더 이른 $s$에서 노이즈가 섞이기 시작함. 즉 모델은 시퀀스의 꼬리(미래)를 더 강한 노이즈 아래에서 복원하고 예측하도록 학습됨
3. 학습 목표
$z_s$를 $s$에 대해 미분하면 이동 방향(velocity)이 나온다.
\[\frac{dz_s}{ds} = A'(s)\,z - A'(s)\,\epsilon = A'(s)\,(z - \epsilon)\]$A’(s)$, $z$, $\epsilon$은 학습 시 모두 알고 있는 값이므로 정답 velocity를 바로 계산할 수 있다. 모델 $v_\theta$는 이 velocity를 회귀하도록 학습되고, $A’(s)$로 가중치를 준다.
\[\mathcal{L}_{\text{CFM}}(\theta) = \mathbb{E}_{s,\epsilon,z}\Big[\, \big\lVert A'(s)\big(v_\theta(z_s, A(s)) - u_s(z_s \mid \epsilon)\big) \big\rVert^2 \,\Big]\]4. 추론
관측된 history $z_1, \dots, z_n$은 그대로 두고, 예측할 미래 위치만 노이즈 $\epsilon_{n+1}, \dots, \epsilon_{n+m}$에서 시작한다. ODE를 풀 때 history 위치에는 정답 방향을, 미래 위치에는 모델이 예측한 velocity를 넣는다.
\[\frac{dz_s^{(i)}}{ds} = \begin{cases} A'(s)_{ii}\,(z_i - \epsilon_i) & \text{if } 1 \le i \le n \\ A'(s)_{ii}\,v_\theta(z_s, A(s))_i & \text{if } n < i \le n+m \end{cases}\]이렇게 얻은 $\hat{z}_{n+1}, \dots, \hat{z}_{n+m}$을 VAE 디코더로 원래 공간의 $(\hat{t}, \hat{e})$로 복원한다.
Masked Token Level Retrieval in Latent Space
원본 데이터가 아닌 latent space에서 검색하는 이유
- 연속형(시간 간격)과 이산형(이벤트 유형) 값이 섞여 있음
- 패딩 때문에 가변 길이 문제가 있음
- 같은 패턴이 시간축으로 밀려 있거나 이벤트 순서가 국소적으로 바뀌는 등 여러 정렬(alignment)이 가능함
- 그래서 Euclidean distance 같은 단순 거리는 스케일 차이, 희소성, 패딩에 쉽게 지배되어 유사도 계산이 어려움
→ 재구성을 위해 전역적인 동역학을 담도록 학습된 사전학습 VAE의 latent space에서 검색한다. 생성 대상과 같은 표현 공간이라 검색 결과를 조건으로 바로 쓰기에도 좋다.
시퀀스와 패딩 마스크는 다음과 같다. 마스크는 모든 시퀀스의 길이를 $N$으로 맞추기 위해 데이터 처리에서 흔히 쓰는 것이다.
\[x = \{x_1, \dots, x_N\}, \quad m \in \{0, 1\}^N\]학습 데이터 전체를 VAE로 인코딩해서 latent token bank를 미리 만들어 둔다.
\[\mathcal{B} = \big\{\, (z = \mathcal{E}(x),\ m) \;\big|\; x \in \mathcal{X}_{train} \,\big\}\]query $(q, m^q)$와 bank의 후보 $(r, m^r)$ 사이의 유사도는 둘 다 유효한(패딩이 아닌) 토큰 위치에서만 토큰별 cosine similarity를 계산해서 평균낸다.
\[\text{sim}(q, r) = \frac{1}{\sum_i \mathbf{1}\big[m_i^q \wedge m_i^r\big]} \sum_{i:\, m_i^q \wedge m_i^r} \frac{\langle \hat{q}_i, \hat{r}_i \rangle}{\lVert \hat{q}_i \rVert\, \lVert \hat{r}_i \rVert}\]- $q$: 학습/테스트 시퀀스의 latent, $r$: bank에 있는 latent
- $m^q$, $m^r$: 각각의 패딩 마스크
- $\hat{q}_i$, $\hat{r}_i$: L2 정규화된 토큰
- $\mathbf{1}[m_i^q \wedge m_i^r]$: query와 reference 둘 다 유효한 토큰인 위치만 사용
예를 들어 $q = [q_1, q_2, q_3, \text{pad}, \text{pad}]$, $r = [r_1, r_2, \text{pad}, \text{pad}, \text{pad}]$이면 둘 다 유효한 위치는 1, 2번뿐이므로
\[\text{sim}(q, r) = \frac{\cos(q_1, r_1) + \cos(q_2, r_2)}{2}\]최종적으로 유사도 순으로 top-k개의 reference를 뽑는다.
\[R(q) = \big\{\, r \;\big|\; \text{Top-K}_{r \in \mathcal{B}}\ \text{sim}(q, r),\ r \neq q \,\big\}\]학습 시에는 query 자신도 bank에 들어있어서 가장 유사한 결과가 자기 자신이 된다. 이게 조건 신호를 지배해버리므로 자기 자신은 제외하고 두 번째로 유사한 것부터 가져온다. 추론 시에는 학습셋으로 만든 bank에서 검색하므로 이런 문제가 없다.
Conditional Flow Matching with Retrieved References
기존 flow matching에 검색된 reference $R$을 조건으로 추가한다. 보간 경로($z_s$를 만드는 식)는 그대로이고, velocity field만 $R$을 조건으로 받는다.
\[\mathcal{L}_{\text{CFM}}(\theta) = \mathbb{E}_{s,\epsilon,z}\Big[\, \big\lVert A'(s)\big(v_\theta(z_s, A(s) \mid R) - u_s(z_s \mid \epsilon)\big) \big\rVert^2 \,\Big]\]- 현재 노이즈 상태 $z_s$에서, 위치별 노이즈 정도 $A(s)$를 참고하고, reference $R$을 조건으로 다음에 이동할 velocity를 예측
- $R$은 노이즈 $\epsilon$에서 $z$로 가는 경로 자체를 바꾸지는 않지만, 학습된 동역학이 해당 궤적과 일관된 해로 가도록 편향을 줌. 특히 장기 생성에 도움이 됨
- 추론 시에도 같은 학습 bank에서 검색하므로, 모델이 이미 본 시퀀스가 in-distribution 프로토타입 역할을 해서 먼 미래로 갈수록 생기는 drift를 줄여줌
Conditional Diffusion Transformer Architecture
기존 DiT의 한계
- DiT는 조건을 Adaptive Layer Normalization(AdaLN)으로 주입함. diffusion timestep이나 class label 같은 전역 벡터 하나로 모든 토큰을 똑같이 조절하는 방식
- 비동기 시계열에서 diffusion timestep은 샘플마다 다른(instance-specific) 의미가 없음
- 이벤트 label은 보통 coarse하거나 아예 없음
- 따라서 조건 신호가 약하고 모든 토큰에 똑같이 뿌려지는 문제가 있음
그래서 ReDiTT는 입력과 같은 형태의 시퀀스 모양 조건을 만들어서 cross-attention으로 넣는다.
1. 검색된 reference의 가중 평균
\[\bar{r} = \sum_{j=1}^{k} w_j\, r^j \in \mathbb{R}^{N \times d}, \qquad w_j = \frac{\exp\big(\text{sim}(z, r^j)\big)}{\sum_{l=1}^{k} \exp\big(\text{sim}(z, r^l)\big)}\]- 유사도가 높을수록 더 큰 영향을 줌
- softmax를 적용하므로 가중치 $w_j$의 합은 정확히 1
2. 입력 준비
DiT 블록에 들어가기 전에 latent $z$와 reference $\bar{r}$ 모두 채널 반복(channel repetition)으로 hidden size $D$까지 늘리고, 고정 positional embedding을 더한다. reference에는 마스크 $m_z$도 채널 방향으로 broadcast한다.
\[z = \text{Repeat}(z) + \text{pos}_z \in \mathbb{R}^{N \times D}, \qquad \bar{r} = \text{Repeat}(\bar{r}) + \text{pos}_r \in \mathbb{R}^{N \times D}\]positional embedding은 Transformer의 sinusoidal 방식과 같다. 위치 $p \in \lbrace 0, \dots, N-1 \rbrace$에 대해
\[\text{pos}(p) = \big[\sin(p\gamma),\ \cos(p\gamma)\big] \in \mathbb{R}^{D}, \qquad \gamma_i = 10000^{-\frac{i}{D/2}}, \quad i = 0, \dots, \tfrac{D}{2} - 1\]$z$와 $\bar{r}$은 차원이 같으므로 같은 positional embedding을 쓴다.
3. Cross-attention 연산
각 DiT 블록에서 self-attention 다음에 cross-attention을 넣는다. query는 현재 latent, key/value는 reference에서 나온다.
\[Q = W_q\big(\text{LN}(z)\big), \quad K = W_k\big(\text{LN}(\bar{r})\big), \quad V = W_v\big(\text{LN}(\bar{r})\big)\]$\eta$개의 head로 나눈 뒤, reference의 패딩 위치는 마스킹해서 attention을 계산한다.
\[\text{Attn} = \text{MaskedSoftmax}\left(\frac{QK^\top}{\sqrt{D/\eta}};\ m_r\right), \qquad Y = \text{Attn}\,V\]4. Gate 연산
attention 출력 $Y$를 $W_{out}$으로 투영하고 residual로 더할 때, 학습 가능한 스칼라 $c$에 sigmoid를 씌운 gate를 곱한다.
\[z \leftarrow z + \sigma(c) \cdot W_{out}\,Y\]- 처음에는 검색 신호를 약하게 반영하다가, 생성에 도움이 될 때만 점점 강하게 반영
- 검색 정보가 기본 동역학을 압도하지 않도록 안정적으로 조절
| 기존 AdaLN | ReDiTT Cross-Attention | |
|---|---|---|
| Conditioning 신호 | 전역 벡터 (timestep, label) | 검색된 시퀀스 (token-level) |
| 적용 방식 | 모든 토큰에 동일하게 | 각 토큰이 필요한 위치를 선택적으로 attend |
| 장기 예측 | drift 발생 | 구조적 안정성 유지 |
| 유연성 | 낮음 | sigmoid gate로 adaptive하게 조절 |
시간 정보는 어떻게 diffusion 하는가?
diffusion으로 시간 간격 $t$와 이벤트 유형 $e$ 두 개를 생성해야 하는데, 연속값인 $t$와 이산값인 $e$를 직접 diffusion하지 않고 VAE latent로 합쳐서 diffusion한다.
- $(\Delta t, e)$ → VAE 인코더 → $z$로 압축
- 학습: $(\Delta t, e)$ → VAE 인코더 → $z$ → 노이즈 추가 → $z_s$ → velocity 예측 학습
- 예측: history latent + 미래 위치의 가우시안 노이즈 → ODE 풀기 → 미래 latent $\hat{z}$ → VAE 디코더 → $(\hat{t}, \hat{e})$
VAE는 이벤트 $x = (t, e)$ 하나를 latent $z$로 보내는 $\beta$-VAE이고, 디코더가 $\tilde{x} = (\tilde{t}, \tilde{e})$ 두 가지를 동시에 출력한다. loss도 시간과 이벤트 유형을 각각 따로 계산한다.
\[\mathcal{L} = (t - \tilde{t})^2 + \text{CE}(e, \tilde{e}) + \beta\, \mathcal{L}_{KL}\]- 시간: MSE, 이벤트 유형: Cross Entropy
- $\mathcal{L}_{KL}$: latent 분포가 표준 정규분포 $\mathcal{N}(0, I)$를 따르도록 강제하는 정규화 항이고, $\beta$로 세기를 조절
Experiments
데이터셋
- TPP 데이터셋 5개: Amazon(16 types), Retweet(3), StackOverflow(22), Taobao(20), Taxi(10)
- 행동(action) 데이터셋 2개: Breakfast(177 classes), MultiThumos(65 classes)
평가 지표
- Next event: 시간 간격 RMSE(↓), 이벤트 유형 Accuracy(↑)
- Long horizon: 예측 시퀀스와 정답 시퀀스 사이의 OTD(Optimal Transport Distance, ↓). 일종의 edit distance로, horizon $m = 5, 10, 20, 30$에서 측정
Next Event Prediction
| Model | Amazon | Retweet | StackOverflow | Taobao | Taxi | Breakfast | MultiThumos |
|---|---|---|---|---|---|---|---|
| RMTPP | 0.559 / 29.6 | 26.207 / 51.6 | 1.246 / 42.4 | 0.257 / 43.6 | 0.351 / 88.5 | 1.080 / 4.8 | 7.357 / 0.1 |
| NHP | 0.640 / 30.0 | 22.511 / 53.9 | 1.324 / 26.8 | 0.168 / 49.3 | 0.342 / 87.0 | 1.168 / 4.9 | 7.309 / 9.9 |
| SAHP | 0.517 / 32.0 | 21.708 / 54.0 | 1.327 / 42.3 | 0.154 / 46.4 | 0.335 / 88.1 | 1.130 / 4.8 | 7.674 / 10.3 |
| THP | 0.550 / 34.6 | 26.176 / 59.5 | 1.424 / 42.0 | 0.314 / 45.6 | 0.375 / 87.3 | 1.134 / 1.3 | 9.254 / 13.0 |
| AttNHP | 0.755 / 31.9 | 22.296 / 57.2 | 1.350 / 44.6 | 0.280 / 47.1 | 0.429 / 85.2 | 1.123 / 4.7 | 7.887 / 14.9 |
| IFTPP | 0.465 / 35.1 | 22.198 / 60.0 | 1.884 / 45.5 | 0.598 / 55.9 | 0.357 / 91.4 | 3.654 / 9.2 | 8.980 / 14.3 |
| DTPP | 0.619 / 34.5 | 24.680 / 59.7 | 1.780 / 39.3 | 0.587 / 46.7 | 0.302 / 87.9 | - | - |
| Add&Thin | 0.461 / - | 22.914 / - | 1.469 / - | 0.440 / - | 0.368 / - | - | - |
| HYPRO | 0.583 / 33.8 | 20.562 / 60.0 | 1.417 / 44.9 | 0.307 / 55.1 | 0.383 / 86.5 | - | - |
| ADiff4TPP | 0.413 / 33.7 | 17.480 / 60.7 | 1.524 / 34.8 | 0.140 / 57.4 | 0.309 / 85.6 | 1.360 / 8.2 | 5.981 / 16.3 |
| ReDiTT (k=1) | 0.410 / 49.5 | 15.238 / 69.6 | 1.240 / 41.9 | 0.134 / 58.8 | 0.253 / 92.8 | 1.210 / 10.8 | 5.800 / 17.2 |
| ReDiTT (k=7) | 0.352 / 60.9 | 13.429 / 78.5 | 1.048 / 53.0 | 0.140 / 59.3 | 0.239 / 94.5 | 1.054 / 15.1 | 4.797 / 25.0 |
Table 1. 각 칸은 RMSE(↓) / Accuracy %(↑). ADiff4TPP가 조건 없는 diffusion baseline이다.
- 가장 강한 baseline인 ADiff4TPP 대비 평균 RMSE 22% 감소(3.887 → 3.008), 평균 이벤트 유형 정확도 12%p 상승(42.4% → 55.2%)
- 특히 이벤트 유형 수는 많은데 학습 데이터가 적은 Breakfast(177 types, 8.2% → 15.1%)와 MultiThumos(65 types, 16.3% → 25.0%)에서 효과가 큼. 클래스당 학습 데이터가 부족할수록 검색된 예시가 좋은 가이드가 됨
Long Horizon Prediction
| Model | Amazon | Retweet | StackOverflow | Taobao | Taxi | Breakfast | MultiThumos |
|---|---|---|---|---|---|---|---|
| HYPRO | 7.0 / 13.0 / 26.1 / 34.1 | 9.0 / 19.7 / 30.7 / 39.0 | 7.3 / 12.2 / 29.2 / 36.8 | 5.8 / 11.4 / 20.8 / 30.7 | 3.4 / 5.8 / 10.0 / 13.9 | - | - |
| ADiff4TPP | 6.2 / 12.4 / 24.7 / 32.9 | 9.1 / 17.7 / 28.0 / 31.7 | 6.5 / 12.0 / 22.3 / 30.1 | 4.9 / 9.9 / 20.4 / 31.1 | 2.4 / 4.0 / 6.8 / 9.4 | 8.8 / 17.1 / 24.3 / 28.9 | 8.2 / 13.6 / 21.1 / 20.2 |
| ReDiTT (k=1) | 5.9 / 11.5 / 21.3 / 27.8 | 9.1 / 17.3 / 26.9 / 30.1 | 6.1 / 10.8 / 19.4 / 27.4 | 4.8 / 9.8 / 19.8 / 30.7 | 2.6 / 4.4 / 7.9 / 12.7 | 8.7 / 16.1 / 22.1 / 27.0 | 8.2 / 14.3 / 20.6 / 19.6 |
| ReDiTT (k=7) | 5.7 / 10.7 / 19.7 / 25.8 | 9.1 / 17.2 / 26.5 / 29.6 | 6.0 / 10.7 / 18.9 / 27.4 | 4.6 / 9.4 / 19.4 / 29.5 | 3.5 / 5.0 / 9.2 / 17.6 | 8.2 / 15.4 / 21.6 / 26.4 | 8.2 / 14.1 / 20.6 / 19.6 |
Table 1 일부. 각 칸은 horizon m = 5 / 10 / 20 / 30에서의 OTD(↓). RNN/Attention 기반 baseline들은 대부분 ADiff4TPP보다 크게 높아서 생략했다.
- Taxi를 제외한 6개 데이터셋에서 ADiff4TPP보다 OTD가 낮음
- horizon이 길어질수록 차이가 커짐. Amazon에서 m=10일 때 12.4 → 10.7, m=30일 때 32.9 → 25.8
- 학습 데이터에서 궤적이 비슷한 예시를 명시적인 맥락으로 넣어주기 때문에, 여러 미래 이벤트를 시간 순서와 장거리 구조를 유지하면서 일관되게 생성할 수 있음
Ablation
1. Conditioning 방식: AdaLN vs Cross-attention (k=1)
| Dataset | Condition | RMSE ↓ | Acc % ↑ | OTD ↓ (5 / 10 / 20 / 30) |
|---|---|---|---|---|
| Amazon | uncondition | 0.413 | 33.7 | 6.2 / 12.4 / 24.7 / 32.9 |
| adaLN | 0.460 | 51.0 | 7.7 / 15.2 / 28.7 / 36.1 | |
| crossattn | 0.410 | 49.5 | 5.9 / 11.5 / 21.3 / 27.8 | |
| StackOverflow | uncondition | 1.524 | 34.8 | 6.5 / 12.0 / 22.3 / 30.1 |
| adaLN | 1.012 | 51.3 | 9.4 / 18.8 / 37.3 / 55.5 | |
| crossattn | 1.240 | 41.9 | 6.1 / 10.8 / 19.4 / 27.4 | |
| Taxi | uncondition | 0.309 | 85.6 | 2.4 / 4.0 / 6.8 / 9.4 |
| adaLN | 0.263 | 94.0 | 6.8 / 11.8 / 23.4 / 34.7 | |
| crossattn | 0.253 | 92.8 | 2.6 / 4.4 / 7.9 / 12.7 |
Table 3 일부(5개 데이터셋 중 3개)
- AdaLN은 next event 정확도를 올리는 경우도 있지만, 장기 예측 OTD는 조건이 없을 때보다도 크게 나빠짐. 효과가 단기/국소적인 예측에만 머무름
- 이미지 생성에서는 class label처럼 샘플 전체에 공통인 전역 신호라 AdaLN이 잘 맞지만, 비동기 시계열의 검색 결과는 이벤트와 시간마다 정보가 달라서 각 토큰이 골라서 참조할 수 있는 cross-attention이 더 적합함
- cross-attention이 연산도 더 싸고 수렴도 빠름
2. Reference 집계 방식과 k (StackOverflow)
| 방식 | k | RMSE ↓ | Acc % ↑ | OTD ↓ (5 / 10 / 20 / 30) |
|---|---|---|---|---|
| uncondition | - | 1.524 | 34.8 | 6.5 / 12.0 / 22.3 / 30.1 |
| - | 1 | 1.240 | 41.9 | 6.1 / 10.8 / 19.4 / 27.4 |
| concatenation | 3 | 1.244 | 42.1 | 6.2 / 10.9 / 19.6 / 27.8 |
| 5 | 1.174 | 47.1 | 6.1 / 10.9 / 19.7 / 27.9 | |
| 7 | 1.163 | 44.9 | 6.0 / 11.1 / 19.7 / 27.6 | |
| average pooling | 3 | 1.126 | 48.7 | 6.0 / 10.7 / 19.2 / 27.8 |
| 5 | 1.101 | 50.6 | 6.0 / 10.7 / 19.4 / 28.8 | |
| 7 | 1.048 | 53.0 | 6.0 / 10.7 / 18.9 / 27.4 |
Table 4
- 같은 k에서 average pooling이 concatenation보다 항상 좋고, k가 커질수록 차이가 벌어짐
- pooling은 유사도 가중치가 높은 reference들에 공통적인 신호는 강조하고 관련 없는 정보는 줄여주는 robust한 집계 역할을 함. 반면 concatenation은 조건 길이가 k에 비례해 늘어나서 관련 없는 검색 결과에 노출이 많아지고 노이즈에 overfit하기 쉬움(k=7 정확도가 k=5보다 낮음)
- average pooling에서는 k가 커질수록 RMSE와 정확도가 꾸준히 좋아지고(정확도 k=1 41.9% → k=7 53.0%), OTD는 거의 그대로 유지됨
3. 시간/유형 조건 성분 (Taobao, k=1)
| 조건 | RMSE ↓ | Acc % ↑ | OTD ↓ (5 / 10 / 20 / 30) |
|---|---|---|---|
| time & type | 0.134 | 58.5 | 4.8 / 9.8 / 19.8 / 30.7 |
| time only | 0.135 | 59.1 | 4.7 / 9.9 / 20.3 / 31.2 |
| type only | 0.134 | 61.1 | 4.9 / 10.2 / 20.9 / 31.5 |
Table 5
- 시간만 조건으로 주면 짧은 horizon(m=5)에서는 약간 좋지만 긴 horizon에서는 나빠짐. 시간 정보만으로는 장기적으로 이벤트 의미를 유지하기 어려움
- 유형만 주면 정확도는 크게 오르지만 모든 horizon에서 OTD가 나빠짐
- 둘 다 주는 것이 장기 예측에서 가장 좋음
추론 속도: 시퀀스 하나의 one-step 예측에 ReDiTT 2.1초, 조건 없는 baseline(ADiff4TPP) 2.0초로 검색으로 인한 추가 비용은 크지 않음
Discussion
결론
- VAE latent space에서 구조적으로 유사한 시퀀스를 검색하고, 이를 DiT 블록의 cross-attention으로 주입하는 검색 기반 조건부 diffusion transformer 제안
- 순수한 파라미터 기반 조건으로는 잡기 어려운 궤적별 시간 패턴을 선택적으로 활용할 수 있음
- 7개 데이터셋에서 next event / long horizon 예측 모두 SOTA
한계
- reference bank를 들고 있어야 하고 추론 때마다 검색을 해야 해서 메모리와 지연시간이 늘어남
- 데이터가 작고 시퀀스가 짧은 경우에는 장거리 패턴 개선 효과가 제한적일 수 있음
향후 연구
- 예측 목표에 더 잘 맞는 검색용 표현 학습, reference weighting이나 retrieval dropout으로 조건을 더 강건하게
- 압축/계층적 reference bank와 캐싱으로 비용 절감
- 공변량이나 텍스트 같은 추가 맥락 활용, 장기 예측 지표를 직접 겨냥하는 학습 목표 탐색
댓글남기기