RT-1: Robotics Transformer for Real-World Control at Scale 논문정리
논문: RT-1: Robotics Transformer for Real-World Control at Scale
VLA 세미나 발표 자료를 정리한 글입니다. 이미지와 언어 지시문을 받아 로봇 행동 토큰을 출력하는 Transformer 정책으로, 이후 VLA(Vision-Language-Action) 모델들의 출발점이 된 논문입니다.
Abstract
- 대규모 데이터로 사전학습한 모델은 제로샷 또는 소량의 데이터만으로 특정 태스크를 잘 수행한다. 비전, 자연어, 음성인식에서는 이미 입증됐지만 로보틱스에서는 아직 입증되지 않았다. 실제 로봇 데이터는 수집하기 어렵기 때문에 일반화 능력이 특히 중요하다
- 논문은 범용 로봇 모델의 핵심이 개방형(task-agnostic) 학습과 다양한 로봇 데이터를 모두 흡수할 수 있는 고용량 아키텍처의 조합이라고 주장하며, 이를 위해 Robotics Transformer(RT-1)를 제안한다
- 실제 로봇이 실제 태스크를 수행하며 수집한 대규모 데이터로, 데이터 크기·모델 크기·데이터 다양성에 따라 여러 모델 구조의 일반화 능력이 어떻게 달라지는지 비교한다
Introduction
- 기존 로봇 학습은 특정 작업에 좁게 맞춘 소규모 데이터(단일/멀티태스크)로 이루어져서, NLP나 비전처럼 대규모 범용 학습을 하지 못했다
- 로봇 데이터는 엔지니어링 부담이 크고 사람이 직접 시연해야 하는 경우가 많아 수집 비용이 크다
- 좋은 일반화를 위해서는 데이터가 규모와 폭(다양성) 을 모두 갖춰야 하고, 태스크들이 서로 충분히 연결되어 있어야 모델이 구조적으로 비슷한 태스크 사이의 패턴을 찾아 새로운 조합의 태스크에 적용할 수 있다
- 이를 위해 13대의 로봇으로 17개월 동안 약 13만 에피소드, 700개 이상의 태스크 데이터셋을 구축했고, 입출력을 간결한 토큰으로 압축해서 실시간 제어가 가능한 Transformer 아키텍처 RT-1을 제안한다
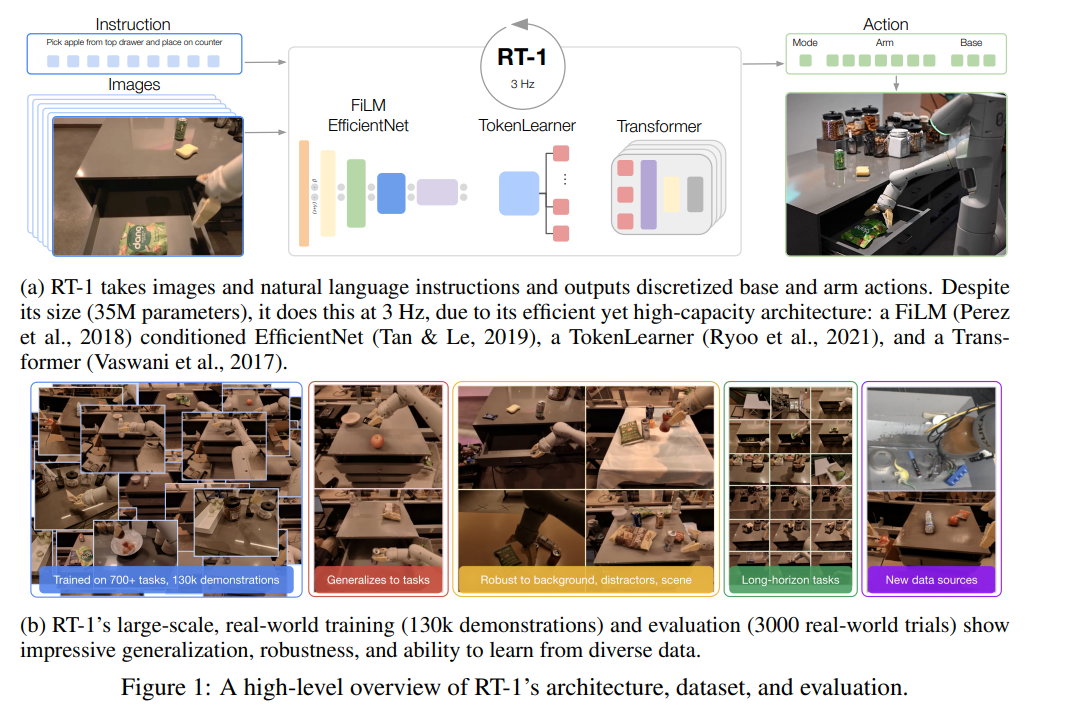
- RT-1은 이미지와 자연어 지시문을 입력받아 이산화된 이동 베이스(base) 행동과 로봇 팔(arm) 행동을 출력한다
- 35M 파라미터 규모지만, FiLM 기반 EfficientNet + TokenLearner + Transformer로 이루어진 효율적인 고용량 구조 덕분에 3Hz(초당 3번)로 행동을 낸다
- 학습한 700개 이상의 지시문을 97% 성공률로 수행하고, 다음으로 좋은 baseline보다 새로운 태스크, 방해 요소(distractor), 배경에서 각각 24%p, 36%p, 18%p 더 잘 일반화한다
Preliminaries
Robot learning
시점 $t=0$에 정책 $\pi$는 언어 지시문 $i$와 첫 이미지 관측 $x_0$를 받아 행동 분포를 만들고, 여기서 행동 $a_0$를 샘플링해서 로봇에 적용한다.
\[a_0 \sim \pi(\cdot \mid i, x_0)\]이후에도 매 시점 지금까지의 이미지 관측을 보고 행동을 샘플링하는 과정을 종료 조건이 될 때까지 반복한다.
\[a_t \sim \pi\left(\cdot \;\middle|\; i, \{x_j\}_{j=0}^{t}\right)\]시작 시점 $t=0$부터 종료 시점 $T$까지의 전체 상호작용을 에피소드라고 한다.
\[\left(i,\ \{(x_j, a_j)\}_{j=0}^{T}\right)\]에피소드가 끝나면 지시문을 제대로 수행했는지에 대한 이진 보상 $r \in \lbrace 0, 1 \rbrace$을 받고, 목표는 지시문, 초기 상태, 환경 동역학의 분포에 대해 평균 보상을 최대화하는 정책을 학습하는 것이다.
Transformers
Transformer는 입력 시퀀스를 출력 시퀀스로 바꾸는 시퀀스 모델이다. RT-1은 지시문과 이미지 $\left(i, \lbrace x_j \rbrace_{j=0}^{t}\right)$를 입력 토큰 시퀀스로, 행동 $a_t$를 출력 토큰 시퀀스로 바꾼 다음 Transformer로 둘 사이의 매핑을 학습한다.
\[\{\xi_h\}_{h=0}^{H} \;\longrightarrow\; \{y_k\}_{k=0}^{K}\]Imitation learning
사람의 시연 데이터 $\mathcal{D}$로 정책을 학습하는 모방학습을 사용한다. $\mathcal{D}$는 $N$개의 에피소드로 이루어져 있고, 모든 에피소드는 성공한 시연(최종 보상 1)이다.
\[\mathcal{D} = \left\{ \left( i^{(n)},\ \{(x_t^{(n)}, a_t^{(n)})\}_{t=0}^{T^{(n)}} \right) \right\}_{n=0}^{N}\]예를 들어 에피소드 하나는 “서랍에서 사과를 꺼내 조리대에 올려줘”라는 지시문과 (화면 0, 행동 0), (화면 1, 행동 1), …, (화면 T, 행동 T)로 이루어진다.
학습은 behavioral cloning으로, 이미지와 지시문이 주어졌을 때 사람이 실제로 한 행동의 음의 로그 우도(negative log-likelihood)를 최소화한다. 즉 사람이 했던 행동의 확률이 높아지도록 학습한다.
\[\min_{\pi}\ -\sum_{n=0}^{N} \sum_{t=0}^{T^{(n)}} \log \pi\left(a_t^{(n)} \;\middle|\; i^{(n)}, \{x_j^{(n)}\}_{j=0}^{t}\right)\]위 식은 논문의 서술(“minimizing the negative log-likelihood of actions given the images and language instructions”)을 식으로 옮긴 것이다. 실제 RT-1은 전체 이력 대신 최근 6장의 이미지만 입력으로 쓴다.
System Overview
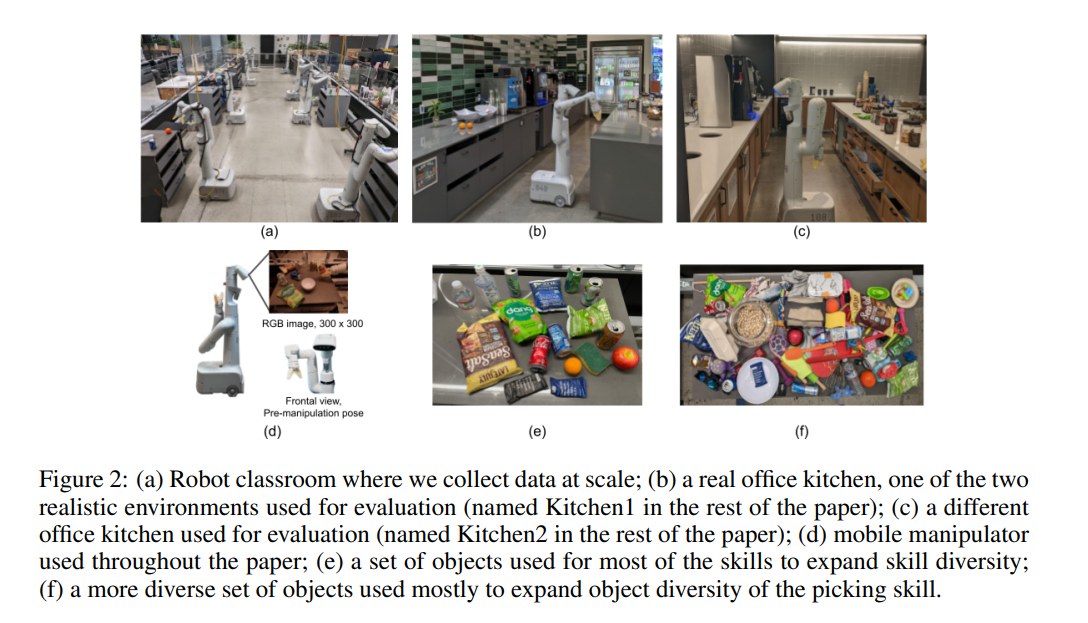
- 사용한 로봇은 Everyday Robots의 모바일 매니퓰레이터로, 7자유도 팔, 두 손가락 그리퍼, 이동 베이스로 구성된다
- 데이터 수집과 평가에는 주방 기반 환경 3곳을 사용한다
- Robot classroom: 실제 주방을 본떠 만든 학습용 환경. 대규모 데이터 수집을 위해 부분적인 조리대로 구성
- Kitchen1, Kitchen2: 실제 사무실 주방 2곳. 조리대는 학습 환경과 비슷하지만 조명, 배경, 전체 주방 구조(서랍 대신 찬장이 있거나 싱크대가 보이는 등)가 다르다
- 학습 데이터는 사람이 제공한 시연이고, 각 에피소드에는 로봇이 방금 수행한 지시문의 텍스트 설명을 주석으로 단다. 지시문은 대개 동사 하나와 대상 물체를 설명하는 하나 이상의 명사로 이루어진다
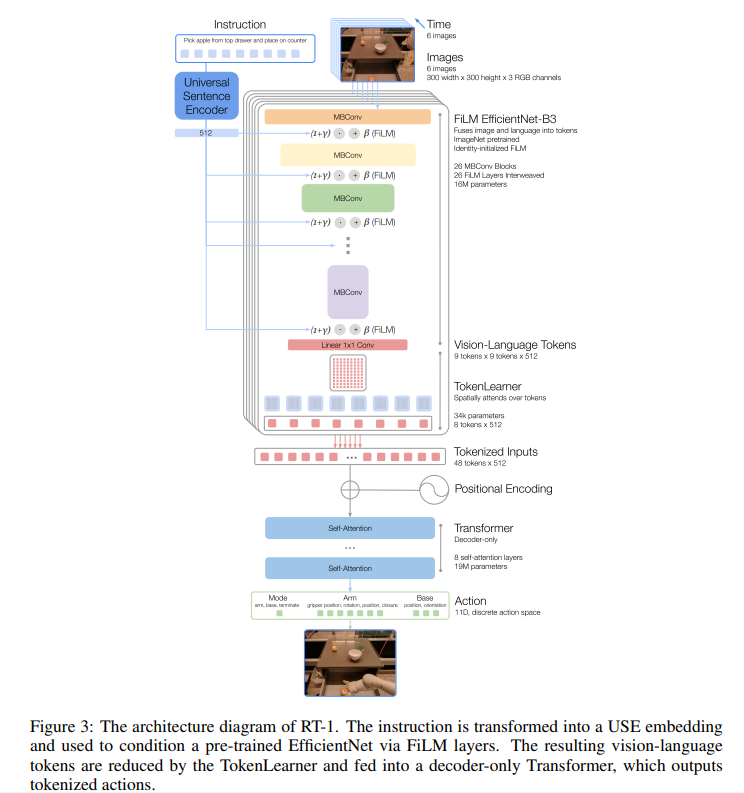
RT-1은 짧은 이미지 시퀀스와 자연어 지시문을 입력받아 매 시점 로봇의 행동을 출력한다.
- 이미지는 ImageNet으로 사전학습된 EfficientNet으로 처리하는데, 사전학습된 지시문 임베딩을 FiLM으로 주입해서 특징을 조절한다
- TokenLearner가 간결한 토큰 집합을 계산한다
- Transformer가 이 토큰들에 어텐션을 수행해 이산화된 행동 토큰을 생성한다
행동은 다음과 같이 구성된다.
- 팔(arm) 7차원: x, y, z, roll, pitch, yaw, 그리퍼 열림 정도
- 베이스(base) 3차원: x, y, yaw
- 모드 1차원: 팔 제어 / 베이스 제어 / 에피소드 종료 중 하나를 고르는 이산 변수
RT-1은 폐루프(closed-loop) 제어를 하며, “종료” 행동을 내놓거나 미리 정한 시간 스텝 한계에 도달할 때까지 3Hz로 행동을 명령한다.
Model
Instruction and image tokenization
- 최근 6장의 이미지(각 300×300)를 ImageNet 사전학습 EfficientNet-B3에 통과시키고, 마지막 conv 층에서 9×9×512 특징맵을 얻는다
- Gato처럼 이미지를 패치로 잘라 토큰을 만드는 대신, 특징맵을 펼쳐서 이미지당 81개의 시각 토큰으로 만든다
- 지시문은 Universal Sentence Encoder(USE) 로 512차원 임베딩을 만들고, 이 임베딩을 EfficientNet 중간에 넣은 FiLM 층의 입력으로 써서 이미지 인코더를 조건화한다. 덕분에 처음부터 지시문과 관련된 이미지 특징을 뽑을 수 있다 (early fusion)
FiLM은 언어 임베딩 $\ell$로부터 채널별 스케일 $\gamma$와 시프트 $\beta$를 만들어 이미지 특징 $\mathbf{x}$를 변조한다. RT-1은 Figure 3처럼 $(1+\gamma)$ 형태를 쓴다.
\[\text{FiLM}(\mathbf{x}) = (1 + \gamma) \odot \mathbf{x} + \beta, \qquad \gamma = f_c(\ell), \quad \beta = h_C(\ell)\]- 문제는 사전학습된 네트워크 내부에 FiLM 층을 끼워 넣으면 중간 활성화 값이 흐트러져서 사전학습 가중치의 이점이 사라진다는 것
- 그래서 $\gamma$와 $\beta$를 만드는 dense 층 $f_c$, $h_C$의 가중치를 0으로 초기화한다. 그러면 처음에는 $\gamma = 0$, $\beta = 0$이 되어 $\text{FiLM}(\mathbf{x}) = \mathbf{x}$, 즉 항등 함수로 동작하므로 사전학습된 기능이 보존된다 (identity-initialized FiLM)
- 이미지·지시문 토큰화 부분은 MBConv 블록 26개와 FiLM 층으로 이루어져 있고 총 16M 파라미터이며, 이미지당 81개의 vision-language 토큰을 출력한다
TokenLearner
- Transformer가 어텐션해야 하는 토큰 수를 줄여서 추론 속도를 높이기 위해 TokenLearner를 사용한다
- TokenLearner는 많은 수의 토큰을 훨씬 적은 수의 토큰으로 대응시키도록 학습하는 element-wise attention 모듈이다. 정보량에 따라 이미지 토큰을 soft하게 선택해서 중요한 토큰 조합만 다음 층으로 보낸다
- RT-1에서는 이미지당 81개 토큰을 8개로 줄인다. TokenLearner 자체도 학습되는 모듈(약 34k 파라미터)이라 학습하면서 토큰을 최적으로 압축하는 법을 배운다
Transformer
- 이미지당 8개의 토큰을 6장 분량 이어 붙여 총 48개 토큰($6 \times 8$)을 만들고, positional encoding을 더해 Transformer에 넣는다
- Transformer는 self-attention 8층, 19M 파라미터의 decoder-only 시퀀스 모델로, 행동 토큰을 출력한다
Action tokenization
- 11개의 행동 차원 각각을 256개 구간(bin) 으로 이산화한다. 구간은 각 변수의 최솟값~최댓값 범위 안에서 균등하게 나눈다
- 즉 11개 차원이 각각 256개 중 하나를 고르고, 그 11개를 모아서 하나의 행동을 만든다
차원 $d$의 연속값 $a^{(d)}$가 범위 $[a^{(d)}_{\min}, a^{(d)}_{\max}]$에 있을 때, 균등 구간화는 다음과 같이 쓸 수 있다.
\[b^{(d)} = \text{clip}\left( \left\lfloor \frac{a^{(d)} - a^{(d)}_{\min}}{a^{(d)}_{\max} - a^{(d)}_{\min}} \times 256 \right\rfloor,\ 0,\ 255 \right), \qquad d = 1, \dots, 11\]논문은 “bins are uniformly distributed within the bounds of each variable”이라고만 설명하므로, 위 식은 그 설명을 식으로 옮긴 예시다. 모드 차원은 원래 이산 변수라 3개 값만 쓰인다.
Loss
이전 Transformer 기반 제어기(Gato, Decision Transformer 계열)에서 쓰던 categorical cross-entropy와 causal masking을 그대로 쓴다. 각 행동 차원의 정답 bin $b_t^{(d)}$에 대한 분류 문제로 보면
\[\mathcal{L} = -\sum_{d=1}^{11} \log p_\theta\left(b_t^{(d)} \;\middle|\; i, x_{t-5:t}\right)\]마찬가지로 논문의 서술을 식으로 정리한 것이다. Gato와 달리 RT-1은 행동 토큰을 자기회귀적으로 하나씩 생성하지 않는다. 자기회귀 방식은 성능 이득 없이 추론만 2배 넘게 느려졌기 때문이다(아래 Model ablation 참고).
Inference speed
- 사람이 이 지시문들을 수행하는 데 2~4초가 걸리므로, 모델이 이보다 크게 느리면 안 된다. 이를 위해 최소 3Hz 제어가 필요하고, 시스템의 다른 지연까지 고려하면 모델 추론 시간은 100ms 이하여야 한다
- 두 가지 기법으로 추론을 빠르게 한다
- TokenLearner로 토큰 수를 줄임 → 2.4배 가속
- 6장 윈도우는 한 칸씩 밀리므로, 이전 시점에 이미 계산한 5장의 토큰은 재사용하고 새로 들어온 1장만 계산 → 1.7배 가속
- 추가로 행동이 일정한 주기로 나가도록(jitter 방지), 상태를 캡처한 뒤 고정 시간(280ms, 모든 구성 요소의 최대 지연)만큼 기다렸다가 행동을 적용한다
Data
- 목표는 높은 성능, 새로운 작업에 대한 일반화, 방해 요소와 배경에 대한 강건성이다. 이를 위해 다양한 작업, 사물, 환경을 포함한 대규모 데이터셋을 구축했다
- 13대의 로봇, 17개월, 13만 개의 시연. 데이터는 robot classroom이라고 부르는 사무실 주방 구역에서 수집했다
- 문헌마다 “태스크”의 정의가 달라서, 이 논문은 언어 지시문(동사 + 하나 이상의 명사, 예: “place water bottle upright”)의 개수를 센다. RT-1은 700개 이상의 지시문을 수행할 수 있다
- 지시문을 동사 기준으로 묶은 것을 스킬(skill) 이라고 부른다
| Skill | 지시문 수 | 설명 | 예시 |
|---|---|---|---|
| Pick Object | 130 | 물체를 표면에서 들어 올림 | pick iced tea can |
| Move Object Near Object | 337 | 첫 번째 물체를 두 번째 물체 근처로 옮김 | move pepsi can near rxbar blueberry |
| Place Object Upright | 8 | 길쭉한 물체를 세움 | place water bottle upright |
| Knock Object Over | 8 | 길쭉한 물체를 넘어뜨림 | knock redbull can over |
| Open Drawer | 3 | 서랍 열기 | open the top drawer |
| Close Drawer | 3 | 서랍 닫기 | close the middle drawer |
| Place Object into Receptacle | 84 | 물체를 용기 안에 넣음 | place brown chip bag into white bowl |
| Pick Object from Receptacle and Place on the Counter | 162 | 용기에서 물체를 꺼내 조리대에 올림 | pick green jalapeno chip bag from paper bowl and place on counter |
| 6.3, 6.4절용 스킬 | 9 | 현실적인 긴 지시문용 | pull napkin out of dispenser |
| Total | 744 |
Table 1. 스킬 목록
Experiments
논문은 다음 5가지 질문에 답한다.
- RT-1이 많은 수의 지시문을 학습하고, 새로운 작업·사물·환경에 제로샷으로 일반화할 수 있는가? (6.2절)
- 시뮬레이션 데이터나 다른 로봇의 데이터처럼 이질적인 데이터를 섞어서 성능을 더 끌어올릴 수 있는가? (6.3절)
- 여러 방법들이 장기(long-horizon) 로봇 시나리오에 어떻게 일반화되는가? (6.4절)
- 데이터의 양과 다양성에 따라 일반화 지표가 어떻게 변하는가? (6.5절)
- 모델 설계에서 중요하고 실용적인 결정은 무엇이고, 성능과 일반화에 어떤 영향을 주는가? (부록 D.4)
비교 대상
Gato와 BC-Z(그리고 크기를 키운 BC-Z XL)를 비교한다. 원래 모델로는 평가에 필요한 일반화가 어렵기 때문에 모두 RT-1과 같은 데이터로 학습했다.
- Gato: RT-1처럼 Transformer 기반이지만 차이가 있다
- 이미지 토큰을 언어 정보 없이, 이미지 패치별로 따로 만든다 (RT-1은 FiLM으로 언어를 일찍 섞고 전역 이미지 특징을 씀)
- 사전학습된 텍스트 임베딩을 쓰지 않는다
- TokenLearner나 자기회귀 행동 제거 같은 실시간 추론용 최적화가 없다
- 원래 1.2B 파라미터(로봇에서 추론 1.9초)인데, 실제 로봇에서 돌리기 위해 RT-1(35M)과 비슷한 37M으로 줄였다
- BC-Z: ResNet 기반 피드포워드 모델로 SayCan에서 쓰였다. 이전 시점 이미지를 쓰지 않고, 이산 토큰 대신 연속 행동을 출력한다. RT-1과 비슷한 크기로 키운 BC-Z XL도 함께 비교한다
Experimental Setup
평가는 Everyday Robots의 모바일 매니퓰레이터로 세 환경(실제 사무실 주방 2곳, 이를 본뜬 학습 환경 1곳)에서 진행했고, 총 3000번 이상의 실제 로봇 시도로 평가했다.
- Seen tasks: 학습한 지시문 중 200개 이상(집기 36, 넘어뜨리기 35, 세우기 35, 옮기기 48, 서랍 열고 닫기 18, 서랍에 넣고 꺼내기 36)으로 평가. 같은 지시문이라도 물체 배치, 시간대, 로봇 위치 등을 바꿔서 현실적인 변화에 대한 일반화도 함께 본다
- Unseen tasks: 21개의 새 지시문으로 평가. 각 스킬과 물체는 학습 데이터에 있었지만, 그 조합은 처음 보도록 구성 (예: “pick up the apple”을 빼도 사과가 들어간 다른 지시문은 학습에 있음)
- Robustness: 방해 요소 30개 작업, 배경 22개 작업으로 평가. 배경은 새로운 주방, 무늬 있는 식탁보 등으로 바꿔서 테스트
- Long-horizon: 두 실제 주방에서 15개의 장기 지시문으로 평가. 각 지시문은 SayCan으로 10개 정도의 단계로 분해되며, 여러 일반화 축을 한꺼번에 시험한다
1. 많은 지시문 학습과 일반화
| Model | Seen Tasks | Unseen Tasks | Distractors | Backgrounds |
|---|---|---|---|---|
| Gato | 65 | 52 | 43 | 35 |
| BC-Z | 72 | 19 | 47 | 41 |
| BC-Z XL | 56 | 43 | 23 | 35 |
| RT-1 | 97 | 76 | 83 | 59 |
Table 2. 성공률(%)
- RT-1은 모든 범주에서 Gato, BC-Z, BC-Z XL보다 크게 높다
- Seen: 97%로 BC-Z보다 25%p, Gato보다 32%p 높음
- Unseen: 76%로 다음으로 좋은 Gato보다 24%p 높음
- Distractors / Backgrounds: 83% / 59%로 다음으로 좋은 BC-Z보다 각각 36%p, 18%p 높음
- 모든 모델이 같은 데이터로 학습됐고 비교 대상은 모델 구조뿐이다. 논문이 구축한 크고 다양한 데이터셋의 혜택을 baseline도 똑같이 받기 때문에, 이 비교는 오히려 기존 모델들에게 유리한 조건이라고 주장한다
현실적인 시나리오로의 일반화
실제 주방에서 간식을 서랍에 채우기, 넘어진 양념병 정리, 간식 준비, 잃어버린 물건 찾기 같은 과제를 수행하며 일반화 레벨별로 평가했다.
- L1: 새로운 조리대 배치와 조명 조건에 대한 일반화
- L2: L1 + 학습 때 보지 못한 방해 물체
- L3: L2 + 크게 달라진 작업 환경, 새로운 작업 물체, 싱크대 근처처럼 처음 보는 위치
| Model | All | L1 | L2 | L3 |
|---|---|---|---|---|
| Gato | 30 | 63 | 25 | 0 |
| BC-Z | 45 | 38 | 50 | 50 |
| BC-Z XL | 55 | 63 | 75 | 38 |
| RT-1 | 70 | 88 | 75 | 50 |
Table 3. 성공률(%)
- RT-1은 전체(All) 성공률이 가장 높고 L1에서도 가장 높다. L2는 BC-Z XL과, L3는 BC-Z와 공동 1위로, 모든 레벨에서 가장 강건하다
- Gato는 L1에서는 괜찮지만 어려운 레벨로 갈수록 크게 떨어진다(L3에서 0%)
2. 이질적인 데이터 흡수
시뮬레이션 데이터
실제 데이터는 그대로 두고, 실제로는 한 번도 본 적 없는 물체가 포함된 시뮬레이션 데이터를 추가했다. 평가는 모두 실제 로봇에서 했다.
| Training Data | Real Objects: Seen Skill | Sim Objects: Seen Skill | Sim Objects: Unseen Skill |
|---|---|---|---|
| Real Only | 92 | 23 | 7 |
| Real + Sim | 90 (-2) | 87 (+64) | 33 (+26) |
Table 4. Sim Objects는 시뮬레이션에서만 등장한 물체. Unseen Skill은 해당 물체로 그 스킬을 수행하는 예시가 시뮬레이션에도 실제에도 없는 경우 (예: 시뮬레이션에서 “pick X”만 했던 물체 X로 “move X to apple”)
- 시뮬레이션 데이터를 추가해도 기존 성능은 거의 유지됨 (92 → 90)
- 시뮬레이션에서만 본 물체를 실제 환경에서 다루는 성능이 23% → 87% 로 크게 올라 실제 물체 수준에 가까워짐 → 도메인 간 전이가 잘 됨
- 시뮬레이션에서만 본 물체에 대해, 학습에 전혀 없던 지시문 성능도 7% → 33% 로 오름
다른 로봇의 데이터
QT-Opt에서 Kuka IIWA 로봇이 수집한 bin-picking 성공 에피소드 209k개를 기존 EDR(Everyday Robots) 데이터와 섞었다. 두 데이터는 로봇 외형, 행동 공간, 환경이 모두 다르고, Kuka 데이터는 사람 시연이 아니라 강화학습 에이전트가 수집한 것이라 행동 분포도 완전히 다르다.
| Training Data | Classroom eval | Bin-picking eval |
|---|---|---|
| Kuka bin-picking + EDR | 90 (-2) | 39 (+17) |
| EDR only | 92 | 22 |
| Kuka bin-picking only | 0 | 0 |
Table 5
- Kuka 데이터를 섞어도 기존 평가(Classroom eval)는 2%p만 떨어짐
- Kuka 환경과 비슷하게 만든 새로운 bin-picking 평가에서는 22% → 39% 로 약 2배 향상
- Kuka 데이터만으로 학습하면 EDR 로봇에서 0% → 다른 로봇 형태에서 행동을 그대로 옮기기는 어렵지만, 두 데이터를 섞으면 EDR 로봇에서 bin-picking 시연이 없어도 Kuka의 경험을 활용할 수 있음
- RT-1은 시뮬레이션이나 다른 로봇처럼 매우 다른 도메인의 데이터도 기존 성능을 거의 해치지 않고 흡수하고, 그 데이터로 새로운 스킬을 얻을 수 있다
3. Long-horizon 시나리오
RT-1과 baseline들을 SayCan 프레임워크의 저수준 조작 정책으로 넣어서 두 실제 주방에서 장기 과제를 수행했다. SayCan은 고수준 지시문(예: “테이블 위 물건을 다 버려줘”)을 여러 단계의 저수준 지시문으로 나눠 실행한다. 단계가 길수록 성공률이 지수적으로 떨어지므로 개별 스킬의 성공률이 특히 중요하다.
| Model | Kitchen1 Planning | Kitchen1 Execution | Kitchen2 Planning | Kitchen2 Execution |
|---|---|---|---|---|
| Original SayCan* | 73 | 47 | - | - |
| SayCan w/ Gato | 87 | 33 | 87 | 0 |
| SayCan w/ BC-Z | 87 | 53 | 87 | 13 |
| SayCan w/ RT-1 | 87 | 67 | 87 | 67 |
Table 6. *원래 SayCan은 약간 다른 프롬프트를 써서 planning 성공률이 낮다
- 원래 SayCan을 제외하면 모든 방법의 planning 성공률은 87%로 같고, 실행 성공률은 RT-1이 Kitchen1에서 67%로 가장 높다
- Kitchen2는 학습 환경(Kitchen1을 본뜸)과 많이 달라 훨씬 어려운 일반화 환경인데, Gato는 하나도 완료하지 못하고(0%) BC-Z는 13%로 크게 떨어지는 반면 RT-1은 67%로 그대로다
- SayCan + RT-1로 최대 50단계의 초장기 과제도 계획하고 실행할 수 있었다
4. 데이터 양과 다양성
데이터셋 크기(% Data)와 다양성(% Tasks)을 따로 줄여가며 성능, 일반화, 강건성이 어떻게 변하는지 봤다.
- Smaller Data: 태스크 수는 그대로 두고, 데이터가 많은 태스크부터 태스크당 예시를 200개(전체의 51%), 100개(37%), 50개(22.5%)로 제한
- Narrower Data: 데이터가 가장 적은 태스크부터 제거해서, 전체 데이터의 97%는 유지하되 태스크는 75%만 남김
| Models | % Tasks | % Data | Seen Tasks | Generalization: All | Unseen Tasks | Distractors | Backgrounds |
|---|---|---|---|---|---|---|---|
| RT-1 | 100 | 100 | 97 | 73 | 76 | 83 | 59 |
| Smaller Data | |||||||
| RT-1 | 100 | 51 | 71 | 50 | 52 | 39 | 59 |
| RT-1 | 100 | 37 | 55 | 46 | 57 | 35 | 47 |
| RT-1 | 100 | 22 | 59 | 29 | 14 | 31 | 41 |
| Narrower Data | |||||||
| RT-1 | 75 | 97 | 86 | 54 | 67 | 42 | 53 |
Table 7
- 데이터셋 크기를 줄이면 성능이 전반적으로 감소하고, 일반화는 더 가파르게 감소한다
- 데이터셋의 범위(다양성)를 좁히면 일반화 측면에서 훨씬 더 급격하게 떨어진다
- 데이터의 97%를 유지하면서 태스크의 25%를 제거했을 때의 일반화 성능(54)은, 데이터셋 크기를 49%까지 줄였을 때(51% 데이터, 50)와 비슷하다
- 결론: 데이터의 다양성이 데이터의 양보다 더 중요하다
5. 모델 설계 Ablation
부록 D.4에서는 RT-1의 각 설계 결정을 하나씩 바꿔가며 영향을 확인했다.
| Model | Seen | Unseen | Distractors | Backgrounds | Inference (ms) |
|---|---|---|---|---|---|
| Gato | 65 (-32) | 52 (-24) | 43 (-40) | 35 (-24) | 129 |
| BC-Z | 72 (-25) | 19 (-57) | 47 (-36) | 41 (-18) | 5.3 |
| BC-Z XL | 56 (-41) | 43 (-33) | 23 (-60) | 35 (-24) | 5.9 |
| RT-1 | 97 | 76 | 83 | 59 | 15 |
| RT-1 w/o big model | 89 (-8) | 62 (-14) | 77 (-6) | 53 (-6) | 13.5 |
| RT-1 w/o pre-training | 84 (-13) | 43 (-33) | 60 (-23) | 41 (-18) | 15 |
| RT-1 w/ continuous actions | 68 (-29) | 43 (-33) | 37 (-46) | 35 (-24) | 16 |
| RT-1 w/ auto-regressive actions | 85 (-12) | 71 (-5) | 67 (-16) | 65 (+6) | 36 |
| RT-1 w/o history | 82 (-15) | 62 (-14) | 50 (-33) | 59 (+0) | 15 |
| RT-1 w/o Transformer | 86 (-13) | 62 (-14) | 67 (-16) | 59 (+0) | 26 |
Table 13. 괄호는 RT-1 대비 차이, Distractors/Backgrounds는 각 범주의 전체(All) 성공률
- 연속 행동(가우시안 출력 + MSE)으로 바꾸면 모든 지표가 크게 떨어진다. 차원별 이산화는 여러 봉우리를 가진(multi-modal) 행동 분포를 표현할 수 있지만, 가우시안은 봉우리 하나만 표현할 수 있기 때문
- ImageNet 사전학습을 빼면 unseen 성공률이 33%p 떨어진다. USE 언어 임베딩과 함께, 사전학습 데이터의 다양성이 일반화에 크게 기여한다
- History(이전 이미지)를 빼면 주로 방해 요소에 대한 강건성이 떨어진다
- Transformer를 빼면 전반적으로 조금씩 떨어진다
- 자기회귀 행동은 성능 이득 없이 추론이 2배 넘게 느려져서 최종 모델에서는 쓰지 않는다
- RT-1은 비슷한 크기의 Gato보다 추론이 약 10배 빠르지만, ResNet 기반 BC-Z보다는 느리다
Conclusions, Limitations and Future Work
결론
- RT-1은 대량의 데이터를 효과적으로 흡수하고, 데이터의 양과 다양성에 따라 성능이 확장되는 로봇 학습 방법이다
- 13대의 로봇으로 17개월간 수집한 13만 개 이상의 시연으로 학습했고, 700개 이상의 지시문을 97% 성공률로 수행하며, 기존 baseline보다 새로운 작업·물체·환경에 더 잘 일반화한다
- 시뮬레이션과 다른 로봇의 데이터도 기존 성능을 해치지 않고 흡수했고, 새로운 상황에 대한 일반화는 오히려 향상됐다. SayCan과 결합해 최대 50단계의 초장기 작업도 실행할 수 있다
한계
- 모방학습 방식이므로 시연자의 성능을 넘어서기 어렵다
- 새로운 지시문에 대한 일반화는 이미 본 개념들의 조합에 한정되며, 한 번도 본 적 없는 완전히 새로운 동작은 아직 수행하지 못한다
- 작업 종류는 많지만 아주 정교한(dexterous) 조작 작업은 아니다
향후 과제
- 방해 요소에는 꽤 강건하지만 배경과 환경에는 상대적으로 약하므로, 환경 다양성을 크게 늘려 강건성을 높이는 것
- 확장 가능한 어텐션과 메모리로 반응 속도와 맥락 유지 능력을 개선하는 것
- 비전문가도 방향성 있는 데이터 수집과 모델 프롬프팅으로 로봇을 학습시킬 수 있게 해서 스킬 수를 더 빠르게 늘리는 것
댓글남기기