GLM-5: from Vibe Coding to Agentic Engineering 논문정리
논문: GLM-5: from Vibe Coding to Agentic Engineering
세미나 발표 자료를 정리한 글입니다. 이전 버전인 GLM-4.5와 달라진 점을 중심으로 정리했고, 발표 자료에 없던 중국 칩 적응(Section 5)과 실험 결과(Section 6)를 추가했습니다.
관련 글: MLA, DSA, DeepSeek MTP, ZeRO, Muon
Abstract
- GLM-4.5의 355B(활성 32B) 파라미터에서 744B(활성 40B) 파라미터로 확장
- 학습 데이터도 GLM-4.5의 23T에서 28.5T 토큰으로 확장
- DSA(DeepSeek Sparse Attention)를 사용해서 long-context 성능을 유지하면서 학습 및 추론 비용을 절감
- 생성(rollout)과 학습을 분리한 새로운 비동기 강화학습 인프라와 비동기 Agent RL 알고리즘 제안
핵심은 “Vibe Coding(사람이 프롬프트로 코드를 시킴) → Agentic Engineering(에이전트가 스스로 계획, 구현, 반복)”으로의 전환
Introduction
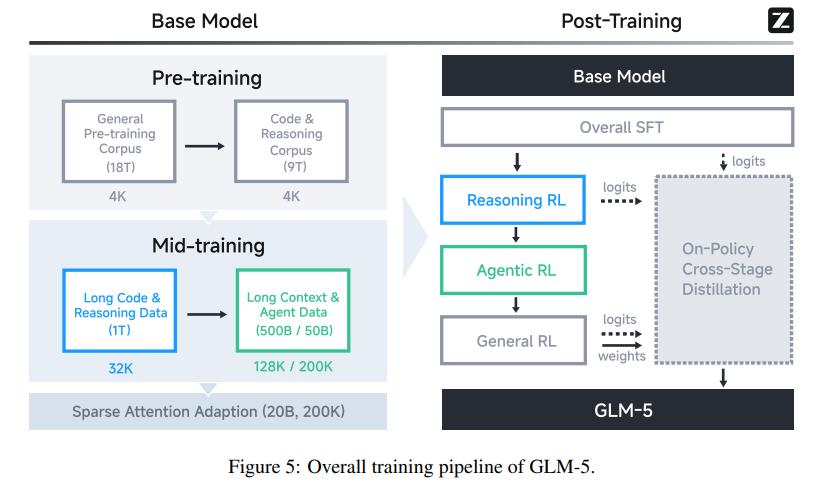
- Pre-training: 일반 코퍼스(18T) → 코드 & 추론 코퍼스(9T), 시퀀스 길이 4K
- Mid-training: 32K(1T) → 128K(500B) → 200K(50B)로 컨텍스트를 점진적으로 확장
- Sparse Attention Adaption: mid-training이 끝난 모델에 DSA를 적용(20B 토큰, 200K)
- Post-training: SFT → Reasoning RL → Agentic RL → General RL을 순차적으로 진행하고, 마지막에 On-Policy Cross-Stage Distillation으로 앞 단계 능력을 복구
추가로 GLM-5는 처음부터 중국 GPU 생태계에 풀스택으로 적응시켰다. Huawei Ascend, Moore Threads, Hygon, Cambricon, Kunlunxin, MetaX, Enflame 7개 칩 플랫폼에서 커널부터 추론 프레임워크까지 최적화를 진행함.
Pre-training
Architecture
- GLM-4.5와 마찬가지로 pre-training(일반 언어, 코딩 능력)과 mid-training(에이전트, long-context 능력) 두 단계를 거침
- 전문가(expert) 수를 256개로 늘리고, expert parallelism 통신 오버헤드를 최소화하기 위해 레이어 수를 80개로 줄임
- 긴 컨텍스트 처리와 GPU 메모리 효율 때문에 GQA 대신 MLA(Multi-head Latent Attention) 를 채택
- 문제는 Muon 옵티마이저 환경에서 실험해보니 576차원 latent KV-cache를 쓰는 MLA가 GQA-8(2048차원 KV-cache)의 성능을 따라가지 못함
- 그래서 Muon Split이라는 방식을 제안
Muon Split
문제점
- 기존 GLM-4.5의 Muon 레시피는 Q, K, V의 up-projection 행렬 $W^{UQ}, W^{UK}, W^{UV}$ 각각을 모든 head를 합친 하나의 큰 행렬로 보고 직교화(orthogonalization)를 적용함
- 직교화가 행렬 전체에 한 번에 적용되기 때문에, 모든 head의 출력 차원을 합친 공간(
num_head * head_dim)이 함께 정규화됨 - 결과적으로 head별로 따로 업데이트되지 못하고, 하나의 공통 스케일로 묶여버림
해결법
- up-projection 가중치를 head 개수만큼 독립적인 작은 행렬로 쪼개고, head별로 따로 직교화를 적용
- 각 head가 자기 스케일에 맞게 독립적으로 업데이트될 수 있음
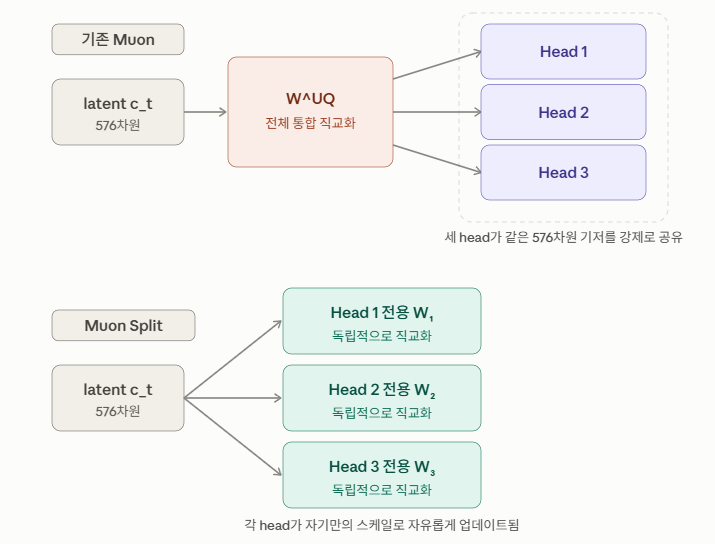
그림은 개념도. 논문에서 576차원은 MLA의 KV-cache(latent) 차원이고, $W^{UQ}$의 입력은 별도의 Q latent(GLM-5 기준 2048차원)이다.
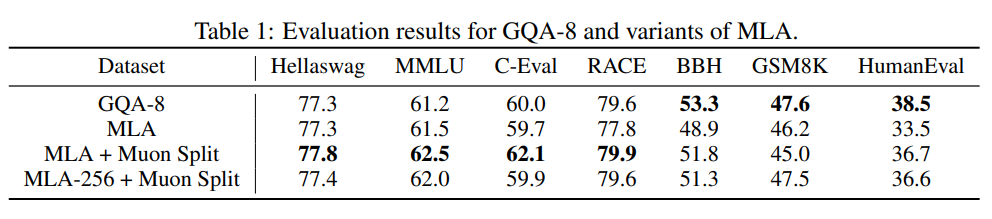
- Muon Split을 적용하면 MLA 성능이 GQA-8 수준까지 올라감
- 추가로 Muon Split을 쓰면 pre-training 동안 별도의 clipping 없이도 attention logit 스케일이 안정적으로 유지됨
MLA-256: MLA는 디코딩 시 576차원 내적을 하므로 GQA(128차원)보다 연산량이 많다. 그래서 head 차원을 192 → 256으로 늘리고 head 수를 1/3 줄여서, 학습 연산량과 파라미터 수는 유지하면서 디코딩 연산량을 줄임. Table 1에서 보듯 MLA + Muon Split과 비슷한 성능을 보임.
MTP with Parameter Sharing
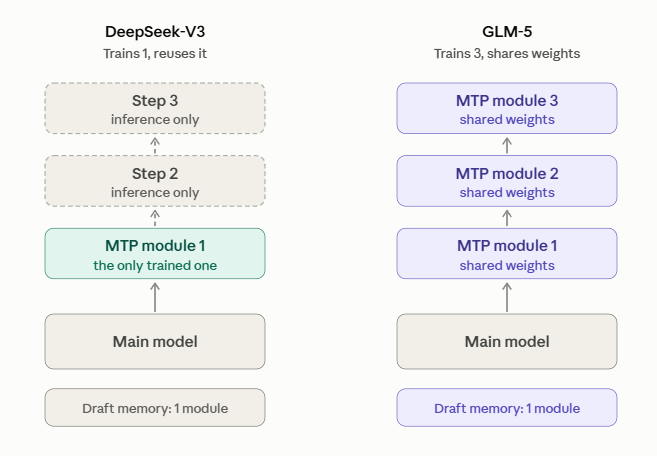
- MTP는 다음 n개 토큰을 예측하려면 n개의 MTP 레이어가 필요해서, 메모리 사용량이 speculative step 수에 비례해 늘어남
- DeepSeek-V3는 MTP 레이어 1개만 학습하고 추론 시 이를 재사용해 2개 토큰을 예측하는데, 학습-추론 불일치 때문에 두 번째 토큰의 수용률(acceptance rate)이 떨어짐
- GLM-5는 학습 과정에서 3개의 MTP 레이어가 파라미터를 공유하도록 함. draft 모델의 메모리 비용은 DeepSeek-V3와 동일하게 유지하면서 수용률은 높일 수 있음
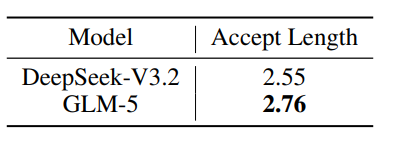
같은 speculative step(4) 조건에서 accept length가 DeepSeek-V3.2(2.55)보다 긴 2.76
Continued Pre-Training with DSA
- DSA의 핵심은 기존의 dense attention 연산($O(L^2)$)을 동적이고 세밀한 토큰 선택 메커니즘으로 대체하는 것. sliding window 같은 고정 패턴이 아니라 내용을 보고 중요한 토큰을 고름
- 처음부터 학습하지 않고 dense 모델에서 continued pre-training으로 도입해서 비용을 크게 줄임. 긴 시퀀스에서 attention 연산을 약 1.5~2배 줄여줌
- DSA 학습은 mid-training이 끝난 base 모델에서 시작하며 두 단계로 진행
- Warm-up 단계: 1000 스텝, 각 스텝은 202,752 토큰짜리 시퀀스 14개, 최대 학습률 5e-3
- Sparse adaptation 단계: mid-training의 데이터와 하이퍼파라미터를 그대로 따르며 20B 토큰 학습
- 학습 예산이 DeepSeek-V3.2(943.7B 토큰)보다 훨씬 적지만, DSA 모델이 원래 MLA 모델의 성능을 따라잡기에 충분함
| MQ-NIAH-128k | MV-NIAH-128k | SQuAD-128k | HotpotQA-128k | |
|---|---|---|---|---|
| MLA | 100.0 | 95.5 | 79.7 | 66.3 |
| DSA | 100.0 | 97.0 | 86.0 | 63.0 |
Table 3. MLA와 DSA base 모델의 long-context 성능 비교. 같은 SFT 데이터로 각각 학습시켜도 training loss와 벤치마크 성능이 거의 동일함
전체 파이프라인: pre-training → mid-training → [DSA continued pre-training] → post-training(SFT/RL)
Efficient Attention Ablation
DSA 외에 다른 효율적인 attention 방식도 GLM-9B(40 레이어, 128K로 학습된 GQA 모델)에서 비교했다. 모두 64K 컨텍스트로 190B 토큰 continual training, efficient attention 레이어와 full attention 레이어를 1:1로 섞음.
- SWA Interleave: full attention과 sliding window attention 레이어를 고정적으로 번갈아 배치
- SWA Pattern: beam search로 어떤 레이어를 SWA로 바꿀지 탐색(16K에서만 탐색하고 다른 길이에도 그대로 적용)
- GDN: Gated DeltaNet, softmax attention을 gated linear recurrence로 대체해 연산을 선형으로 줄임
- SimpleGDN: GDN에서 Conv1d와 gating 모듈을 제거하고 사전학습된 Q, K, V 가중치를 그대로 재사용
| GLM-9B | RULER (64K / 128K) | MRCR (64K / 128K) | HELMET-ICL (64K / 128K) | RepoQA (64K / 128K) |
|---|---|---|---|---|
| Full Attention | 85.35 / 75.28 | 36.53 / 35.39 | 77.68 / 77.36 | 69.00 / 65.83 |
| SWA Interleave | 65.94 / 44.93 | 30.03 / 28.83 | 75.96 / 63.52 | 50.33 / 39.33 |
| SWA Pattern | 83.72 / 69.59 | 35.02 / 33.58 | 76.48 / 74.60 | 62.33 / 51.17 |
| GDN | 76.76 / 64.00 | 31.72 / 30.22 | 76.88 / 74.84 | 65.50 / 56.17 |
| SimpleGDN | 81.76 / 67.03 | 33.03 / 31.27 | 79.80 / 81.84 | 65.50 / 58.50 |
Table 5 요약. 단순 SWA interleave는 RULER@128K에서 30점 넘게 떨어지고, 나머지 방식도 세밀한 검색 과제에서는 성능 손실이 남는다. 반면 DSA는 토큰 단위로 고르기 때문에 모든 레이어에 적용해도 손실이 거의 없음
GLM-4.7-Flash에 DSA를 적용한 소규모 실험에서도 indexer warm-up(1000 스텝) + joint training(150B 토큰) 후 RULER 128K에서 79.21 → 78.86으로 0.35점 차이밖에 나지 않았고, 16K/32K/64K에서는 오히려 원래 모델보다 높았다.
Pre-training Data
Web
- 문장 임베딩 기반 DCLM 분류기를 하나 더 붙여, 기존 분류기가 놓치던 고품질 데이터를 추가로 건짐
- 롱테일 지식 문제를 위해 위키피디아 항목과 LLM 라벨링으로 최적화한 World Knowledge 분류기를 별도로 사용해서, 중저품질로 분류된 문서에서도 가치 있는 정보를 뽑아냄
Code
- 주요 코드 호스팅 플랫폼의 스냅샷을 갱신하고 코드가 포함된 웹페이지를 더 모아서, 중복 제거 후 고유 토큰이 28% 증가
- 언어 분류 파이프라인을 개선하고, 저자원 프로그래밍 언어(Scala, Swift, Lua 등)에 대해 전용 분류기를 따로 학습시켜 샘플링 품질 향상
Math & Science
- 웹페이지 추출과 PDF 파싱을 개선해 원본 품질을 높이고, LLM으로 문서를 채점해 교육적 가치가 높은 것만 남김
- 긴 문서는 chunk 단위로 채점 후 집계하는 알고리즘을 사용하고, 합성/AI 생성/템플릿 기반 데이터는 엄격히 배제
Mid-training
컨텍스트 및 학습 규모 확장
- 32K(1T 토큰) → 128K(500B 토큰) → 200K(50B 토큰)로 점진적 확장
- GLM-4.5의 최대 128K와 비교했을 때, 추가된 200K 단계는 초장문 문서와 복잡한 멀티 파일 코드베이스를 처리하는 능력을 상당히 개선함
- 긴 문서와 합성 에이전트 궤적 데이터는 뒤쪽 단계에서 업샘플링됨
소프트웨어 엔지니어링 데이터
- 레포지토리 수준의 필터링 기준을 완화해 대상 레포 풀을 넓혔고, 약 1000만 개의 issue-PR 쌍을 확보. 대신 개별 issue 단위의 품질 필터링은 강화
- 각 issue-PR 쌍에 대해 관련 파일을 더 많이 검색해서 더 풍부한 개발 맥락을 확보함. issue-PR 부분은 약 160B 고유 토큰
롱컨텍스트 데이터
- 자연 데이터(책, 논문 등)와 합성 데이터로 구성
- 합성 데이터는 NextLong과 EntropyLong에서 영감을 받아, 유사한 텍스트를 interleaved packing으로 묶어 장거리 의존성을 만들어냄(lost-in-the-middle 완화)
- 200K 단계에서는 MRCR 유형의 데이터를 소량 추가하고 다양한 변형을 설계해서 멀티턴 대화 회상 능력을 강화함
- 200K 단계를 추가하니 128K 이내의 성능까지 같이 좋아짐
Training Infrastructure
Memory Efficiency
1. Flexible MTP placement
- MTP 모듈은 임베딩, 트랜스포머, 출력층을 모두 가지고 있어서 메모리를 많이 차지하고, 파이프라인 스테이지 간 불균형을 만듦
- MTP의 출력층은 메인 모델의 출력층과 같은 마지막 스테이지에 두고(파라미터 공유), 임베딩과 트랜스포머는 그 직전 스테이지에 배치
- 예시
- 스테이지 1: 메인 임베딩 + 메인 1~10번 레이어 → GPU 0
- 스테이지 2: 메인 11~20번 레이어 + MTP 임베딩/트랜스포머 → GPU 1
- 스테이지 3: 메인 출력헤드 + MTP 출력헤드 → GPU 2
2. Pipeline ZeRO2 gradient sharding
- ZeRO의 gradient 샤딩처럼 각 스테이지가 전체 gradient의 1/dp만 저장
- 전체 크기 누적 버퍼는 2개만 두고 번갈아 사용(double buffering). 버퍼 A가 gradient를 누적하는 동안 버퍼 B는 이전 스테이지의 gradient 동기화(reduce-scatter)를 진행해서 추가 동기화 오버헤드가 없음
3. Zero-redundant communication for the Muon distributed optimizer
- Adam은 원소별 연산이라 파라미터를 아무렇게나 쪼개도 되지만, Muon은 직교화를 위해 행렬 전체가 필요함
- 단순한 Muon 구현은 각 DP rank가 전체 파라미터를 all-gather해서 메모리가 순간적으로 튀고 중복 통신이 발생함
- 각 rank가 자기가 담당하는 파라미터 샤드에 대해서만 all-gather 하도록 제한하고, 로컬 연산과 통신을 겹쳐서 중복 통신과 옵티마이저 peak 메모리를 줄임
4. Pipeline activation offloading
- 파이프라인 병렬에서는 warm-up 구간에 forward가 먼저 여러 개 진행되고 backward는 한참 뒤에 시작함. 그동안 activation이 GPU 메모리에 계속 잡혀있어야 함
- forward 후 activation을 CPU(host) 메모리로 레이어 단위로 내려두고, backward 직전에 다시 불러옴. 연산과 겹쳐서 진행하므로 오버헤드가 거의 없음
5. Sequence-chunked output projection
- 출력층(vocab) projection과 cross-entropy loss는 vocab이 커서 텐서 자체가 크고, loss 계산 시 BF16 → FP32로 정밀도를 올리면서 메모리가 한 번 더 튐
- 시퀀스를 청크로 쪼개서 청크마다 forward, backward를 끝내고 activation을 해제한 뒤 다음 청크를 처리함
Parallelism Efficiency
6. Efficient deferred weight gradient computation
- backward에서는 이전 레이어로 넘길 activation gradient와 현재 레이어의 weight gradient를 계산해야 함
- 파이프라인 bubble을 줄이기 위해 critical path에 있는 weight gradient 계산 일부를 뒤로 미룸. 처리량은 오르고 메모리 오버헤드는 일정 수준으로 유지됨
7. Efficient long-sequence training
- 시퀀스가 길어지면 DP와 PP 그룹 사이의 작업량 불균형이 심해짐
- 시퀀스를 작업량 기준으로 재배열하고, attention 연산을 동적으로 재분배하고, context-parallel 그룹 크기를 상황에 맞게 조절함
- QKV 텐서를 주고받는 all-to-all 통신은 노드 내/노드 간 통신을 계층적으로 겹쳐서 지연을 줄임
INT4 Quantization-aware Training
- 저정밀도에서도 정확도를 유지하기 위해 SFT 단계에서 INT4 QAT 적용
- 학습과 오프라인 가중치 양자화 모두에 쓸 수 있는 양자화 커널을 개발해서 학습과 추론 사이에 비트 단위로 동일한 동작을 보장
Post-Training
- 멀티태스크 SFT로 시작해서, 추론 및 에이전트 과제를 위한 RL 단계를 거치고, 사람 스타일 정렬을 위한 General RL 단계로 마무리
- 최종 단계로 On-Policy Cross-Stage Distillation을 사용해서, 각 학습 단계의 성능 향상은 가져가면서 앞 단계 능력이 떨어지는 문제는 완화함
Supervised Fine-Tuning
- GLM-4.5 대비 SFT 단계에서 Agent 및 Coding 데이터의 규모를 대폭 확대. 최대 컨텍스트 길이를 202,752 토큰까지 확장
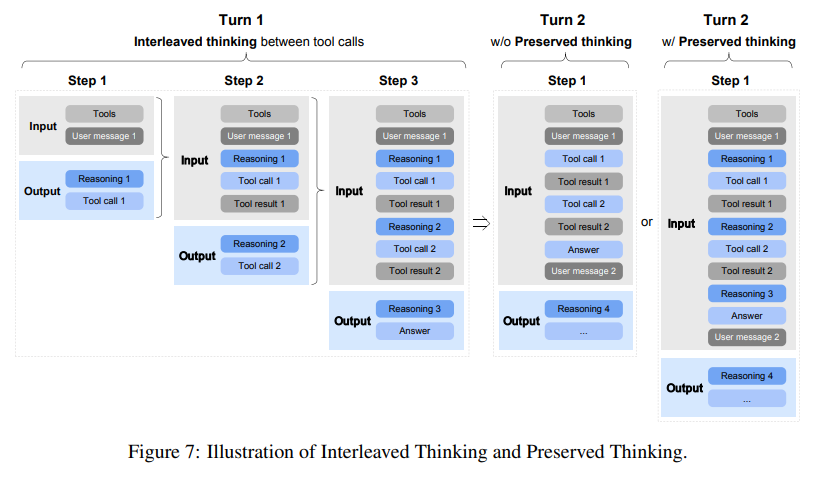
- 새로 작성된 채팅 템플릿과 함께 세 가지 사고(thinking) 특성을 지원
- Interleaved Thinking: 모든 응답과 툴 호출 전에 사고하여 지시 따르기와 생성 품질을 개선
- Preserved Thinking: 코딩 에이전트 시나리오에서 멀티턴 대화 전반의 사고 블록을 자동으로 유지해서, 처음부터 다시 추론하지 않고 기존 추론을 재사용. 정보 손실과 불일치를 줄여 long-horizon 과제에 적합
- Turn-level Thinking: 세션 내에서 턴마다 추론 여부를 제어. 가벼운 요청에는 사고를 꺼서 지연시간과 비용을 줄이고, 복잡한 과제에는 켜서 정확도와 안정성을 높임
도메인별 데이터 구성
- 일반 대화: GLM-4.5보다 더 논리적이고 간결한 응답 스타일로 최적화. 롤플레이는 더 넓고 다양한 데이터셋을 구축하고, 자동 필터링과 사람 필터링을 함께 적용해 선별
- 추론: 논리 추론은 검증 가능한 문제를 구성하고 rejection sampling으로 맞은 것만 데이터로 사용. 수학 및 과학 문제는 GLM-4.7에게 어려운 문제만 남기는 난이도 기반 필터링 적용
- 코딩 및 에이전트: 대량의 실행 환경을 구축해 고품질 궤적을 확보하고 실제 시나리오와 long-horizon 과제에 중점. 전문가 RL과 rejection sampling으로 데이터를 추가 개선함
- 궤적 내의 오류 구간은 삭제하지 않고 loss에서 마스킹 처리해서, 잘못된 행동은 강화하지 않으면서 모델이 오류 수정 행동을 학습할 수 있도록 함
Reasoning RL
GLM-4.5와 동일하게 GRPO 기반으로 학습하되, IcePop 기법을 추가해서 training-inference mismatch를 완화함. 원래 IcePop과 달리 KL 정규화 항은 제거함.
- 학습에 쓰는 정책 $\pi^{train}$과 rollout(생성)에 쓰는 정책 $\pi^{infer}$를 명시적으로 구분
- 이론적으로는 같은 모델이어야 하지만, rollout은 vLLM/SGLang 같은 추론 엔진, 학습은 학습 프레임워크로 돌리기 때문에 커널, 정밀도, 배치 방식에 따라 같은 입력에 대한 확률값이 미묘하게 어긋남
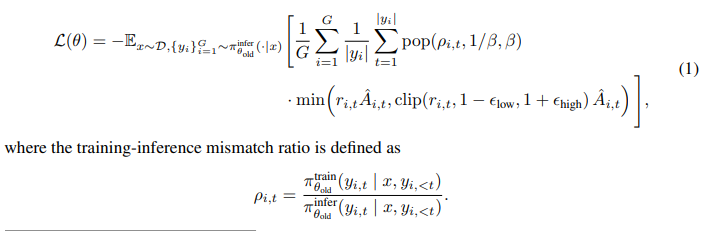
- $\beta = 2$이므로 $\rho_{i,t}$가 [0.5, 2] 범위를 벗어나면 해당 토큰의 기여를 0으로 만들어 학습에서 빼버림
- 하이퍼파라미터: $\epsilon_{low}=0.2$, $\epsilon_{high}=0.28$, group size 32, batch size 32, 완전 on-policy로 학습
DSA RL insights
- DSA는 indexer가 top-k(k=2048)개의 key-value를 골라서 attention을 계산함. rollout은 추론 엔진, 학습은 학습 엔진에서 돌리는데, 같은 입력이어도 두 엔진이 고른 top-k 인덱스가 다를 수 있음. top-k가 달라지면 attention이 다른 곳을 보게 되니 RL 학습이 불안정해짐
- MoE의 routing replay처럼 indexer의 top-k를 저장해서 재사용하는 방법은 k=2048로 너무 커서 저장/통신 비용이 감당이 안 됨
- 그래서 결정론적(deterministic) top-k 연산자로 해결. SGLang의 비결정론적 CUDA top-k 대신
torch.topk를 학습 엔진의 기본값으로 사용. 속도는 조금 손해보지만 같은 입력에는 항상 같은 top-k가 나옴 - 다른 비결정론적 top-k(CUDA, TileLang 구현)를 쓰면 RL 몇 스텝 만에 성능이 급격히 떨어지고 entropy가 급락함
- RL 동안은 indexer의 파라미터를 고정. indexer가 계속 바뀌면 top-k 선택 자체가 흔들리기 때문
추론 엔진의 최적화된 top-k는 수천 개의 GPU 스레드에 비교 작업을 나눠서 병렬로 처리하기 때문에, 부동소수점 연산 순서 등에 따라 결과가 미묘하게 다를 수 있다.
Mixed domain reasoning RL
수학, 과학, 코드, 도구 활용 추론(TIR) 4개 영역을 균형 있게 섞어서 학습했고, 모든 영역에서 안정적이고 뚜렷한 성능 향상을 보임.
- 수학/과학: 오픈소스 데이터셋 + 외부 어노테이션 업체와 공동 제작한 데이터. GLM-4.7이 거의 못 풀거나 아예 못 푸는 문제 중에서, 더 강한 teacher 모델(GPT-5.2 xhigh, Gemini 3 Pro Preview)은 풀 수 있는 문제만 골라 사용
- 코드: 경쟁 프로그래밍(Codeforces, TACO, SYNTHETIC-2-RL 등)과 과학 코딩 과제
- TIR: 수학/과학 RL 데이터 중 더 어려운 부분 집합을 재사용하고, 외부 도구를 써야 풀리도록 설계된 STEM 문제를 어노테이션 업체와 별도로 제작
- 영역/출처별 judge 모델이나 평가 시스템으로 binary outcome reward를 줌
Agentic RL
- 기존 동기식 RL은 rollout이 길게 걸리는 동안 GPU 유휴 시간이 심각함. 코딩, 검색 같은 에이전트 과제는 여러 단계를 거쳐 오래 걸리기 때문에 rollout이 다 끝날 때까지 기다리면 낭비가 큼
- 그래서 추론(rollout) 엔진과 학습 엔진을 분리하고, 중앙의 Multi-Task Rollout Orchestrator를 통해 여러 종류의 에이전트 작업을 섞어서 동시에 학습함
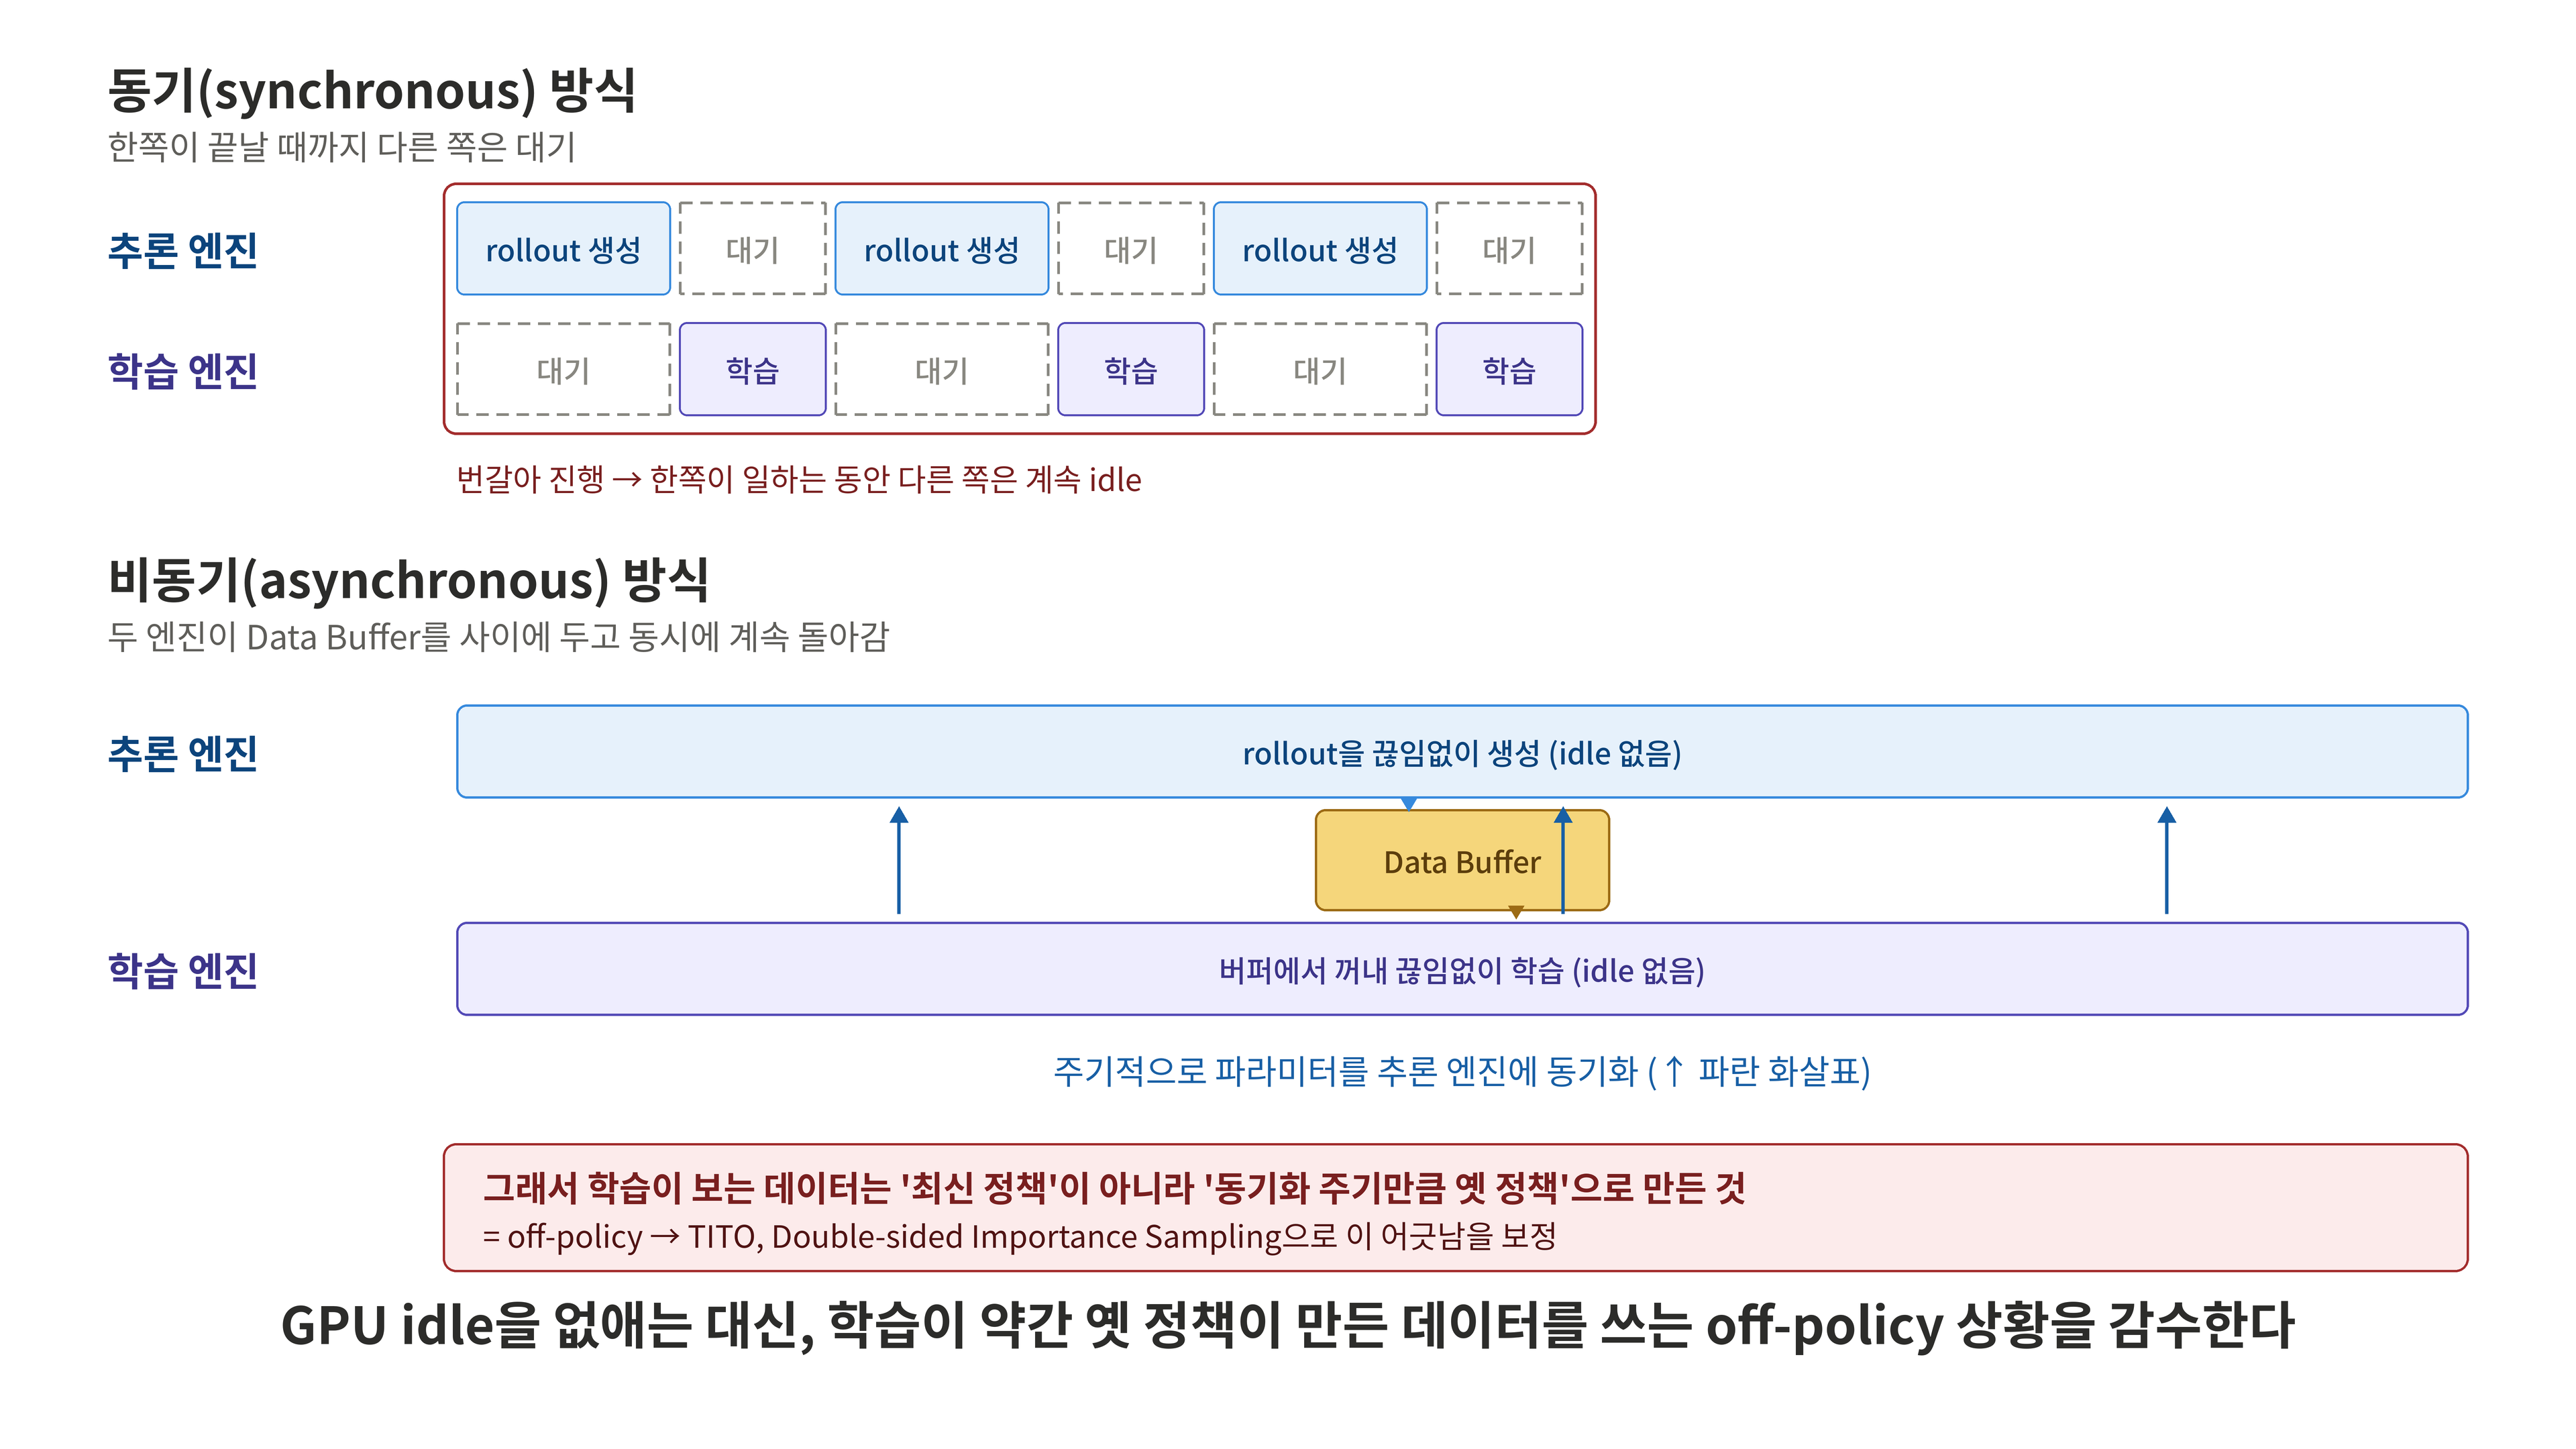
추론 엔진이 rollout을 만드는 동안 학습 엔진은 버퍼에 쌓인 데이터로 계속 학습을 진행한다. 따라서 학습 데이터는 파라미터 동기화 주기만큼 이전 정책으로 만들어진 것일 수 있다(off-policy). 이를 보정하기 위해 두 가지 장치를 추가함.
TITO(Token-in-Token-out) Gateway
- 텍스트를 토큰화 → 디코딩 → 다시 토큰화하는 과정(Text-in-Text-out)에서 생기는 토큰 경계, 공백 처리, special token 위치 등의 미세한 불일치를 없앰
- 모델이 생성한 토큰(행동)은 재토큰화하지 않고 생성 당시의 토큰 ID를 그대로 저장해두었다가 학습에 쓰고, 환경에서 새로 들어온 텍스트(관찰)만 토큰화해서 이어붙임. 그래서 행동 부분의 토큰 경계가 rollout 때와 학습 때 어긋나지 않음
Direct Double-sided Importance Sampling
- 비동기에서는 한 궤적을 생성하는 동안에도 정책이 여러 번 업데이트될 수 있어서, 정확한 옛 정책 확률($\pi_{old}$)을 구하려면 체크포인트 이력을 다 들고 있어야 함
- 그래서 rollout 시점의 log-prob를 저장해서 행동 확률의 대용값으로 재사용함
- 비율이 $[1-\epsilon_l, 1+\epsilon_h]$ 범위를 벗어난 토큰은 gradient 계산에서 완전히 마스킹함. IcePop과 비슷하지만 $\pi_{old}$를 아예 없앤 더 단순한 방식
그 외 안정화 기법
- 오래된 샘플 제거: 각 응답을 생성할 때 사용된 모델 버전을 기록하고, 가장 오래된 버전이 현재보다 임계값 이상 뒤처지면 버림
- 환경 오류 샘플 제거: 샌드박스가 모델과 무관하게 죽은 샘플은 제외. GRPO 그룹이 비면 유효 샘플이 절반 이상일 때는 반복으로 채우고, 아니면 그룹 전체를 버림
- DP-aware routing: 멀티턴 에이전트에서는 같은 rollout의 연속 요청이 같은 prefix를 공유하므로, consistent hashing으로 한 rollout의 모든 요청을 같은 DP rank로 보내 KV cache 재사용을 극대화
General RL
Multi-dimensional optimization objectives
- 기초적 정확성(foundational correctness): 응답 품질의 토대. 지시 미준수, 논리적 모순, 사실 오류, 환각, 어색한 문장 등 사용성을 해치는 오류를 최소화
- 감성 지능(emotional intelligence): 정확성을 넘어 사용자 경험을 최적화. 공감적이고 사람의 소통에 가까운 응답을 만들어 상호작용이 자연스럽게 느껴지게 함
- 과제별 품질(task-specific quality): 글쓰기, 텍스트 처리, 주관식/객관식 QA, 롤플레이, 번역 등 과제마다 “맞는 답”을 넘어 “좋은 답”으로 끌어올림. 과제마다 다른 보상 신호가 필요해서 하이브리드 보상 시스템 도입
Hybrid reward system
- Rule-based reward: 정밀하고 해석 가능한 신호. 결정론적 규칙으로 표현 가능한 곳에만 사용 가능
- ORM(Outcome Reward Model): 분산이 낮은 신호와 높은 학습 효율을 제공하지만, 정책이 실제 능력을 키우는 대신 표면적인 패턴을 악용하는 reward hacking에 취약
- GRM(Generative Reward Model): 언어모델로 스칼라 또는 구조화된 평가를 생성. reward hacking에는 더 강하지만 분산이 큼
- 세 가지를 섞어서 정밀성, 효율성, 강건성의 균형을 맞춤
Human-in-the-loop style alignment
- 모델이 생성한 응답에만 의존하면 장황하고 정형화된 “모델스러운” 패턴으로 수렴하는 경향이 있음
- 전문가가 작성한 고품질 응답을 스타일과 품질의 기준점(anchor)으로 명시적으로 도입해서, 더 자연스럽고 사람에 가까운 응답 패턴을 따르도록 유도
On-Policy Cross-Stage Distillation
GLM-4.5 vs GLM-5 학습 파이프라인
| GLM-4.5 (병렬 → 통합) | GLM-5 (순차 학습) | |
|---|---|---|
| 방식 | Reasoning / Agentic / General 전문가 3개를 독립적으로 RL 학습 | 하나의 모델이 단계를 순서대로 통과 |
| 통합 | 전문가들이 생성한 데이터로 base 모델을 SFT해서 통합 | SFT → Reasoning RL → Agentic RL → General RL → On-Policy Cross-Stage Distillation |
순차 학습을 하면 뒤 단계를 학습하면서 앞 단계에서 얻은 능력이 깎인다. 예를 들어 Reasoning RL 모델에 Agentic RL을 학습하면 Reasoning 능력이 조금 저하된다. 이를 해결하기 위해 마지막 단계에서 on-policy distillation을 수행한다.
- 교사: 앞 단계들(SFT, Reasoning RL, General RL 등)의 최종 체크포인트
- 학생: General RL까지 마친 모델
- 프롬프트: 각 교사가 학습했던 RL 데이터셋에서 샘플링해 적절한 비율로 혼합
학습 과정
- 학생 모델이 프롬프트에 대한 응답을 직접 생성(on-policy)
- 응답의 각 토큰에 대해 교사 모델이 자신의 확률을 계산해서 평가
- 학생 모델이 자기 응답에서 교사와 다르게 본 토큰을 수정
Eq. 1의 advantage 항을 아래 식으로 바꾸기만 하면 된다(sg는 stop gradient).
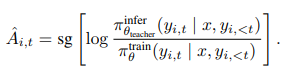
- log 안의 값이 1보다 큼($\hat{A} > 0$): 교사가 이 토큰을 더 높게 봄 → 확률을 올림
- log 안의 값이 1보다 작음($\hat{A} < 0$): 교사가 이 토큰을 더 낮게 봄 → 확률을 내림
- advantage를 교사와의 차이로 바로 계산하므로 group을 크게 유지할 필요가 없음. group size 1, batch size 1024로 학습
증류할 때는 각 단계의 질문(프롬프트) 데이터만 가져오고, 응답은 학생 모델이 생성한 것을 사용한다.
Agentic Engineering
장기(long-horizon) 에이전트 rollout을 효율적으로 처리하는 완전 비동기·분리형 RL 인프라를 설계했다.
- 서로 다른 에이전트 프레임워크를 섞어서 멀티태스크로 학습할 수 있도록 유연하게 설계. 각 과제는 독립적인 마이크로서비스로 rollout/reward 로직을 구현하고 중앙 오케스트레이터에 등록
- 학습/추론 엔진을 서로 다른 GPU에 분리해서, 생성된 궤적이 임계값만큼 모이면 학습하고 K번 업데이트마다 가중치를 동기화. off-policy 문제를 줄이기 위해 가중치 동기화 후 옵티마이저를 리셋하고, 오케스트레이터가 1000개 이상의 rollout을 동시에 관리
- 모든 에이전트 과제의 궤적을 통일된 message-list 형태로 표준화
- TITO, Direct Double-sided Importance Sampling, off-policy/노이즈 샘플 제거, DP-aware routing 적용(Agentic RL 참고)
Environment Scaling for Agents
1. SWE 환경
- 실제 Issue-PR 쌍을 대량 수집하고 규칙 기반 + LLM 필터링으로 품질 확보. 버그 수정, 기능 구현, 리팩토링 등으로 분류
- RepoLaunch 기반 파이프라인이 저장소의 설치/의존성을 자동 분석해서 실행 환경과 테스트 명령을 만들고, LLM이 테스트 로그 파싱 함수를 생성해서 Fail-to-Pass / Pass-to-Pass 테스트 케이스를 추출
- 9개 언어(Python, Java, Go, C, C++, JS, TS, PHP, Ruby), 수천 개 저장소에 걸친 1만 개 이상의 검증 가능한 환경 구축
2. 터미널 환경
- 시드 데이터 기반: 실제 터미널 사용 시나리오에서 시드 과제를 모으고 LLM이 초안을 대량 생성 → 구성 에이전트가 Harbor 형식의 구체적인 과제로 완성(Docker 실행 환경 + 테스트 스크립트) → 정제 에이전트가 rubric에 따라 반복 수정. Docker 빌드 정확도 90% 이상, 수천 개의 터미널 환경 확보
- 웹 코퍼스 기반: 코드 관련 웹페이지를 품질 분류기로 거르고, 터미널 과제로 만들기 적합한 페이지를 선별. 코딩 에이전트가 과제를 만들고 Harbor 검증 스크립트를 스스로 실행해서 통과할 때까지 수정하는 폐루프 방식이며, 자체 검증을 통과한 과제만 최종 데이터셋에 포함
3. 검색 과제
- 여러 웹 소스를 종합해야 풀리는 고난도 multi-hop QA를 합성
- 초기 검색 에이전트의 궤적에서 200만 개 이상의 웹페이지를 모아 Web Knowledge Graph를 만들고, 저/중빈도 엔티티 주변의 multi-hop 서브그래프를 질문으로 변환
- 3단계 필터링
- 도구 없는 추론 모델이 8번 중 한 번이라도 맞히면 제거(쉬운 문제)
- 초기 에이전트가 몇 단계 안에 푸는 문제 제거
- 검증 에이전트가 질문-정답 일관성을 확인해서, 정답이 유일하지 않거나 근거가 모순되는 샘플 제거
4. 검색 에이전트의 컨텍스트 관리
- 컨텍스트가 매우 길어지면(예: 100K 이상) 정확도가 크게 떨어짐
- Keep-recent-k: 최근 k 라운드보다 오래된 도구 결과(observation)는 “Tool result is omitted to save tokens.”로 접어서 컨텍스트 길이를 통제. k=5로 BrowseComp 55.3% → 62.0%
- Hierarchical Context Management: keep-recent를 쓰다가 전체 컨텍스트가 임계값 T(=32K)를 넘으면 도구 호출 기록 전체를 버리고(Discard-all) 새 컨텍스트로 다시 시작하고, 이후에도 keep-recent를 계속 적용. BrowseComp 75.9로 컨텍스트 관리를 쓰는 오픈소스 모델 중 최고
5. Slide Generation
- HTML 코드로 슬라이드를 생성하는 능력. SFT → RL → rejection sampling / masking fine-tuning을 반복하는 self-improving 파이프라인
- Multi-level reward 사용
- 정적 마크업: 생성된 HTML의 선언적 속성(위치, 간격, 색, 타이포 등)을 전문 디자인 원칙에 기반한 규칙으로 검사. 환각 이미지/중복 이미지도 감지
- 런타임 렌더링: 실제로 렌더링한 뒤 DOM 요소의 기하 정보를 재서, 공간 배치가 사람의 미적 선호에 가깝도록 유도. 넘치는 내용을 잘라 숨기거나 여백을 과하게 조작하는 reward hacking이 관찰되어 렌더러의 허점을 수정
- 시각적 판단: 렌더링 결과에서 비정상적인 여백 패턴 등을 감지해 전체 구도의 균형을 보조 신호로 반영
- 결과: 16:9 비율을 엄격히 지키는 페이지 비율 40% → 92%. 사람 평가에서 GLM-4.5 대비 내용 품질 60%, 레이아웃 57.5%, 시각 미관 65%, 전체 67.5% 승률
정확한 점수 산출 방식은 논문에 나와 있지 않다.
Adapting GLM-5 to Chinese Chip Infrastructure
중국 칩은 하드웨어 생태계가 제각각이라 고성능 배포가 어렵다. GLM-5는 7개 중국 칩 플랫폼(Huawei Ascend, Moore Threads, Hygon, Cambricon, Kunlunxin, MetaX, Enflame)과 협업해서 풀스택 적응을 완료했고, 논문에서는 Huawei Ascend Atlas 시리즈를 사례로 설명한다. 핵심은 세 가지다.
1. Mixed-Precision W4A8 양자화
- 약 750B 파라미터의 GLM-5를 Atlas 800T A3 한 대에 올리기 위해 혼합 정밀도 양자화 적용(msModelSlim 툴 사용)
- 일반 Attention과 MLP 블록은 W8A8(INT8), MoE 전문가는 W4A8(INT4) 로 압축해서 정확도 손실 없이 메모리를 크게 줄임
- 이상치 억제를 위해 QuaRot, 스케일 보정을 위해 Flex_AWQ_SSZ 알고리즘 사용
2. 고성능 퓨전 커널
- Lightning Indexer: 점수 계산, ReLU, TopK 연산을 하나의 커널로 합쳐서 NPU가 연산과 메모리 접근을 겹칠 수 있게 함
- Sparse Flash Attention: GLM-5의 sparse 패턴에 맞춰 최적화. KV cache에서 TopK 토큰을 고르는 작업과 sparse attention 연산을 병렬로 처리
- MLAPO(MLA Pre-processing Optimization): 13개의 작은 전처리 연산자를 하나의 “super operator”로 합치고, Vector 유닛과 Cube 유닛을 병렬로 활용
3. 추론 엔진 최적화(vLLM-Ascend, SGLang)
- 비동기 스케줄링: Device-to-Host 샘플링 복사와 다음 디코드 스텝 준비를 겹쳐서 스케줄링 bubble 제거
- 컨텍스트 관리: RadixCache(prefix 공유)와 Prefix Cache(KV 저장소를 시스템 RAM으로 확장)로 KV 재사용
- 병렬화 전략: Attention은 DP, MoE는 EP로 나누는 하이브리드 방식에, AllReduce를 쪼개서 통신 지연을 연산 뒤에 숨기는 FlashComm 적용
- MTP: 추론 스텝당 여러 토큰을 생성해서 NPU 연산 밀도를 높이고 전체 생성 시간 단축
결과적으로 중국 칩 단일 노드에서 해외 GPU 2노드 클러스터와 비슷한 성능을 내고, 긴 시퀀스 시나리오에서 배포 비용을 50% 절감
Evaluation
ARC Benchmarks
GLM-5를 GLM-4.7, DeepSeek-V3.2, Kimi-K2.5, Claude Opus 4.5, Gemini 3 Pro, GPT-5.2(xhigh)와 비교했다.
| Benchmark | GLM-5 | GLM-4.7 | DeepSeek-V3.2 | Kimi K2.5 | Claude Opus 4.5 | Gemini 3 Pro | GPT-5.2 (xhigh) |
|---|---|---|---|---|---|---|---|
| Reasoning & General | |||||||
| HLE | 30.5 | 24.8 | 25.1 | 31.5 | 28.4 | 37.2 | 35.4 |
| HLE (w/ Tools) | 50.4 | 42.8 | 40.8 | 51.8 | 43.4* | 45.8* | 45.5* |
| AIME 2026 I | 92.7 | 92.9 | 92.7 | 92.5 | 93.3 | 90.6 | - |
| HMMT Nov. 2025 | 96.9 | 93.5 | 90.2 | 91.1 | 91.7 | 93.0 | 97.1 |
| GPQA-Diamond | 86.0 | 85.7 | 82.4 | 87.6 | 87.0 | 91.9 | 92.4 |
| LongBench v2 | 64.5 | 59.1 | 59.8 | 61.0 | 64.4 | 68.2 | 59.8 |
| Coding | |||||||
| SWE-bench Verified | 77.8 | 73.8 | 73.1 | 76.8 | 80.9 | 76.2 | 80.0 |
| SWE-bench Multilingual | 73.3 | 66.7 | 70.2 | 73.0 | 77.5 | 65.0 | 72.0 |
| Terminal-Bench 2.0 (Terminus-2) | 56.2 / 60.7† | 41.0 | 39.3 | 50.8 | 59.3 | 54.2 | 54.0 |
| CyberGym | 43.2 | 23.5 | 17.3 | 41.3 | 50.6 | 39.9 | - |
| Agentic | |||||||
| BrowseComp | 62.0 | 52.0 | 51.4 | 60.6 | 37.0 | 37.8 | - |
| BrowseComp (w/ Context Manage) | 75.9 | 67.5 | 67.6 | 74.9 | 57.8 | 59.2 | 65.8 |
| τ²-Bench | 89.7 | 87.4 | 85.3 | 80.2 | 91.6 | 90.7 | 85.5 |
| MCP-Atlas (Public Set) | 67.8 | 52.0 | 62.2 | 63.8 | 65.2 | 66.6 | 68.0 |
| Tool-Decathlon | 39.2 | 23.8 | 35.2 | 27.8 | 43.5 | 36.4 | 46.3 |
| Vending-Bench 2 (USD) | 4,432 | 2,377 | 1,034 | 1,198 | 4,967 | 5,478 | 3,591 |
| GDPval-AA Elo | 1,409 | 1,198 | 1,195 | 1,288 | 1,400 | 1,201 | 1,462 |
Table 7 일부. *는 HLE 전체 세트 결과, †는 모호한 지시를 수정한 verified Terminal-Bench 2.0 결과
- Reasoning: 오픈소스 최강인 Kimi-K2.5와 비슷한 수준. HLE(w/ Tools)에서는 Claude Opus 4.5, Gemini 3 Pro보다 높고, LongBench v2는 Gemini 3 Pro 다음으로 높음
- Coding: 오픈소스 중 SOTA. SWE-bench Verified에서 Gemini 3 Pro보다 높고, Multilingual에서는 Gemini 3 Pro, GPT-5.2보다도 높음. CyberGym은 GLM-4.7 대비 거의 2배(23.5 → 43.2)
- Agentic: BrowseComp는 컨텍스트 관리 유무와 상관없이 전체 모델 중 1위. τ²-Bench, MCP-Atlas, Tool-Decathlon은 Claude Opus 4.5와 비슷한 수준이고, GDPval-AA는 GPT-5.2 다음
- 평균적으로 GLM-4.7 대비 약 20% 향상. Artificial Analysis Intelligence Index v4.0에서 50점으로 오픈 웨이트 모델 최초로 50점을 달성(GLM-4.7은 42점)했고, LMArena의 Text Arena와 Code Arena 모두 오픈 모델 1위
CC-Bench-V2 (Real-world Agentic Engineering)
리더보드보다 실제 사용 경험이 중요하다는 관점에서 만든 내부 벤치마크. 사람 라벨링 없이 Claude Code 등의 에이전트 하네스와 unit test, Agent-as-a-Judge로 완전 자동화했다.
- Frontend: 에이전트가 만든 프로젝트를 빌드하고, GUI 에이전트(Claude Code + Claude Sonnet 4.5 + Playwright MCP)가 실제로 클릭, 입력, 스크린샷을 하면서 체크리스트 항목을 하나씩 검증. 사람 평가와 항목 단위 94% 일치, 모델 순위 Spearman 상관 85.7%
- Backend: 6개 언어의 실제 오픈소스 프로젝트에서 85개 과제. 과제당 5~10개 unit test를 모두 통과해야 성공
- Long-horizon: 대형 저장소에서 목표 파일 찾기(Repo Exploration)와, merge된 PR의 커밋들을 묶어 순차적으로 수행하는 Chained Tasks
| Category | Task | Metric | GLM-5 | GLM-4.7 | Claude Opus 4.5 |
|---|---|---|---|---|---|
| Frontend | HTML | ISR / CSR | 38.9 / 76.3 | 35.4 / 64.9 | 52.2 / 82.2 |
| React | ISR / CSR | 34.6 / 71.0 | 17.2 / 49.4 | 39.7 / 70.7 | |
| Vue | ISR / CSR | 32.7 / 77.1 | 24.5 / 53.8 | 46.9 / 74.3 | |
| Build | React / Vue / Svelte / Next.js | BSR | 100 / 100 / 100 / 95.0 | 65.0 / 70.0 / 60.0 / 70.0 | 95.0 / 100 / 90.0 / 80.0 |
| Backend | Engineering | Pass@1 | 25.8 | 19.6 | 26.9 |
| Long-horizon | Repo Exploration | Pass@1 | 65.6 | 47.8 | 64.5 |
| Chained Tasks | Pass@1 | 52.3 | 43.0 | 61.6 |
Table 8. BSR: 빌드 성공률, ISR: 모든 요구사항을 통과한 프로젝트 비율, CSR: 체크 항목 단위 성공률
- Frontend는 빌드 성공률 98.0%, CSR은 Claude Opus 4.5와 비슷하지만 ISR 격차가 남아있음. 개별 요구사항은 대부분 맞추지만 과제 전체를 끝까지 완성하는 건 아직 부족
- Backend는 Claude Opus 4.5와 비슷한 수준
- Repo Exploration은 Claude Opus 4.5보다 높음. 코드 생성 능력보다 디렉토리 단위 추론과 의미적 연관을 통한 전략적 탐색이 중요하고, 에이전트 도구 사용 궤적 학습이 효과를 봄
- Chained Tasks는 GLM-4.7보다 크게 올랐지만 Claude Opus 4.5와 격차가 큼. 앞 과제의 작은 실수가 뒤 과제의 테스트를 깨뜨리는 식으로 오류가 누적되기 때문
SWE-rebench
SWE-bench Verified는 공개된 지 2년이 넘은 정적 테스트셋이라 오염 가능성이 있다. SWE-rebench는 새로운 GitHub issue를 계속 수집하는 파이프라인이라 새로운 문제에 대한 일반화를 더 잘 측정한다.
| Model | Resolved Rate (%) | SEM (±, %) | Pass@5 (%) |
|---|---|---|---|
| Claude Opus 4.6 | 52.9 | 1.06 | 70.8 |
| GPT-5.2 (xhigh) | 51.7 | 1.21 | 58.3 |
| Claude Sonnet 4.5 | 47.1 | 1.69 | 60.4 |
| Gemini 3 Pro | 46.7 | 2.04 | 58.3 |
| Claude Opus 4.5 | 43.8 | 0.93 | 58.3 |
| GLM-5 | 42.1 | 1.21 | 50.0 |
| GLM-4.7 | 41.3 | 2.12 | 56.3 |
| Kimi K2.5 | 37.9 | 1.21 | 50.0 |
Table 9. SWE-rebench(2026년 1월) 결과. 오픈소스 중에서는 가장 높지만, SWE-bench Verified(77.8)에 비하면 상용 모델과의 격차가 더 크게 보인다.
Real-world General Abilities
실제 서비스에서 자주 쓰이는 5개 능력(기계 번역, 다국어 대화, 지시 따르기, 세계 지식, 도구 호출)을 내부/외부, 사람/자동 평가를 섞어서 GLM-4.7과 비교했다.
- 기계 번역: ZMultiTransBench(중국어 → 7개 언어, 1,220개), MENT-SNS(슬랭, 언어유희, 시 등 753개)
- 다국어 대화: LMArena Elo, ZMultiDialBench(141개, 사람이 1~10점 평가)
- 지시 따르기: IF-Badcase(실제 사용자 실패 사례 450개), IFBench, MultiChallenge
- 세계 지식: SimpleQA, Chinese SimpleQA
- 도구 호출: ToolCall-Badcase(실제 실패 사례 200개)
모든 영역에서 GLM-5가 GLM-4.7보다 일관되게 향상됨
정리
- 모델: 744B(활성 40B) MoE, MLA + Muon Split, 파라미터 공유 MTP, DSA continued pre-training으로 long-context 비용 절감
- 데이터: 28.5T 토큰, mid-training에서 200K까지 컨텍스트 확장
- Post-training: SFT → Reasoning RL → Agentic RL → General RL을 순차로 진행하고, On-Policy Cross-Stage Distillation으로 능력 저하 복구
- Agentic RL: 완전 비동기 RL 인프라 + TITO + Direct Double-sided IS로 off-policy 문제 완화, 1만 개 이상의 검증 가능한 SWE 환경
- 배포: 7개 중국 칩 플랫폼에 풀스택 적응, Ascend 단일 노드에서 W4A8 양자화로 서빙
- 결과: 오픈소스 모델 중 SOTA, 여러 에이전트/코딩 벤치마크에서 Claude Opus 4.5와 비슷한 수준. 다만 end-to-end 과제 완성(ISR)과 연쇄 과제(Chained Tasks)에서는 아직 격차가 있음
댓글남기기